Poem2image
收藏资源简介:
Poem2Image 是一个多模态数据集,旨在通过结构化的语义和风格条件研究从诗歌提示生成图像。每个样本包含一个源自诗歌的提示以及多个生成的图像变体,代表语义、情感、文化、流派和性别条件的视觉解释。该数据集引入了一个多阶段生成流程,支持直接基于提示的图像生成与结构化多模态融合之间的比较。数据集包含文本列(如原始诗歌文本、语义解释、情感焦点文本条件等)和图像列(如语义视觉表示、情感基础图像等),所有图像列均使用Hugging Face的Image特征。该数据集适用于多模态学习、文本到图像扩散模型、诗歌条件图像生成等领域的研究和实验,但不适用于现实世界的文化或性别分析。数据集由Vikram Balai(IIT Patna)策划,采用MIT许可证。
Poem2Image is a multimodal dataset aimed at investigating image generation from poetic prompts through structured semantic and stylistic conditioning. Each sample consists of a prompt derived from poetry and several generated image variants, which serve as visual interpretations conditioned on semantics, emotion, culture, genre, and gender. This dataset proposes a multi-stage generation pipeline that enables comparisons between direct prompt-based image generation and structured multimodal fusion. The dataset comprises text columns (e.g., original poetic text, semantic interpretations, text conditions for emotional focus, etc.) and image columns (e.g., semantic visual representations, emotion-grounded images, etc.), with all image columns utilizing Hugging Face Image features. This dataset is applicable to research and experiments in fields such as multimodal learning, text-to-image diffusion models, and poetry-conditioned image generation, but is not intended for real-world cultural or gender analysis. Curated by Vikram Balai (IIT Patna), this dataset is licensed under the MIT License.
Dataset Card for Poem2Image
数据集详情
数据集描述
Poem2Image 是一个多模态数据集,旨在通过结构化的语义和风格条件,研究从诗歌提示生成图像。每个样本包含一个源自诗歌的提示以及多个生成的图像变体,这些变体代表了语义、情感、文化、流派和性别条件化的视觉解释。
该数据集引入了一个多阶段生成流程,使得基于直接提示的图像生成与结构化多模态融合生成之间可以进行比较。
- 策划者: Vikram Balai — IIT Patna
- 语言(NLP): 英语
- 许可证: MIT
数据集来源
- 仓库: Hugging Face Dataset Hub
- 论文: (待添加)
用途
直接用途
该数据集旨在用于以下领域的研究和实验:
- 多模态学习
- 文本到图像扩散模型
- 诗歌条件化图像生成
- 图像奖励和美学评估
- 受控生成建模
典型用例包括对多模态融合策略进行基准测试,以及研究扩散流程中的风格条件化。
超出范围的用途
该数据集不适用于:
- 现实世界的文化或性别分析
- 事实陈述或社会推断
- 安全关键的视觉应用
图像是合成输出,可能包含艺术或风格上的偏见。
数据集结构
每个条目包含文本条件字段和相应的生成图像。
文本列
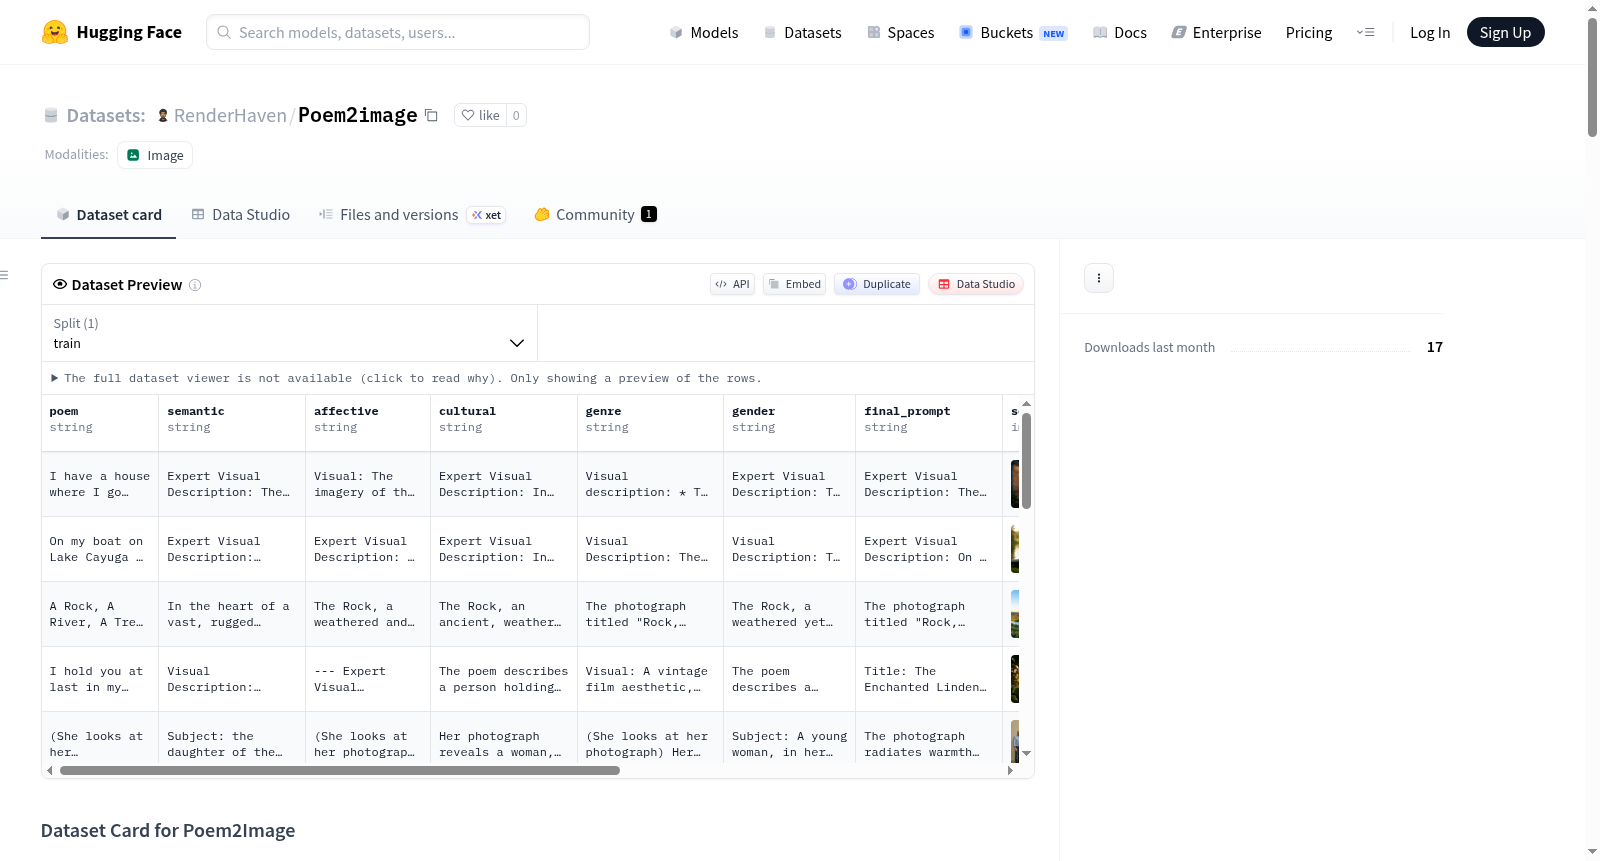
poem— 原始诗歌文本。semantic— 从诗歌中衍生的语义解释。affective— 以情感为重点的文本条件。cultural— 文化背景提示。genre— 基于流派的风格提示。gender— 受性别影响的提示。final_prompt— 用于最终图像生成的统一提示。
图像列
所有图像列均使用 Hugging Face 的 Image 特征。
semantic_img— 语义视觉表示。affective_img— 基于情感的图像。cultural_img— 文化背景图像。genre_img— 流派风格化图像。gender_img— 性别风格化图像。T1_img— 基于最终提示的基线生成图像。T2_img— 使用 Flux2Merger 生成的多模态融合输出图像。T3_img— 基于最终提示的直接生成图像。
早期 CSV 版本中的原始文件路径已被替换为嵌入式图像数据,以确保可移植性。
数据集创建
策划理由
创建该数据集是为了探索用于诗歌图像生成的结构化多模态条件化。传统的文本到图像流程仅依赖于提示,而该数据集引入了中间的语义和风格信号,以评估基于融合的生成。
源数据
数据收集与处理
- 诗歌被转换为结构化的文本提示。
- 为语义、情感、文化、流派和性别方面创建了独立的提示。
- 为每个条件化信号生成了图像。
- 融合模型(Flux2Merger)结合视觉信号以产生 T2 输出。
- 根据最终提示直接生成 T3 输出。
在创建过程中使用了基于扩散的生成模型。
源数据生产者是谁?
诗歌文本提示由数据集作者策划,并通过生成流程进行处理。
标注
标注过程
该数据集不包含手动标注。所有条件化信号和图像都是通过提示工程和基于模型的合成算法生成的。
标注者是谁?
未使用人工标注流程。
个人和敏感信息
该数据集不故意包含个人或私人数据。所有图像都是从文本提示合成的。
偏见、风险与局限性
- 生成的图像可能继承底层扩散模型的偏见。
- 文化和性别信号是合成的解释,不应被视为事实陈述。
- 视觉输出优先考虑艺术探索,而非现实主义或中立性。
建议
用户应批判性地评估输出,并在使用此数据集训练或对模型进行基准测试时考虑潜在的偏见。
引用
BibTeX:
@dataset{poem2image, title={Poem2Image: Multimodal Poetic Image Generation Dataset}, author={Balai, Vikram}, year={2026}, publisher={Hugging Face} }
术语表
- T1 — 基于提示的基线生成。
- T2 — 多模态融合结果。
- T3 — 基于精炼提示的直接生成。
- Flux2Merger — 用于合并多模态图像信号的自定义融合流程。
更多信息
该数据集是正在进行的关于多模态生成系统和用于艺术图像合成的结构化条件化研究的一部分。
数据集卡片作者
Vikram Balai — IIT Patna
数据集卡片联系方式
邮箱 vikrambalai1002@gmail.com
Github https://github.com/RenderHaven