ontology-ontomathpro
收藏资源简介:
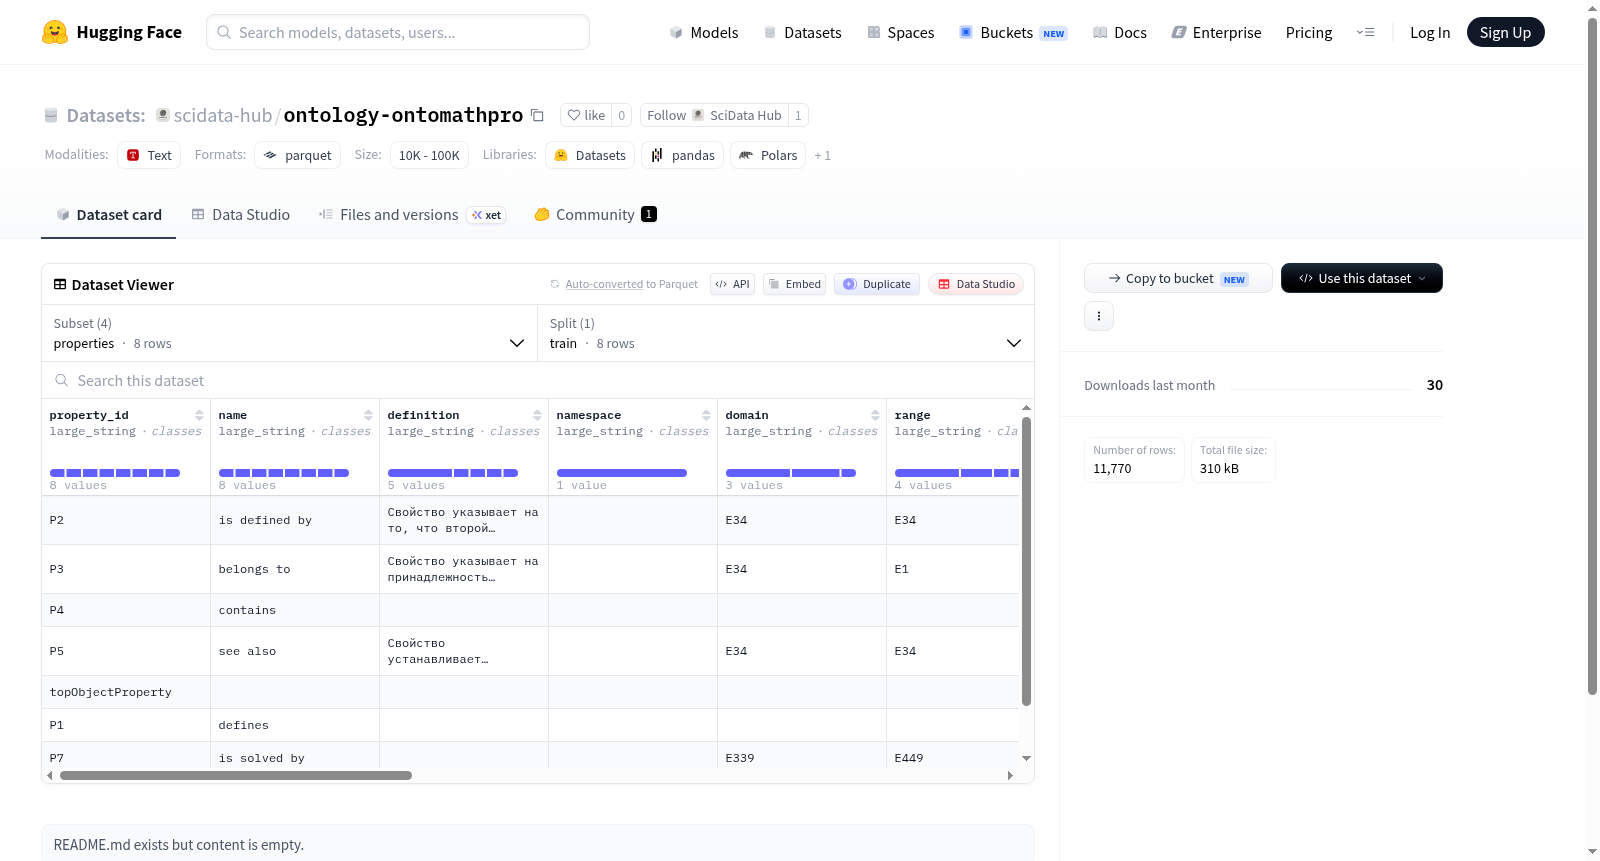
该数据集是一个生物医学本体数据集,包含四个子配置:properties(属性)、relationships(关系)、synonyms(同义词)和terms(术语)。properties配置记录了本体中属性的详细信息,包括属性ID、名称、定义、命名空间、定义域(domain)、值域(range)、传递性、对称性、自反性、反自反性、函数性、逆函数性、逆属性、父属性ID、交叉引用以及所属本体,共8个样本。relationships配置描述了本体中实体之间的三元组关系(主语、谓语、宾语),共4584个样本。synonyms配置记录了术语的同义词及其作用域(scope)和所属本体,共3729个样本。terms配置包含了本体的术语信息,包括术语ID、名称、定义、命名空间、所属本体、是否过时以及父术语ID,共3449个样本。所有配置均包含ontology字段以标识本体来源。该数据集适用于本体构建、知识图谱推理、语义关系分析、术语标准化等任务。
This dataset is a biomedical ontology dataset, containing four sub-configurations: properties, relationships, synonyms, and terms. The properties configuration records detailed information about ontology attributes, including attribute ID, name, definition, namespace, domain, range, transitivity, symmetry, reflexivity, irreflexivity, functionality, inverse functionality, inverse attribute, parent attribute ID, cross-references, and source ontology, with 8 samples. The relationships configuration describes triple relationships (subject, predicate, object) between entities in the ontology, with 4584 samples. The synonyms configuration records term synonyms along with their scope and source ontology, with 3729 samples. The terms configuration contains term information including term ID, name, definition, namespace, source ontology, whether obsolete, and parent term ID, with 3449 samples. All configurations include an ontology field to identify the source ontology. The dataset is suitable for tasks such as ontology construction, knowledge graph reasoning, semantic relationship analysis, and term standardization.
数据集概述:ontology-ontomathpro
该数据集来自 scidata-hub,旨在以结构化的形式呈现 OntoMathPro 数学本体论的内容,共包含四种配置,每种配置对应一个数据子集,覆盖本体论中的术语、属性、关系及同义词信息。
数据集结构
数据集包含以下四个配置(config):
| 配置名称 | 样本数量 | 数据大小(字节) | 下载大小(字节) | 功能描述 |
|---|---|---|---|---|
| properties | 8 | 1,569 | 7,654 | 本体论中的属性信息 |
| relationships | 4,584 | 255,361 | 33,849 | 本体论中实体间的关系 |
| synonyms | 3,729 | 353,264 | 94,297 | 本体论中术语的同义词 |
| terms | 3,449 | 668,117 | 169,044 | 本体论中的核心术语 |
所有配置均仅包含一个 train 拆分,总共约 11,770 条样本。
各配置字段说明
properties(属性)
该配置描述了本体论中定义的属性,包含以下字段:
property_id:属性的唯一标识符name:属性名称definition:属性的定义namespace:属性所属的命名空间domain:属性的定义域range:属性的值域is_transitive:是否为传递属性(布尔值)is_symmetric:是否为对称属性(布尔值)is_reflexive:是否为自反属性(布尔值)is_antisymmetric:是否为反对称属性(布尔值)is_functional:是否为函数属性(布尔值)is_inverse_functional:是否为反函数属性(布尔值)inverse_of:该属性的逆属性parent_property_ids:父属性 ID 列表xrefs:交叉引用信息ontology:所属本体论标识
relationships(关系)
该配置描述了本体论中实体间的关系,包含以下字段:
subject_id:主体实体 IDpredicate:谓词(关系类型)object_id:客体实体 IDontology:所属本体论标识
synonyms(同义词)
该配置提供了本体论中术语的同义词信息,包含以下字段:
term_id:术语 IDsynonym:同义词文本scope:同义词使用范围ontology:所属本体论标识
terms(术语)
该配置包含本体论中的核心术语定义,包含以下字段:
term_id:术语唯一标识符name:术语名称definition:术语定义namespace:术语所属命名空间ontology:所属本体论标识is_obsolete:术语是否已废弃(布尔值)parent_ids:父术语 ID 列表
数据文件
所有配置的数据文件均存放于各自的子目录中,文件名以 train-* 形式命名,分别位于 properties/、relationships/、synonyms/ 和 terms/ 目录下。