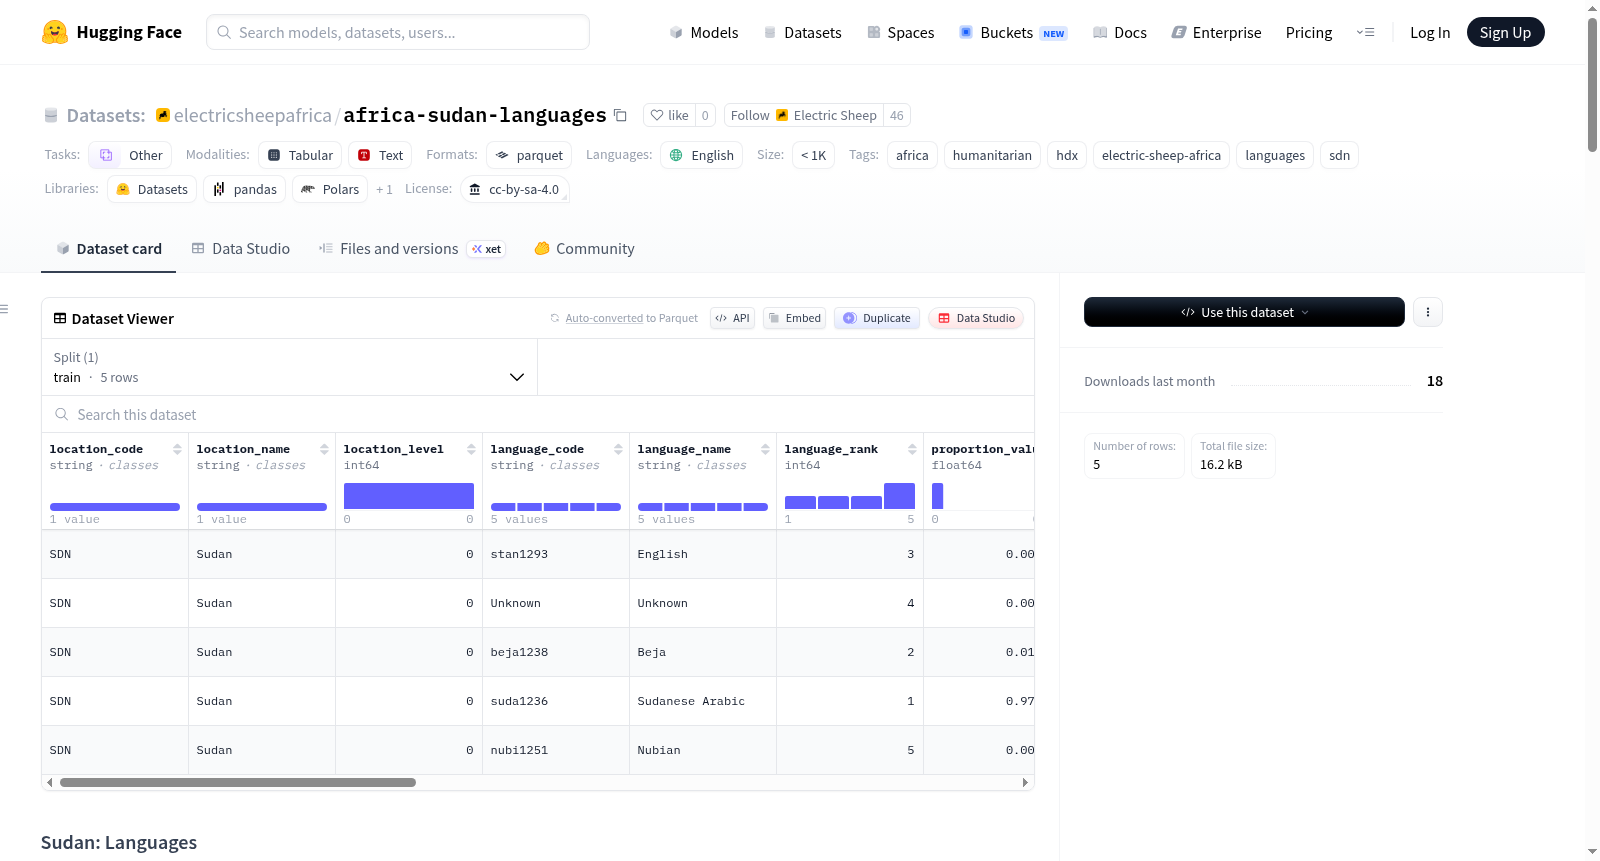
africa-sudan-languages
收藏资源简介:
该数据集名为“苏丹:语言”,由CLEAR Global(原Translators without Borders)发布,数据来源于AfroBarometer并通过HDX平台获取。数据集包含苏丹家庭主要使用语言的人口比例时间序列观测数据,共5行16列(4个数值型、10个类别型、2个日期时间型),分为4个训练样本和1个测试样本。数据涵盖地理编码(如location_code)、时间信息(如datetime_published)、人口统计(如language_name, language_rank)和测量指标(如proportion_value)等多个维度。数据集经过Electric Sheep Africa处理,转换为Parquet格式并进行了标准化清洗,适用于人口统计和语言使用模式分析等任务。需要注意的是,数据未经独立验证且可能存在原始收集偏差。
This dataset is named "Sudan: Languages" and published by CLEAR Global (formerly Translators without Borders). Data was sourced from AfroBarometer and obtained via the HDX platform. It contains time-series observational data on the proportion of the population using dominant household languages in Sudan, with a total of 5 rows and 16 columns including 4 numeric columns, 10 categorical columns, and 2 datetime columns. The dataset is split into 4 training samples and 1 test sample. The data covers multiple dimensions such as geocoding (e.g., location_code), temporal information (e.g., datetime_published), demographic attributes (e.g., language_name, language_rank), and measurement indicators (e.g., proportion_value). Processed by Electric Sheep Africa, the dataset was converted to Parquet format, standardized and cleaned, making it suitable for tasks including demographic analysis and language usage pattern research. Notably, the data has not been independently verified and may contain biases from the original data collection process.
数据集概述:Sudan: Languages
基本信息
- 数据集名称:Sudan: Languages
- 发布者:CLEAR Global (前身为 Translators without Borders)
- 原始来源:HDX (https://data.humdata.org/dataset/sudan-languages)
- 数据提供者:AfroBarometer
- 许可证:cc-by-sa-4.0
- 语言:英语 (en)
- 多语言性:单语种
- 数据规模:n<1K
- 注释创建者:无注释
- 语言创建者:发现
- 任务类别:其他
- 标签:africa, humanitarian, hdx, electric-sheep-africa, languages, sdn
- 最后更新日期:2026-04-08
- ML格式处理方:Electric Sheep Africa (https://huggingface.co/electricsheepafrica)
数据集特征
- 领域:人口统计学与人口
- 观察单位:时间序列观测值
- 总行数:5
- 列数:16 (4个数值型,10个分类型,2个日期时间型)
- 训练集拆分:4行
- 测试集拆分:1行
- 地理范围:SDN (苏丹)
数据内容摘要
该数据集包含苏丹家庭主要使用语言的人口比例数据。数据来自AfroBarometer。每一行代表一个时间序列观测值。时间覆盖范围由 datetime_published 和 date_creation 列表示。
变量(列)说明
- 地理相关:
location_code(SDN),location_name(Sudan),location_level(范围 0.0–0.0),reliability_score(范围 0.5634–0.5634),representivity_rating(moderate)。 - 时间相关:
datetime_published,date_creation。 - 人口统计相关:
language_code(例如 stan1293, Unknown, beja1238),language_name(例如 English, Unknown, Beja),language_rank(范围 1.0–5.0)。 - 结果/测量值:
proportion_value(范围 0.0026–0.9789)。 - 标识符/元数据:
dataset_name(Sudan Round 9 data (2022)),source(AfroBarometer),esa_source(HDX),esa_processed(2026-04-08)。 - 其他:
url(指向原始数据文件的链接)。
数据模式与统计摘要
- 所有列的空值百分比:0.0%。
- 数值列统计摘要:
location_level: 最小值 0.0,最大值 0.0,平均值 0.0,中位数 0.0。language_rank: 最小值 1.0,最大值 5.0,平均值 3.0,中位数 3.0。proportion_value: 最小值 0.0026,最大值 0.9789,平均值 0.2,中位数 0.0049。reliability_score: 最小值 0.5634,最大值 0.5634,平均值 0.5634,中位数 0.5634。
数据预处理与局限性
- 预处理流程:原始数据通过CKAN API从HDX下载并转换为Parquet格式。列名被转换为小写蛇形命名。常见的缺失值标记被统一为
NaN。基于解析成功率(>85%阈值),2个列从字符串类型转换为数值或日期时间类型。数据集使用固定的随机种子(42)按80/20的比例拆分为训练集和测试集,并保存为Snappy压缩的Parquet文件。 - 局限性:
- 数据源自CLEAR Global,未经ESA独立验证。
- 自动清洗无法纠正原始收集中误报的值、定义不一致或抽样偏差。
- 建议参考原始HDX数据集页面以了解发布者自身的方法说明和注意事项。
使用方式
python from datasets import load_dataset ds = load_dataset("electricsheepafrica/africa-sudan-languages")
引用格式
bibtex @dataset{hdx_africa_sudan_languages, title = {Sudan: Languages}, author = {CLEAR Global (previously Translators without Borders)}, year = {2026}, url = {https://data.humdata.org/dataset/sudan-languages}, note = {Repackaged for machine learning by Electric Sheep Africa (https://huggingface.co/electricsheepafrica)} }