
Open Greek Corpus
收藏官方服务:
资源简介:
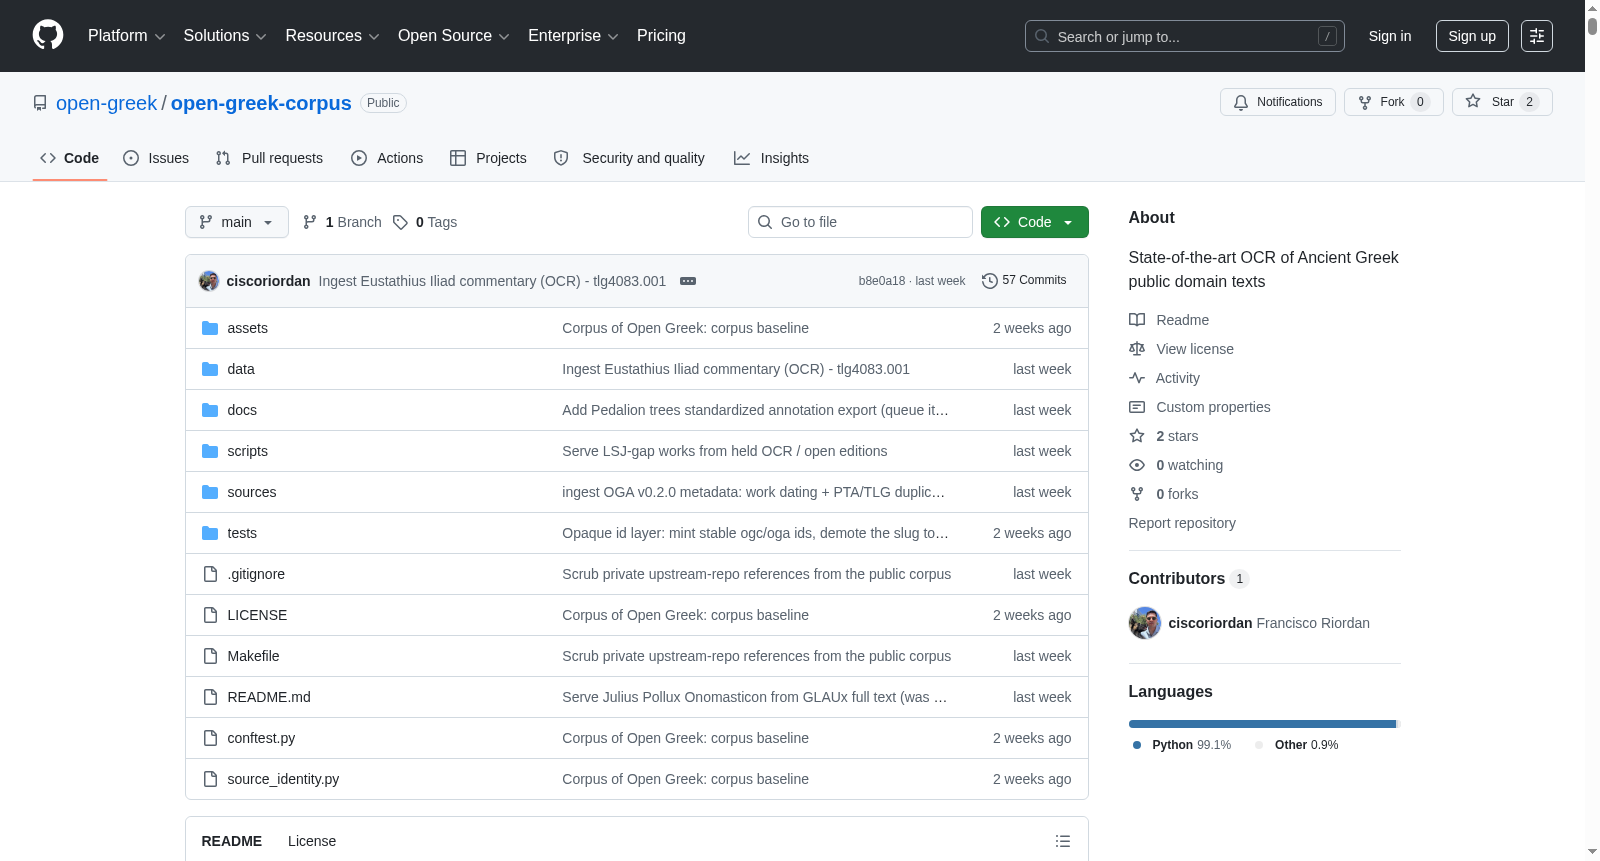
一个开放的古希腊语料库:包含现有开放许可的数字版本,以及我们对公共领域版本的OCR处理。目标是提供一个免费替代订阅语料库,涵盖所有古希腊作品。
An open Ancient Greek corpus, which includes existing digitized versions under open licenses and our OCR-processed public-domain editions. It aims to provide a free alternative to subscription-based corpora covering all Ancient Greek works.
创建时间:
2026-06-29
原始信息汇总
数据集概述:Open Greek Corpus
目标与范围
- 核心目标:构建一个开放、免费的古希腊语语料库,与需要订阅的专有语料库(如 TLG)形成对照,尽可能收录所有现存古希腊语作品。
- 时间跨度:覆盖从荷马时代到拜占庭文学希腊语时期(Homer through Byzantine literary Greek)。
- 伴随语料库:byzantine-early-modern-corpus 专门处理拜占庭和早期现代通俗希腊语。
数据来源与许可证
语料库文本来源于多个开放许可项目,具体如下:
| 来源项目 | 许可证 | 角色与内容 |
|---|---|---|
| First1KGreek | CC BY-SA 4.0 | 第一千年希腊语 TEI 版本 |
| Perseus canonical-greekLit | CC BY-SA 4.0 | 古典经典作品 TEI 版本 |
| Galenus Verbatim | CC BY-SA 4.0 | 盖伦(及伪盖伦)TEI 版本(索邦大学,经过验证的 Kuehn 转录本及修订的 First1K 文件) |
| 拜占庭及早期现代文本 | PD / CC BY-SA | 12-17 世纪晚期通俗韵文/散文(byzantine_vernacular) |
| byzantium.gr | PD (Bonn/CSHB 版本) | 拜占庭历史学家著作,干净的带变音符号转录本(byzantium_gr) |
| calfa-co Patrologia Graeca | CC BY 4.0 | 教父文献文本(通过 CC-BY OCR 从公共领域的 Migne 版获取,cgpg) |
| PTA | CC BY-SA / CC BY(按文件) | 教父文本档案馆(BBAW),包括 Severian of Gabala 语料库在内的批判性教父 TEI 版本(pta)。排除了单一 BY-NC-SA 文件。 |
| DFHG | CC BY-SA 4.0 | Mueller 的《希腊历史残篇》第1-5卷(Berti/Leipzig 的校正转录本,dfhg),取代了 FHG OCR 版本 |
| SAWS | CC BY 4.0 | 分享古代智慧项目的原生数字版本(saws),包括 Kekaumenos、Apophthegmata et gnomae 等 |
| Greek Wikisource | 基础文本 PD;贡献者层 CC BY-SA 4.0 | 提供 Proclus、七十士译本《传道书》、Musaeus Grammaticus 等作品的转录本 |
| GLAUx | 基础文本 PD;GLAUx语料库 CC BY-SA 4.0 | 提供 Julius Pollux《辞汇编》(julius-pollux.onomasticon)的全文 |
| 自主 OCR(公共领域版本) | PD | 对公共领域扫描版 Migne PG 和古典版本进行 OCR 处理(ocr) |
| Opera Graeca Adnotata | CC BY-SA 4.0 | 仅元数据,提供每部作品的创作年代及 PTA/TLG 重复映射信息 |
- 核心原则:不包含任何非商业(CC BY-NC-SA)许可的文本。若某作品仅有 NC 许可版本,则视为空缺,并从公共领域版本中获取替代来源。
文本来源优先级
当多个开放途径覆盖同一部作品时,按以下优先级选择最终使用的文本:
| 优先级 | 最佳来源标识符 | 描述 |
|---|---|---|
| 1 | open_corpus |
开放 TEI 版本(First1KGreek / Perseus / Galenus Verbatim,CC BY-SA) |
| 2 | byzantium_gr |
公共领域版本的干净手动转录本(byzantium.gr,Bonn/CSHB) |
| 3 | migne_cgpg |
公共领域版本的 CC-BY OCR 文本(calfa-co Patrologia Graeca) |
| 4 | pd_edition |
将进行自主 OCR 的公共领域版本 |
| 5 | migne_pd |
尚未获取文本的 Migne PD 版本 |
- 特殊规则:对于相同的文本,手动转录本优先于 OCR 文本。TLG 文本仅用于离线库存和质量参考,绝不作为服务文本。
- 例外管理:通过
data/source_overrides.json文件记录每部作品的优先级例外情况;通过data/non_tei_authoritative.json文件记录不应被不完整 TEI 版本覆盖的文本。
数据构成与关键文件
- 核心数据文件:
data/corpus/<work>.jsonl文件,每条记录对应一个可引用的段落(包含文献出处与文本)。 - 元数据与索引文件:
data/work_index.json(面向读者的作品、作者、外部标识符、版本等信息连接),data/work_ids.json/data/author_ids.json(不透明、不可变的标识符账本),data/source_registry.json(来源注册信息),data/coverage.json(覆盖范围报告)。 - 词汇与频率数据:
data/public_lexicon.tsv(词形频率表),data/public_lemma_frequency.tsv(词元频率表——核心产出物)。 - 外部标识符:维护 TLG/CTS、Wikidata QID、VIAF、GND、ISNI、Trismegistos 等外部标识符的交叉引用,保存在
data/tlg_crosswalk.tsv文件中。 - 变更审计:
data/corpus_changes/目录为每一项编辑变动(来源替换、删除、重新归属)保留完整的审计线索,包括变更前后内容及证据。
身份标识与引用系统
- 身份标识模型:每部作品(Work)分配一个固定的不透明 ID(
ogc<NNNNNN>),每位作者分配一个 ID(oga<NNNNNN>)。传统的author.work别名(如homerus.ilias)降级为可解析的别名,而非主键。重新归属作者时,别名可更改,但 ID 保持不变。 - WEMI层级:外部标识符(如 TLG Canon)位于作品层(Work level),而
ogcID 位于更细的表达层(Expression level),可区分同一作品的多个版本。 - 引用:每部作品的文献出处被明确定义,存在于
data/corpus/<work>.jsonl文件中。
构建与维护脚本
项目包含一系列 Python 脚本,用于执行数据摄入、语料库构建、来源优先级判断、词形/词元频率计算、注册表生成、标识符维护、交叉引用报告等任务。所有脚本位于 scripts/ 目录下。
搜集汇总
数据集介绍
构建方式
Open Greek Corpus的构建融合了多方来源的开放许可数字文本,涵盖从荷马至拜占庭时期的古希腊语文献。其数据源包括First1KGreek、Perseus canonical-greekLit等采用CC BY-SA 4.0许可的TEI编码版本,以及来自byzantium.gr、Patrologia Graeca等公共领域文献的转录或OCR成果。构建流程通过一系列自动化脚本完成:首先从各来源摄取文本并转化为以语段(locus)为单位的JSONL格式,随后依据预设的优先级梯级筛选最优版本——开放TEI版本优先于人工转录,转录又优于OCR文本,同时通过人工审核的覆盖扫描与例外列表处理边界情况,确保每个作品在许可兼容性与文本质量之间取得平衡。最终产出的语料库由构建管线统一生成,并附带完整的数据溯源表格。
特点
该数据集的核心特点在于其对开放许可的严格恪守与细粒度的版本控制。所有文本均采用CC BY-SA 4.0或公共领域许可,明确排除非商业用途限制的素材。每部作品均赋予一个由cog铸造的不透明永久标识符(ogc工作号与oga作者号),使其在重新归属或改名时仍可保持身份可追踪性。数据沿用的优先级梯级设计确保同一作品的多源文本以最优版本呈现,并通过data/source_overrides.json记录例外情况。此外,数据集不仅包含正文,还提供了词形频率表、词元频率表、工作层面的词元矩阵等语言学资源,并配有详细的交叉引用报告与覆盖报告,便于研究者进行量化分析。
使用方法
使用者可通过data/corpus/目录下的JSONL文件直接访问每个作品的语段化文本,每条记录包含定位键与正文内容。推荐首先查阅data/work_index.json以获取完整的作品元数据,包括cog标识符、CTS/TLG外部锚点、版本来源及令牌数。对于需要标注的语料分析场景,数据集提供了标准化注解导出机制,可将注解以CTS-URN为键的令牌记录形式导出至Hugging Face数据集仓库。研究者亦可利用public_lemma_frequency.tsv等词频资源进行统计研究。标识符层支持idempotent的重新构建与重命名操作,所有变更通过corpus_changes/目录下的审计追踪记录,确保数据操作的透明性与可逆性。
背景与挑战
背景概述
Open Greek Corpus是一个开放的古希腊语语料库,由多个研究机构与个人合作创建,旨在构建一个可免费获取的古希腊文学文本集合,以替代需订阅的商业语料库。项目核心涵盖从荷马至拜占庭文学希腊语时期的海量作品,其创建时间可追溯至近年,主要依托First1KGreek、Perseus、Galenus Verbatim、Patrologia Graeca等开放许可的数字化成果,并通过OCR技术补全公版领域的缺失文本。该数据集的核心研究问题在于弥合古典学数字资源中开放获取与付费壁垒之间的鸿沟,为学者提供无限制的文本访问与再利用可能。其对相关领域的影响深远,不仅推动了数字人文学科中文本开源运动的进程,还为语言学研究、文本分析与语料库语言学提供了标准化、可验证的底层数据基础设施。
当前挑战
该领域面临的核心挑战首先在于文本完整性与准确性的平衡。尽管Open Greek Corpus整合了多个开放来源,但部分作品仅存片段性TEI版本,需借助OCR补充全文,而OCR过程极易引入拼写、断词与标点错误,尤其对于古希腊语复杂的变音符号系统,纠错成本极高。其次,数据源的异构性构成巨大挑战,不同来源采用差异化的编码标准(如TEI、CTS-URN)与许可协议(CC BY-SA、CC BY-NC-SA),需精心设计优先级规则与冲突解决机制,以避免版权风险并确保文本一致性。构建过程中,跨语料库的作品去重、作者归属校正以及元数据对齐(如TLG编号、Wikidata标识符)亦需大量人工审核与脚本自动化支持,以防数据冗余或信息丢失。
常用场景
经典使用场景
在古典语文学与数字人文学科的交汇处,Open Greek Corpus作为开放获取的古希腊语文本库,最经典的使用场景是支撑大规模语料库语言学分析与计算文本批评。研究者可藉其结构化CTS-URN引文体系与词形—词位频率表,系统考察从荷马至拜占庭文学希腊语的形态演变、句法模式与词汇分布。该语料库将分散于多个开源TEI数字版本(如First1KGreek、Perseus)及自行OCR的公有领域版本整合为统一数据管道,提供清洁、可复现的古希腊语文献基础,使语言演化规律与作者风格计量研究得以在完整语料框架内展开。
实际应用
在实际应用层面,该数据集被广泛用于古代文本的自动词法分析、词义消歧与机器翻译模型训练。其生成的公共词位频率表为希腊语学习者与词典编纂者提供了统计依据,而引文交叉映射机制则使得跨文献的引用追踪与文本对校成为可能。尤其在拜占庭历史学家与教父文献领域,研究者可基于OGA标注的时间标签,快速定位特定世纪的语言证据,支持古典哲学、早期基督教史及法律史领域的实证研究。该数据集还无缝对接Hugging Face的注释导出管道,使得下游自然语言处理任务可直接获取标准化标注数据。
衍生相关工作
围绕Open Greek Corpus已衍生出一系列关键学术成果与工具链。其中,Opera Graeca Adnotata项目利用该语料库的元数据标注框架,生成了精细到作品层面的创作年代与归属图谱。Perseus数字图书馆与First1KGreek上游版本持续利用此语料库的交叉校验结果优化自身文本质量。在计算语言学领域,研究者利用其公开词位频率表训练了古希腊语的形态分析器与词形还原模型。此外,拜占庭白话文献子语料库(byzantine-early-modern-corpus)的独立开展工作,展示了其数据架构在时间跨度上的可扩展性,启发了后续同类项目的目录标准与引文协议设计。
以上内容由遇见数据集搜集并总结生成


