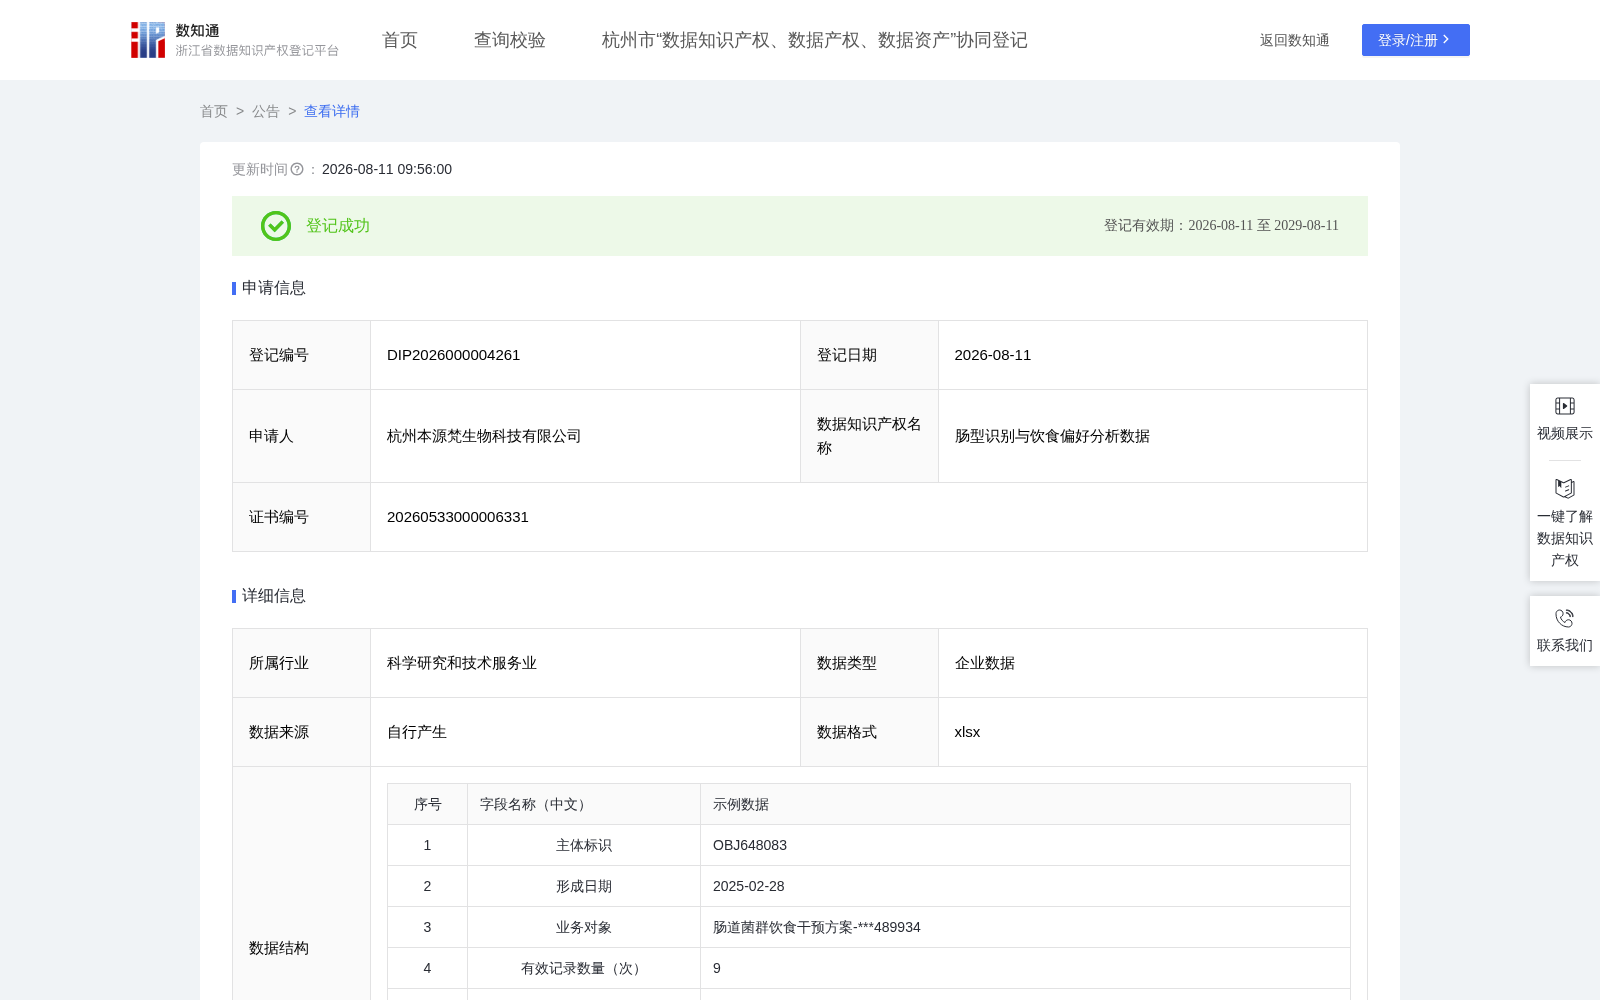
肠型识别与饮食偏好分析数据
收藏资源简介:
本数据面向肠型识别后的个性化饮食建议、营养随访和调理效果追踪场景,围绕用户当前饮食结构是否匹配肠型特征、膳食纤维摄入是否充足以及高糖饮食是否增加代谢风险等问题,整合主体标识、形成日期、业务对象、膳食纤维摄入量、目标肠型一致样本数、肠型识别有效样本数、有效记录数量、异常项数量、连续异常次数、周期统计数量和近7天高糖饮食次数等样本级数据。数据可按日、周、随访周期、肠型和饮食行为维度统计,形成目标肠型一致率、肠型匹配分、短链脂肪酸支持分、代谢风险修正分、饮食建议匹配分和结果等级。对运营管理方,可支撑营养建议制定、随访排序和调理效果复盘;对城市健康服务和行业研究,可提供膳食行为与微生态匹配趋势参考;对用户,可提升饮食建议的可理解性和执行反馈;对商业机构,可支撑营养服务包、复测计划和产品组合优化。通过把肠型检测与饮食行为数据联动,该数据推动传统泛化饮食建议向数据驱动的个性化营养管理升级。同时可为行业治理提供标准化指标口径和趋势参考。数据来源说明:数据来源于肠型识别记录/饮食偏好问卷、饮食评估记录/营养方案匹配记录。涉及样本、用户、产品、项目或风险事件的标识仅用于内部关联与校验,进入数据集时可脱敏或编码处理。 (一)评分及分层字段运算规则 饮食建议匹配分(分):肠型匹配分(分)×0.45 + 短链脂肪酸支持分(分)×0.35 + 代谢风险修正分(分)×0.20; 结果等级:评分≥85为高度匹配,70-84为较匹配,60-69为一般,<60为需调整; (二)算法字段运算规则 肠型匹配分(分):目标肠型一致率×0.75+min(20,膳食纤维摄入量×0.7)-近7天高糖饮食次数×1.5,上限100; 短链脂肪酸支持分(分):短链脂肪酸支持分(分)=100-异常项数量(项)/max(1,有效记录数量(次))×100; 代谢风险修正分(分):连续异常次数(次)=0记100分,=1记85分,=2记70分,>=3记50分; 目标肠型一致率(%):目标肠型一致样本数(个)/max(1,肠型识别有效样本数(个))×100。 最终评分占比依据:饮食建议匹配分权重为肠型匹配45%、短链脂肪酸支持35%、代谢风险修正20%。肠型一致性是个性化饮食建议主依据;短链脂肪酸体现饮食代谢效果;连续异常只作修正。