
遇见数据集

jusbrasil/indice-jusia

收藏
Hugging Face2026-06-05 更新2026-02-07 收录
官方服务:

资源简介:

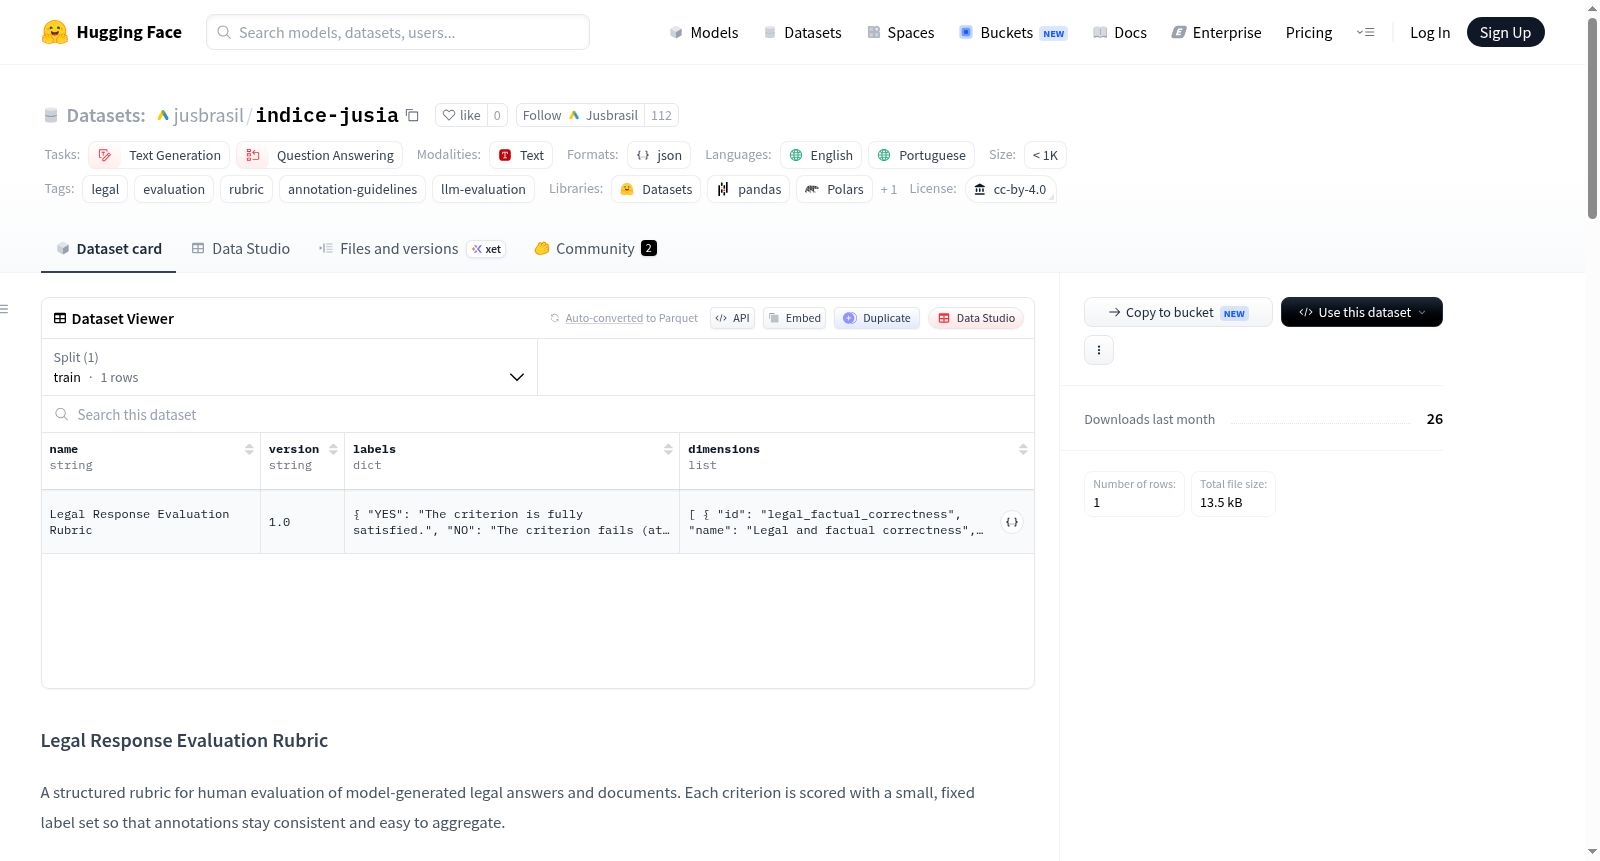
该数据集是一个用于人类评估模型生成的法律答案和文档的结构化评分标准。它包含五个维度的评估标准:法律和事实正确性(检查法律和事实错误、引用准确性、管辖权和层级正确性)、完整性(遵循用户指令和法律文档结构完整性)、可靠性(声明的可验证来源、主要/官方来源、引用支持度、近期判例)、语言流畅性(精确性和简洁性)以及自由形式的观察。每个标准使用YES、NO、N/A标签进行评分,以确保注释的一致性和易于聚合。数据集支持英语和葡萄牙语,适用于文本生成和问答任务。

This dataset is a structured rubric for human evaluation of model-generated legal answers and documents. It includes five dimensions of evaluation criteria: legal and factual correctness (checking for legal and factual errors, citation accuracy, jurisdiction and hierarchy correctness), completeness (adherence to user instructions and structural completeness of legal documents), reliability (verifiable sources for statements, primary/official sources, citation support, recent jurisprudence), language fluency (precision and conciseness), and free-form observations. Each criterion is scored using YES, NO, N/A labels to ensure consistent and easily aggregated annotations. The dataset supports English and Portuguese languages and is suitable for text-generation and question-answering tasks.

提供机构:
jusbrasil
搜集汇总
数据集介绍
jusbrasil/indice-jusia 数据集图片
构建方式
indice-jusia数据集构建了一套结构化评估准则,用于对模型生成的法律答案与文档进行人类评价。该准则由五个维度组成:法律与事实正确性、完整性、可靠性、语言流畅性以及自由形式的观察记录。每个维度下包含若干具体标准,例如评估是否存在法律或事实错误、引用是否准确、管辖权与层级是否恰当、是否遵循用户指令、法律文书结构是否完整、法律陈述是否附带可验证来源、来源是否为主要官方渠道、引用是否充分支持论点、是否包含近五年判例,以及文本是否精确简洁。每个标准采用固定的三元标签集进行评分:YES(完全满足)、NO(存在至少一项违规)或N/A(不适用),确保了标注的一致性与可聚合性。
使用方法
使用该数据集时,标注者需针对每个模型生成的法律回答或文档,逐一应用十个评价标准进行评分。每个问题对应YES、NO或N/A标签,其中N/A仅在标准明确列出可忽略场景时使用(如未引用法律条文时对引用准确性的评估)。建议标注者在评分前仔细阅读每个标准的详细说明和示例,以确保判断的一致性。对于语言流畅性等主观性较强的标准,需严格依据文本本身的清晰度与精确度进行判断,避免引入外部知识。自由文本字段可用于补充任何有助于解释评分或提供反馈的额外信息。最终评分可汇总为各维度得分或总体合规性指标,用于比较不同模型或生成策略的表现。
背景与挑战
背景概述
在司法智能化进程中,大型语言模型(LLM)被广泛用于法律问答与文书生成,但此类输出往往缺乏系统性的质量评估标准。为此,研究者于近期推出了Legal Response Evaluation Rubric数据集,旨在为法学领域模型生成内容的评估提供结构化准则。该数据集由多语种法律评估团队构建,涵盖英语和葡萄牙语,核心研究问题聚焦于如何通过细粒度准则实现法律文本的事实正确性、完整性、可靠性及语言流畅性的量化评价。其发布为法律领域模型的可信度检验开辟了新路径,尤其对巴西及普通法系国家的司法辅助系统建设具有范式推动意义。
当前挑战
当前构建的评估准则面临双重挑战。在领域层面,法律文本复杂性要求模型同时处理事实准确性、判例引用准确性及司法层级关系等多维约束,例如模型常混淆当事人主张与法院裁决,或虚构不存在的法条,这些错误在传统文本生成评估中难以被有效捕获。在构建过程中,注释一致性的保障尤为困难:评估准则虽采用三值标签(YES/NO/N/A),但同一准则在不同法律场景下的适用边界模糊,如“近期判例”的五年时效在缺乏判例的司法领域可能不适用,导致注释者需频繁依赖自由文本观测字段补充说明,增加了标注聚合的噪声风险。
常用场景
经典使用场景
在法律人工智能的研究领域,indice-jusia数据集作为一项结构化评估框架,其核心应用在于对大型语言模型生成的司法答案与法律文件进行系统化人工评价。通过将评估维度拆解为法律与事实正确性、完整性、可靠性、语言流畅性及自由观察五大板块,该数据集为研究者提供了一套标准化、可重复的标注指南。其经典使用场景聚焦于模型输出与真实法律标准之间的对比校验,尤其在需要精确衡量生成内容是否包含法律幻觉、判例引用是否准确、管辖权与位阶是否恰当的复杂任务中,该数据集能够辅助标注者以统一的逻辑进行评分,从而确保评估结果的一致性与可聚合性。
解决学术问题
该数据集精准回应了法律文本生成领域长期存在的评估非标准化难题。在学术研究中,如何客观衡量模型输出的法律准确性、引用真实性及逻辑完整性始终缺乏共识性的度量工具。indice-jusia通过引入三档(是/否/不适用)固定标签集,系统解决了跨任务、跨语言(英文与葡萄牙语)的评估一致性瓶颈。其意义在于为比较不同模型的司法问答能力提供了可量化的基准,推动了法律NLP研究中从主观预判向结构化论证的范式转变,同时大幅降低了因评分标准模糊而导致的信度损耗,为后续构建更复杂法律评估体系奠定了方法论基础。
实际应用
在实际场景中,该数据集主要服务于司法辅助系统的质量监控与优化环节。例如,当法律科技公司利用大语言模型生成起诉状、法律意见书或判例摘要时,人工评审团队可依照indice-jusia的评分维度对模型输出进行逐项检验,识别并修正其中存在的法律事实错误、判例虚构或论证缺失等缺陷。此外,该框架亦被应用于法律教育领域,作为训练法律实习生或初级律师撰写规范文档的评估模板,通过多维度反馈促进法律文书质量的标准化提升。其实际价值体现在将抽象的法律推理能力转化为可执行的评价操作流程。
数据集最近研究
最新研究方向
当前,法律领域的大语言模型应用正面临事实准确性与可验证性的核心挑战。indice-jusia数据集通过构建包含法律事实正确性、完整性、可靠性及语言流畅性等维度的结构化评估准则,为法律文本生成与问答系统提供了细粒度的标准化标注框架。该数据集聚焦于检测模型输出的法律引用幻觉、司法层级混淆及原始来源可追溯性等关键问题,其评估体系紧密契合了近期法律AI研究中关于可解释性与责任归属的热点议题。该资源不仅推动了法律NLP从简单对话向具备专业推理与权威性验证能力的方向演进,更为构建值得信赖的司法辅助系统奠定了重要基准。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

