african_celtic_dataset
收藏资源简介:
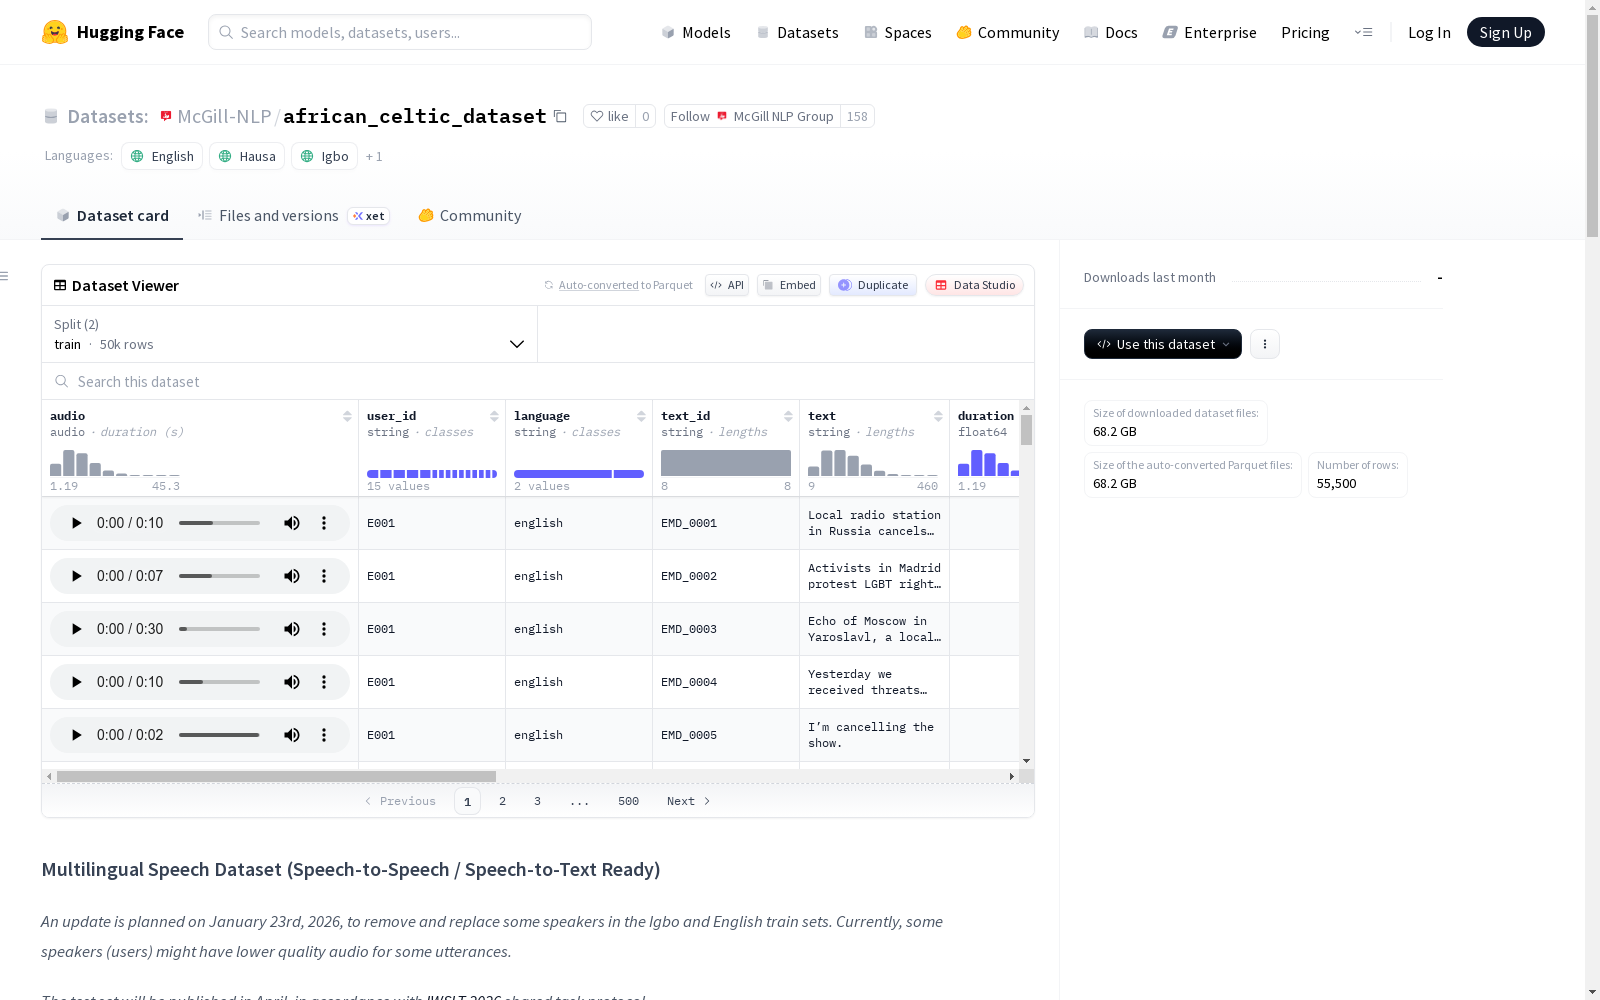
该数据集是一个大规模的多语言语音语料库,专为语音到语音翻译、语音到文本以及多语言语音处理研究而设计。数据按语言、说话者(`user_id`)和数据集分割(`train`、`dev`)组织,并包含丰富的声学和元数据注释。数据集目前包括约鲁巴语(`Y`)、伊博语(`I`)、豪萨语(`H`)和英语(`E`)的语音数据。每个样本包含音频波形、说话者标识符、语言、文本转录、音频时长、录音时间戳、原始采样率、静音比例、信噪比、语音速率、平均音量等字段。数据集主要用于语音到语音翻译、语音到文本、多语言和低资源语音建模、声学分析和语音质量研究等用途,但不适用于说话者识别或验证、监视或生物特征分析等场景。
This dataset is a large-scale multilingual speech corpus tailored for research on speech-to-speech translation, speech-to-text, and multilingual speech processing. Data is organized by language, speaker (`user_id`), and dataset splits (`train`, `dev`), and includes rich acoustic and metadata annotations. Currently, the dataset contains speech data in four languages: Yoruba (`Y`), Igbo (`I`), Hausa (`H`), and English (`E`). Each sample includes fields such as audio waveform, speaker identifier, language, text transcription, audio duration, recording timestamp, original sampling rate, silence ratio, signal-to-noise ratio (SNR), speech rate, and average volume. This dataset is primarily intended for applications including speech-to-speech translation, speech-to-text, multilingual and low-resource speech modeling, acoustic analysis, and speech quality research, but is not suitable for speaker identification or verification, surveillance, or biometric analysis scenarios.
数据集概述
数据集基本信息
- 数据集名称: Multilingual Speech Dataset (Speech-to-Speech / Speech-to-Text Ready)
- 发布与维护方: McGill NLP
- 数据集地址: https://huggingface.co/datasets/McGill-NLP/african_celtic_dataset
- 许可证: Creative Commons Attribution 4.0 International (CC BY 4.0)
数据集简介
这是一个大规模多语言语音语料库,专为语音到语音翻译、语音到文本以及多语言语音处理研究而构建。数据按语言、说话人和数据集划分进行组织,并包含丰富的声学和元数据标注。
语言覆盖
数据集当前包含以下语言的语音数据:
- 约鲁巴语 (
Y) - 伊博语 (
I) - 豪萨语 (
H) - 英语 (
E) 未来版本可能会添加更多语言。
数据集结构与规模
数据划分
数据集在Hugging Face上以扁平化的DatasetDict形式提供,包含以下划分:
- 训练集 (
train) - 开发集 (
dev)
数据规模
- 训练集: 50,000 个样本,55,063,053,858 字节
- 开发集: 5,500 个样本,4,426,059,782 字节
- 总下载大小: 68,204,745,286 字节
- 总数据集大小: 59,489,113,640 字节
数据字段说明
每个样本包含以下字段:
| 字段名 | 类型 | 描述 |
|---|---|---|
audio |
音频 (48 kHz) | 语音波形 |
user_id |
字符串 | 说话人标识符 |
language |
字符串 | 话语的语言 |
text_id |
字符串 | 所读文本的标识符 |
text |
字符串 | 参考转录文本 |
duration |
浮点数 | 音频时长(秒) |
recorded_at |
字符串 | 录音时间戳或会话信息 |
original_sample_rate |
整数 | 重采样前的原始采样率 |
silence_ratio |
浮点数 | 静音帧比例 |
snr_db |
浮点数 | 信噪比 (dB) |
speech_rate |
浮点数 | 估计的语速 |
volume_db |
浮点数 | 平均音量 (dB) |
split |
字符串 | 数据集划分 (train, dev) |
音频规格
- 服务采样率: 48,000 Hz
- 格式: WAV
- 声道: 单声道
原始采样率保存在
original_sample_rate字段中。
预期用途
主要应用场景
- 语音到语音翻译
- 语音到文本和自动语音识别 (ASR)
- 多语言和低资源语音建模
- 声学分析和语音质量研究
- 说话人感知建模(非生物识别)
非适用范围
- 说话人识别或验证
- 监视或生物特征分析
- 未经同意的商业语音克隆
数据处理说明
- 音频在话语级别进行分割
- 通过
user_id保留说话人边界 - 声学指标自动计算
- 未应用强制对齐或音素标注
- 提供的文本仅作为参考,可能包含自然语音的变体
引用信息
若在学术或工业研究中使用此数据集,请引用: bibtex @dataset{mcgillnlp_multilingual_speech, title = {Multilingual Speech Dataset}, author = {McGill NLP}, year = {2026}, publisher = {Hugging Face}, url = {https://huggingface.co/datasets/mcgill-NLP} }
联系与维护
如有问题、疑问或贡献,请通过Hugging Face数据集仓库联系 mcgill-NLP。