
MayankMSD/synthetic-pld-benchmark
收藏官方服务:
资源简介:
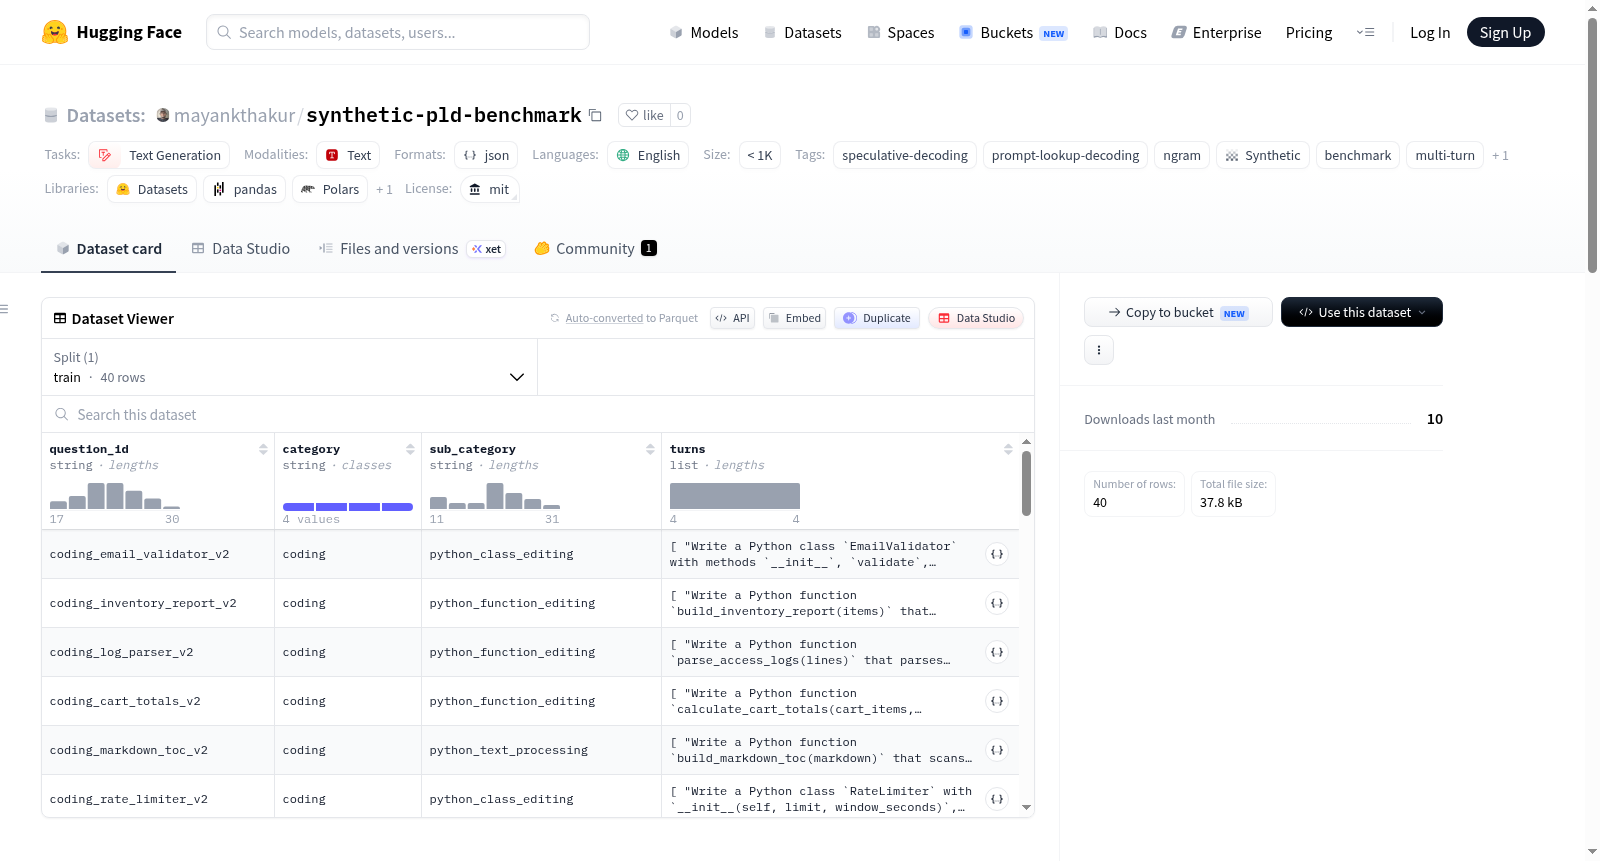
这是一个用于评估提示查找解码(PLD)、ngram-simple和ngram-mod风格推测解码的合成多轮提示数据集。每个示例都是一个编辑式工作负载:第一轮要求模型从头创建一个工件,后续轮次则要求进行小修改,同时需要模型返回完整更新后的工件。这种结构旨在暴露重复的令牌轨迹,使其适用于评估基于n-gram的推测解码策略。
Synthetic multi-turn prompt dataset for evaluating prompt-lookup decoding (PLD), `ngram-simple`, and `ngram-mod` style speculative decoding. Each example is an edit-style workload. The first turn asks the model to create an artifact from scratch. Later turns ask for small modifications while requiring the model to return the full updated artifact. This structure is designed to expose repeated token trajectories, making it useful for evaluating n-gram based speculative decoding strategies.
提供机构:
MayankMSD搜集汇总
数据集介绍
构建方式
该数据集以多轮编辑型任务为核心构建方式,精心设计了从零创建到逐步修改的工作流。每个样本包含初始的完整生成请求,以及后续要求模型返回完整更新内容的小幅修改指令,从而在输入序列中刻意制造大量重复的词元轨迹。数据集通过分类标签(如编码、写作、问答、数学)和子类别(如函数编辑)实现任务细化,并以JSON格式存储每个样本的问答标识、类别、多轮对话列表及是否多轮的布尔标记,确保了结构的标准化与可扩展性。
使用方法
使用者可通过Hugging Face的datasets库轻松加载该数据集,指定训练集划分后即可获得结构化的多轮对话样本。推荐采用JSONL格式存储数据,每行包含一个完整的JSON对象,便于流式读取和批量处理。在应用时,研究人员可针对每个样本的多轮对话序列,依次评估模型在不同编辑轮次中的输出效率与词元匹配度,尤其适合对比提示查找解码与不同n-gram变体在重复轨迹上的加速效果。该数据集不建议用于通用推理任务,而是专为编辑型多轮生成的投机解码基准测试而设计。
背景与挑战
背景概述
该数据集由开发者MayankMSD于近期创建,旨在服务于推测解码领域中的提示查找解码(Prompt-Lookup Decoding)及其衍生方法(如ngram-simple与ngram-mod)的性能评估。在大型语言模型推理加速的研究中,推测解码通过利用生成历史中的重复令牌轨迹来减少计算开销,而多轮交互场景下的令牌复用特性尤为关键。该数据集聚焦于编辑式多轮任务,包含编程、写作、问答与数学四大类别,通过模拟从零构建到逐轮修改的典型工作负载,为评估n-gram推测解码策略提供了高度匹配的标准化测试基准。其结构设计使得重复令牌模式自然暴露,从而精准衡量解码方法在重复输出场景下的效率提升,填补了该领域专用轻量级基准的空白。
当前挑战
当前数据集面临的核心挑战在于领域问题的复杂性:推测解码方法的效能高度依赖于令牌重复模式的频率和结构,而编辑式多轮任务虽能暴露重复轨迹,却无法覆盖其他类型的文本生成模式(如创造性写作或长链推理),导致评估结果可能偏离实际应用场景。构建过程中的挑战则体现在数据平衡上:不同类别(编程、写作、QA、数学)的任务难度和重复模式分布差异显著,如何确保各子类别在令牌复用特征上具有可比性和代表性,避免因数据偏斜导致的解码方法排名失真,是维护基准有效性的关键瓶颈。此外,数据规模较小(少于1000条样本)限制了统计显著性,需定期扩展以应对推测解码技术的迭代需求。
常用场景
经典使用场景
该数据集专为评估推测解码(speculative decoding)方法中基于n-gram的检索策略而设计,尤其侧重于多轮编辑类工作负载。其经典使用场景包括:在代码编辑、文本修订等需重复生成相似序列的任务中,测量prompt-lookup decoding、ngram-simple及ngram-mod等解码技术的效率与准确性。通过模拟用户逐步修改已有内容的多轮交互,数据集暴露了重复token轨迹的潜在模式,为量化令牌重用率、解码延迟缩减及生成质量保持提供了可控的测试平台。
解决学术问题
该数据集系统性地解决了多轮生成场景下重复token检测与重用效果难以量化评估的难题。在学术研究中,它填补了缺乏专门针对逐步编辑式工作负载的推测解码基准的空缺,使得研究者能脱离通用问答或单轮推理任务的局限,聚焦于解码策略在部分重叠输出中的token轨迹复用行为。其意义在于为改进n-gram缓存机制、减少冗余计算提供了标准化的验证工具,推动了低延迟、高吞吐的生成式模型推断优化方向的研究进展。
实际应用
在实际应用中,该数据集可支撑智能代码补全工具(如集成开发环境中的实时辅助)的性能调优,帮助开发者减少因频繁修改代码片段带来的重复生成开销。此外,在对话式人工智能的编辑助手领域,如文档修订或创意写作辅助中,数据集所评测的解码技术能有效降低长文本返回的等待时间,提升用户交互的流畅度。同时,它还为边缘设备上的轻量级模型部署提供了资源受限环境下的解码策略选择依据。
数据集最近研究
最新研究方向
随着大规模语言模型在代码生成、文档撰写等场景中的广泛应用,推理效率成为制约其落地的关键瓶颈。该数据集聚焦于投机解码领域的前沿方向,特别是基于提示查找和n-gram匹配的轻量级解码策略,通过构造多轮编辑型工作负载,模拟重复的令牌轨迹,为评估模型在历史复用场景下的生成加速效果提供了高针对性的基准。其设计呼应了近年来业界对低延迟、高吞吐量推理的热切追求,例如在实时编码助手和对话式AI中减少重复计算的开销。这一工具的出现,有助于推动从理论到实用解码算法的转化,并可能引导未来模型在架构与解码器的协同优化上向更高效的方向演进。
以上内容由遇见数据集搜集并总结生成
相关数据集

暂无相关数据集


