
遇见数据集

ghananlpcommunity/ghana-english-tts-clean2

收藏
Hugging Face2026-07-14 更新2026-07-22 收录
官方服务:

资源简介:

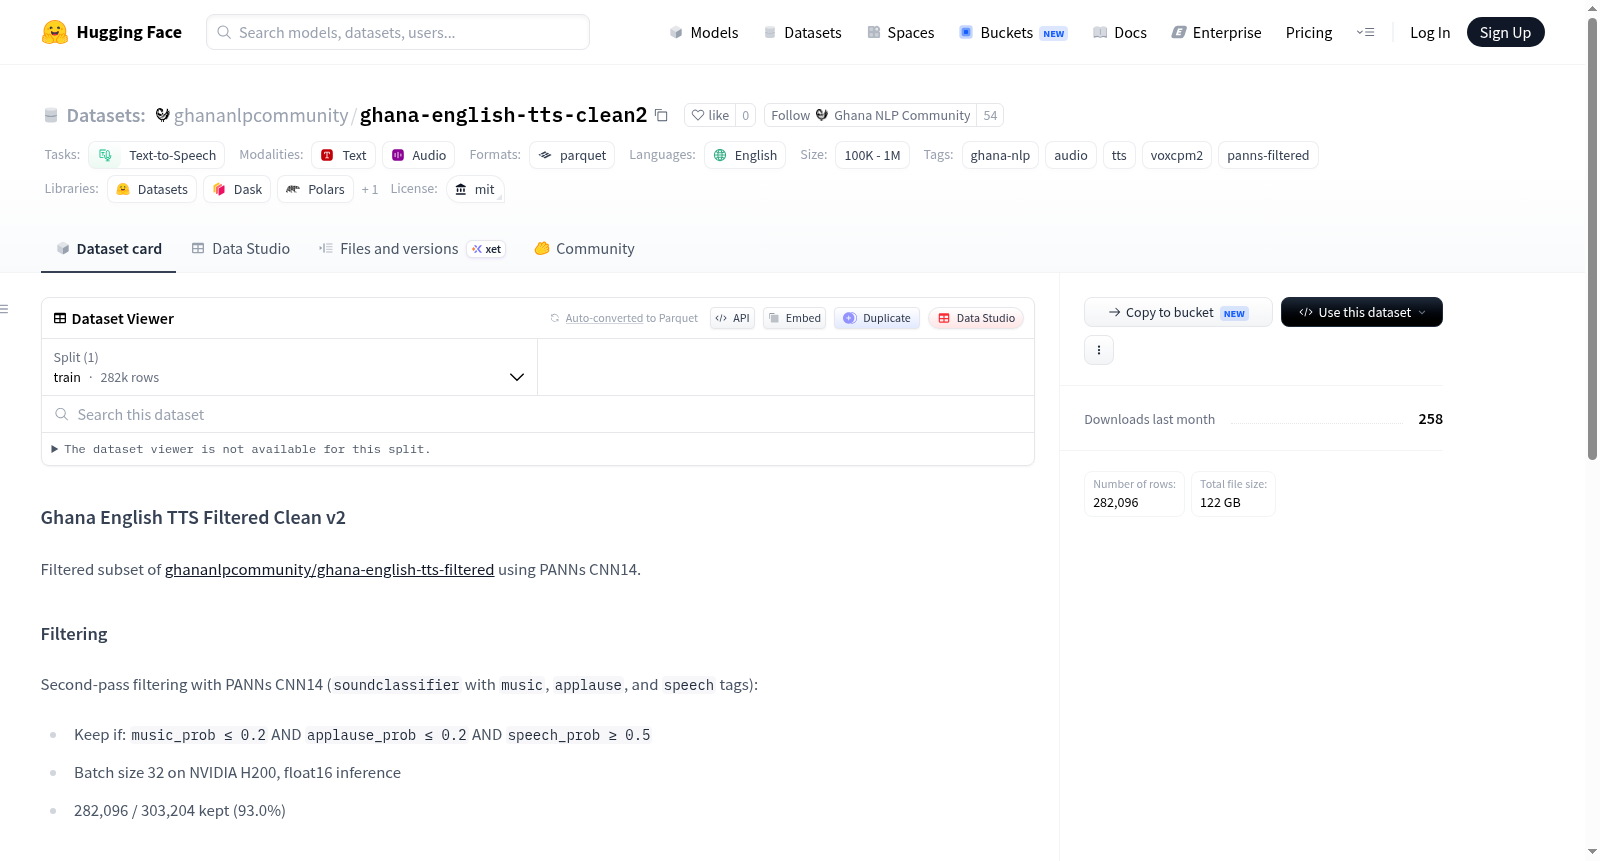
Ghana English TTS Filtered Clean v2 是一个文本到语音(TTS)数据集,专门针对加纳口音的英语。该数据集是基于 ghananlpcommunity/ghana-english-tts-filtered 数据集的过滤子集,使用 PANNs CNN14 模型进行二次过滤处理。过滤条件包括:音乐概率 ≤ 0.2、掌声概率 ≤ 0.2 且语音概率 ≥ 0.5,以确保音频质量。数据集包含 282,096 个音频片段,每个片段包含 corrected_text(校正后的文本)和 bytes(原始 WAV 字节,16 位 PCM 单声道,原始采样率)字段。该数据集主要用于预计算 VoxCPM2 AudioVAE V2 的潜在表示,以用于加纳口音英语 TTS 的微调任务。

Ghana English TTS Filtered Clean v2 is a text-to-speech (TTS) dataset specifically tailored for Ghanaian-accented English. It is a filtered subset derived from the ghananlpcommunity/ghana-english-tts-filtered dataset, which underwent secondary filtering using the PANNs CNN14 model. The filtering criteria are set as: music probability ≤ 0.2, applause probability ≤ 0.2, and speech probability ≥ 0.5, to guarantee high audio quality. The dataset comprises 282,096 audio clips, each containing the fields corrected_text (corrected text) and bytes (raw WAV bytes, 16-bit PCM mono, original sampling rate). This dataset is primarily utilized to precompute the latent representations of VoxCPM2 AudioVAE V2 for fine-tuning tasks of Ghanaian-accented English TTS.
提供机构:
ghananlpcommunity
搜集汇总
数据集介绍
ghananlpcommunity/ghana-english-tts-clean2 数据集图片
构建方式
该数据集源自 Ghana NLP 社区发布的加纳英语 TTS 原始语料库,经过两阶段精细过滤构建而成。在第一阶段已进行初步清洗的基础上,研究者采用 PANNs CNN14 声学分类模型执行第二轮筛选,依据音乐概率不高于 0.2、掌声概率不高于 0.2 且语音概率不低于 0.5 的严格阈值,对 303,204 条样本进行逐条判定,最终保留了 282,096 条高质量语音片段,留存率达 93.0%。筛选过程在 NVIDIA H200 上以 FP16 推理完成,批处理大小为 32,兼顾了效率与精度。
特点
该数据集具备显著的技术特征:首先,所有音频均为 16-bit PCM 单声道 WAV 格式,保留了原始采样率,确保了语音信号的完整性;其次,每个样本包含校正后的文本标注与对应的音频字节流,结构简洁统一;再者,数据经过声学模型的多标签概率过滤,有效剔除了含背景音乐、掌声等非纯净语音片段,极大提升了语料的语音质量;此外,数据集规模超过 28 万条,分片存储于多个 Shard 中,为进一步的模型训练提供了充实且干净的加纳口音英语语音资源。
使用方法
该数据集主要用于加纳口音英语的文本到语音合成模型微调。推荐的使用流程为:首先利用 VoxCPM2 的 AudioVAE V2 编码器对所有语音片段预计算潜在表征,以此作为模型训练的输入特征;随后基于这些预计算表征,在相应的 TTS 骨干网络(如 VITS、Tacotron 等)上进行微调。数据读取时可通过逐帧解包 WAV 字节流获取音频数组,配合 corrected_text 字段的文本标签构建训练对,适用于基于注意力机制的端到端 TTS 框架。
背景与挑战
背景概述
文本转语音(TTS)技术是自然语言处理与语音合成的交叉领域,其核心挑战在于生成自然、准确且具地域特色的语音。然而,全球多数TTS数据集以美式或英式英语为主导,忽略了其他口音与方言的多样性,导致模型在面对加纳口音英语时表现欠佳。为填补这一空白,加纳自然语言处理社区(ghananlpcommunity)于近期推出ghana-english-tts-clean2数据集,旨在为加纳口音英语TTS微调提供高质量语音数据。该数据集由研究人员基于前期版本ghana-english-tts-filtered进行二次筛选,采用PANNs CNN14模型进行精细过滤,最终保留约28.2万条高质量音频样本。作为面向低资源口音的专用数据集,它显著推动了多口音TTS研究,为非洲英语语音合成系统的实用化奠定了基础,并促进语音技术在特定文化场景下的包容性发展。
当前挑战
该数据集面临多重挑战。首先,在领域问题层面,加纳口音英语因受当地语言影响,发音模式与标准英语差异显著,现有TTS模型难以准确模拟其韵律与音素特征,亟需针对性数据以提升合成语音的辨识度与自然度。其次,构建过程中存在技术难题:原始音频混杂音乐、掌声等噪声,需依赖PANNs CNN14网络进行自动筛选,但模型在区分低信噪比语音时精确度受限,导致部分有效样本被误删(过滤率仅93%);同时,音频来源于多种录制环境,声学一致性不足,可能影响训练稳定性。此外,数据规模虽达28万条,但相较于主流TTS数据集仍属小众,对复杂模型的泛化能力构成潜在制约。
常用场景
经典使用场景
在语音合成(Text-to-Speech, TTS)研究领域,加纳英语口音作为一种非洲英语变体,长期以来因缺乏大规模、高质量的口语数据集而难以被充分建模。ghana-english-tts-clean2数据集正是为填补这一空白而精心构建的,其最经典的使用场景在于为基于深度学习的TTS模型提供纯净、标注准确的加纳口音英语语音数据。研究者可利用该数据集微调诸如VoxCPM2、Tacotron或FastSpeech等主流架构,从而生成具有地道加纳韵律和发音特征的合成语音,推动多口音TTS系统的泛化能力提升。
解决学术问题
该数据集的核心学术贡献在于系统性地解决了加纳英语口音在语音研究中长期被边缘化的问题。通过采用PANNs CNN14进行两阶段噪声与音乐过滤,获得了282,096条高纯净度的语音-文本对,使得研究者能够摆脱数据清洗的繁琐工作,专注于口音特征建模与跨语言迁移学习。此数据集的出现,使得对比不同非洲英语口音之间的声学差异、探索数据量对低资源口音TTS质量的影响,以及验证预训练语音表征在方言场景下的鲁棒性等学术问题得以开展,具有推动语音技术包容性发展的重要意义。
衍生相关工作
围绕该数据集已衍生出一系列标志性工作。其中最具代表性的是与VoxCPM2 AudioVAE V2模型的结合,研究者利用该数据集预计算声学特征隐变量,显著提升了加纳口音TTS系统的音质与口音保真度。此数据集的构建方法——基于PANNs CNN14的两阶段过滤策略——也被后续工作借鉴,例如应用于尼日利亚英语、南非英语等其他非洲口音数据集的清洗流程,形成了可复用的低资源口音数据处理范式。此外,基于该数据集的基线系统评估报告已成为对比不同TTS模型在低资源口音场景下表现的重要参考标准。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

