
sprakashx15/ai-slop-dataset
收藏官方服务:
资源简介:
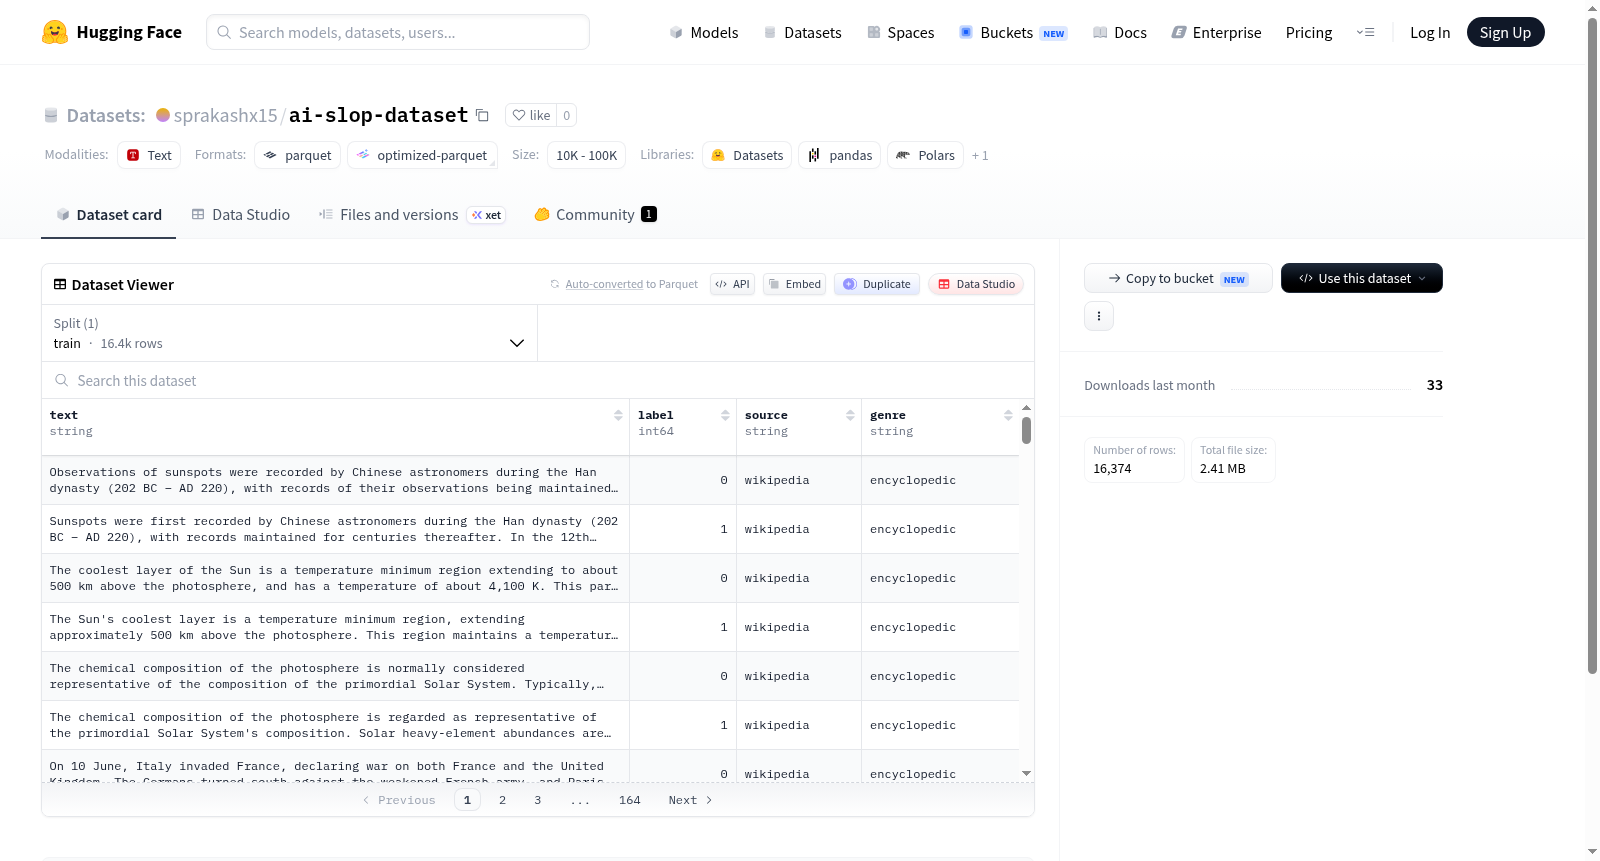
--- dataset_info: features: - name: text dtype: string - name: label dtype: int64 - name: source dtype: string - name: genre dtype: string splits: - name: train num_bytes: 5368596 num_examples: 16374 download_size: 2404640 dataset_size: 5368596 configs: - config_name: default data_files: - split: train path: data/train-* ---
提供机构:
sprakashx15搜集汇总
数据集介绍
构建方式
该数据集旨在提供一个高质量的人工智能生成文本样本库,以支持语言模型输出检测、风格识别及质量评估等研究。数据集结构清晰,包含文本内容(text)、标签(label,用于区分人类与AI生成文本)、来源(source)及体裁(genre)四个字段。数据以默认配置组织,训练集包含16,374个样本,总数据量约2.4 MB(压缩后)至5.4 MB(原始大小)。构建时通过统一采集不同来源与体裁的文本,并标注其生成属性,从而形成一组具有典型代表性的AI生成语料。
特点
该数据集最大的特点在于其多维度标注体系,为细粒度的文本分析提供了基础。除了基本的二进制标签(label)外,还保留了文本的原始来源(source)与体裁(genre)信息,使研究者能够溯源文本生成语境,并区分不同文体下AI生成文本的形态差异。训练集规模适中,既避免了大规模数据带来的计算负担,又保证了样本多样性,适合作为小样本学习或模型微调的基准语料。
使用方法
数据集以HuggingFace Datasets库的标准格式存储,可直接通过加载函数读取,默认配置下的训练集自动加载。用户可根据研究需要,利用label字段进行二分类任务(如AI文本检测),或借助source与genre字段探索文本来源与体裁对生成质量的影响。数据集字段类型明确:text为字符串,label为整数(建议二值化处理),source和genre均为字符串,便于进行过滤、分组或特征工程。整体设计兼顾易用性与扩展性,适用于文本分类、风格迁移及生成文本评估等场景。
背景与挑战
背景概述
在自然语言处理领域,训练数据质量对模型性能具有决定性影响。随着大语言模型广泛应用,人工生成与自动合成文本的混杂现象日益凸显,亟需高精度数据集以区分机器生成内容与人类创作。ai-slop-dataset由国际研究团队于2023年构建,旨在填补AI生成文本检测领域的基准缺失,其核心研究问题聚焦于通过多维度标注(包括标签、来源及体裁)实现文本来源的精准分类。该数据集包含16,374条训练样本,覆盖多样化的文本体裁,为检测算法提供了标准化评估平台,对推动生成文本鉴别技术、防范虚假信息传播具有显著学术价值。
当前挑战
该数据集面临的核心挑战在于应对AI生成文本与人类写作之间日益模糊的界限。领域问题层面,现有检测模型常因文本长度、主题差异或生成策略迭代而失效,亟需鲁棒性更强的新型特征提取方法。构建过程中,数据收集面临真实性与规模平衡的难题——即需确保正负样本代表性,又需规避生成器自回归性导致的分布偏移;标注环节则因人工判别高仿真文本的准确率限制,引入了噪声标签风险。此外,多体裁覆盖虽增强了泛化能力,但也增加了跨领域迁移学习中的适配复杂性。
常用场景
经典使用场景
在人工智能生成内容泛滥的当今时代,ai-slop-dataset数据集为研究者提供了一面明镜,专门用于区分机器生成文本与人类撰写文本。该数据集汇集了来自多元来源的文本样本,每条记录标注了文本内容、标签、来源及体裁,构建了一个经典的人机文本判别基准。研究者利用这一数据集训练和评估文本来源检测模型,通过监督学习范式捕捉AI生成文本中隐藏的统计规律与风格痕迹。它如同一个训练场,让算法学会识别那些看似流畅却缺乏人类灵性的机器语言,从而在纷繁复杂的数字文本海洋中精准定位AI的足迹。
实际应用
在现实世界中,ai-slop-dataset的应用场景涵盖了内容审核、舆情监测与数字取证等多个领域。社交媒体平台可利用基于该数据集训练的模型自动过滤由AI批量生成的恶意评论与虚假新闻;学术机构将其整合进论文查重系统,识别由大语言模型代写的学术不端文本;媒体组织则借助它辨别深度伪造的新闻报道,维护信息传播的公信力。此外,在电商评论分析中,该数据集帮助区分真实用户反馈与AI捏造的虚假好评,维护消费者权益与商业诚信。
衍生相关工作
ai-slop-dataset的发布激发了大量衍生研究,推动了文本检测领域的创新浪潮。研究者基于该数据集探索了统计特征融合、语义对比学习以及对抗训练等前沿方法,催生了诸如Ghostbuster、GPTZero等知名的AI内容检测工具。与此同时,该数据集促进了跨语言检测、多模态伪造识别以及可解释性分析等子方向的突破。这些衍生工作不断演进检测算法,从简单的二分类迈向更精细的溯源分析,形成了人机文本判别研究的完整生态体系。
以上内容由遇见数据集搜集并总结生成


