
Harbor-Index
收藏资源简介:
Harbor-Index是由Harbor项目团队精心策划的元数据集,专为大规模语言模型智能体评估设计,旨在提供经济高效的挑战性基准。该数据集从80余个适配基准测试中,经难度过滤、AI与人工审计及修复循环,精选出82个高难度、多样化的任务,覆盖软件工程、数学推理、科学研究和工具使用等29个领域。创建过程强调任务质量的严格把控,确保失败反映模型局限而非任务缺陷。当前最强模型配置通过率仅28%,避免了快速饱和,为智能体能力的可靠性评估与进步提供了统一平台。
Harbor-Index is a curated metadata dataset developed by the Harbor Project team, specifically designed for large language model (LLM) agent evaluation, aiming to provide a cost-effective and challenging benchmark. This dataset selects 82 high-difficulty, diverse tasks from over 80 adapted benchmark tests through difficulty filtering, AI and human auditing, and iterative repair cycles, covering 29 domains including software engineering, mathematical reasoning, scientific research, tool utilization and more. The development process emphasizes strict quality control over the tasks, ensuring that any failures encountered stem from the model's limitations rather than inherent flaws in the tasks. The current pass rate of state-of-the-art model configurations is merely 28%, which prevents rapid performance saturation, providing a unified platform for reliable evaluation and advancement of agent capabilities.
Harbor Index 数据集概述
基本信息
- 数据集名称:Harbor Index
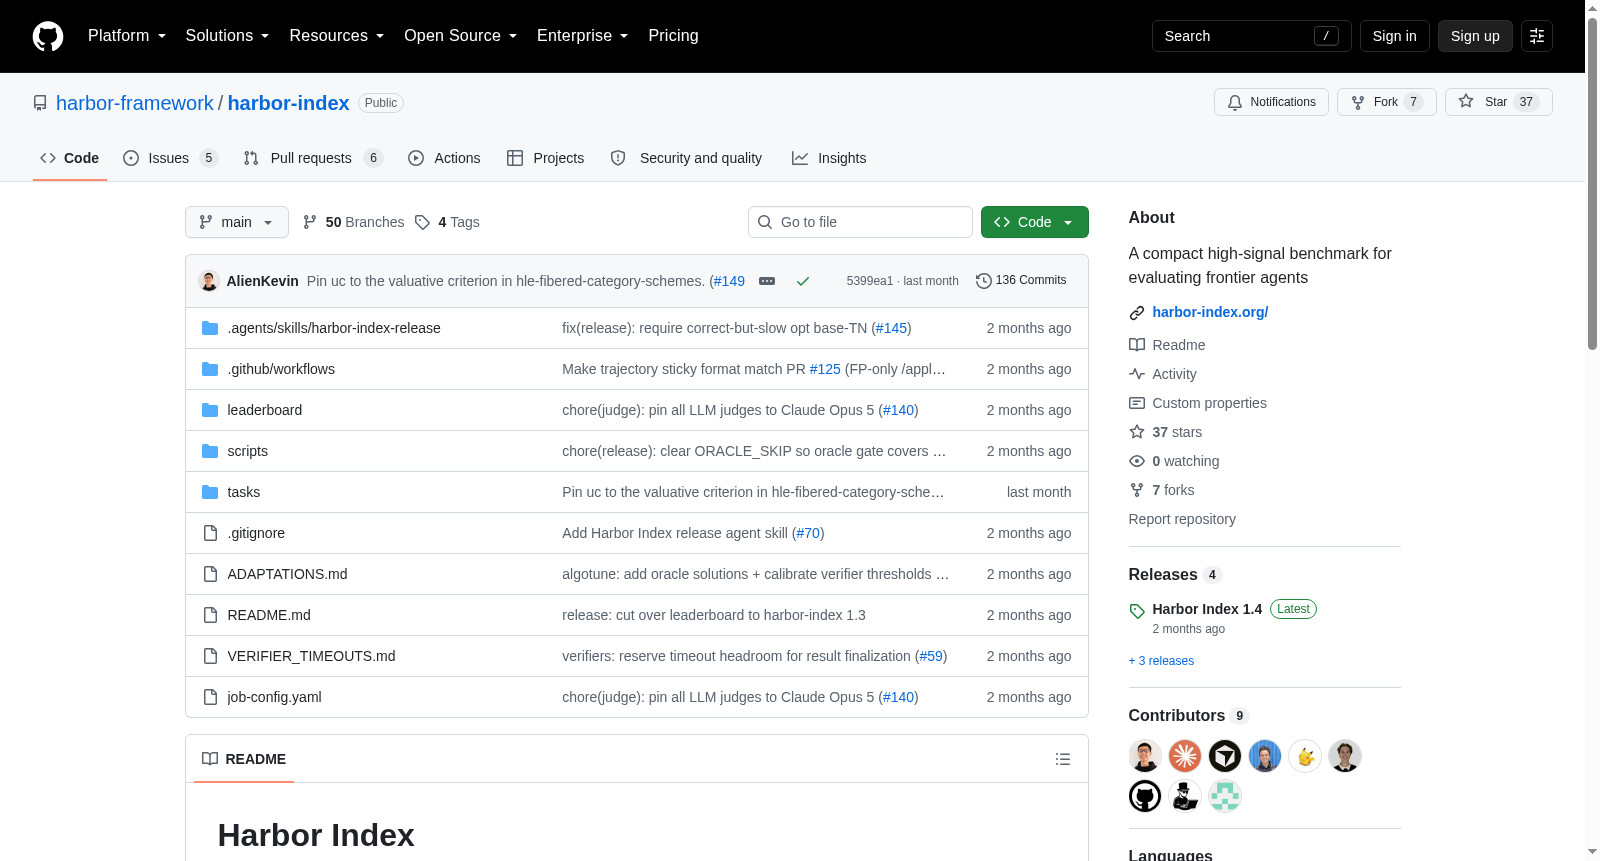
- 数据集地址:https://github.com/harbor-framework/harbor-index
- 任务规模:80 个任务
- 任务类型:面向智能体(agentic)评估的基准测试
数据集来源与构建
- 从超过 6,000 个候选任务中提炼而来
- 提炼方式包括:
- 重复的模型运行
- 自动化损坏任务识别
- 人工审计
- 奖励黑客(reward hacking)监督
提交至排行榜(Leaderboard)流程
1. 运行基准测试并上传结果
- 要求:运行每个任务,每个任务至少 5 次试验,且结果需公开可读
- 运行命令示例:
sh uv run harbor run -c job-config.yaml -a <agent> -m <provider/model> --ak reasoning_effort=<effort> -e <sandbox> --ve OPENAI_API_KEY="$OPENAI_API_KEY" --ve ANTHROPIC_API_KEY="$ANTHROPIC_API_KEY" --ve GEMINI_API_KEY="$GEMINI_API_KEY" --upload --public
- API 密钥用途:用于对部分任务进行评分的 LLM-judge 集成
- 模板文件:
job-config.yaml固定了所需的 judge verifier 设置 - 若此前未使用
--upload运行,可在事后上传作业目录:
sh uv run harbor upload ./jobs/<job-dir> --public
2. 提交 PR
sh cd leaderboard uv run lb submit https://hub.harborframework.com/jobs/<uuid> [more...]
3. 跟进 PR
- CI 会验证提交
- 维护者会审查轨迹(trajectories)
- 合并后,提交将成为排行榜上的新行
- 排行榜地址:https://hub.harborframework.com/datasets/harbor-index/harbor-index/latest?tab=leaderboard&leaderboard=harbor-index-1-3
- 技术细节参见:
leaderboard/SUBMIT.md
发布版本(Cutting a release)
- 面向维护者:通过让智能体执行发布(例如 "cut harbor-index v1.3")
- 使用技能文件:
.agents/skills/harbor-index-release/SKILL.md - 注意:没有一次性发布工作流
- 工具细节参见:
scripts/README-build-push-pin.md
任务维护
- 在添加或更改长时间运行的 verifier 时,需遵循 verifier 超时余量政策
- 政策文件:
VERIFIER_TIMEOUTS.md - 该政策内容:
- 将评估预算与外部 verifier 截止时间分离
- 记录了如何根据发布 oracle 时间重新校准余量
- 1Harbor Adapters and Harbor-Index: Infrastructure and a Curated Meta-Dataset for Large-Scale Agentic Evaluation康奈尔大学; 北京大学 · 2026年


