
MacroCycle Dataset
收藏官方服务:
资源简介:
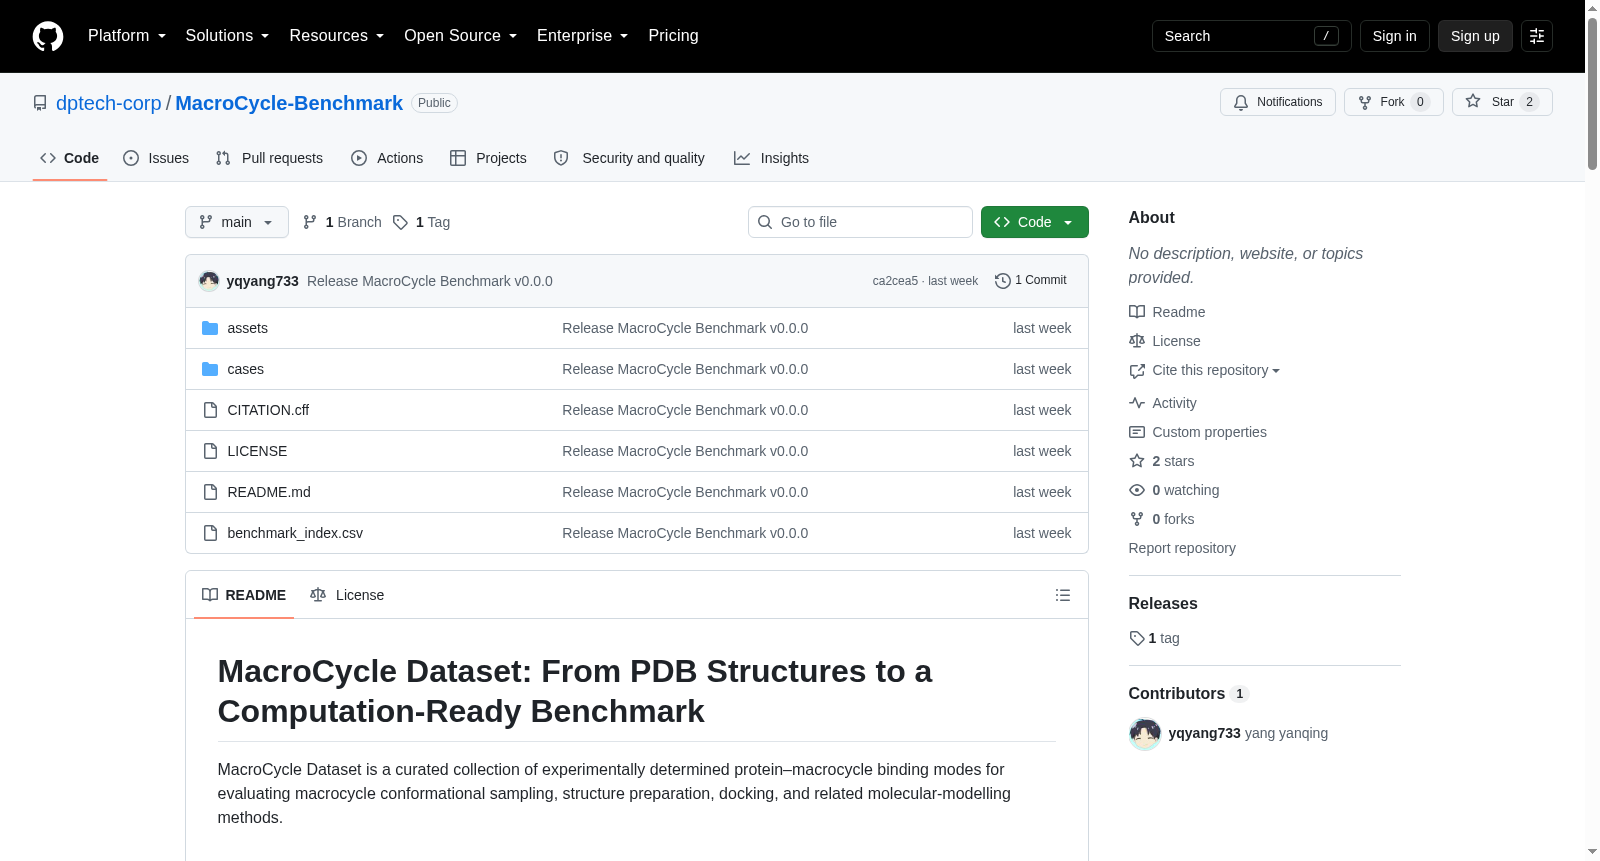
MacroCycle数据集是一个经过精心整理的实验确定的蛋白质-大环化合物结合模式集合,用于评估大环化合物的构象采样、结构准备、对接及相关分子建模方法。
The MacroCycle Dataset is a carefully curated collection of experimentally determined protein-macrocycle binding modes, designed to evaluate conformational sampling, structure preparation, docking and related molecular modeling methods for macrocyclic compounds.
创建时间:
2026-08-24
原始信息汇总
数据集概述
MacroCycle Dataset 是一个经过人工筛选的实验测定蛋白质-大环化合物结合模式数据集,旨在为大环化合物构象采样、结构准备、分子对接及相关分子建模方法提供评估基准。
数据规模
| 项目 | 数量 |
|---|---|
| 蛋白质-大环化合物结合模式案例 | 1,861 |
| 独特的未质子化大环结构 | 1,570 |
| 独特的PDB条目 | 1,686 |
| 初级大环尺寸(原子数) | 8–40 |
数据内容
每个案例目录(cases/{case_id}/)包含三个文件:
- protein.pdb:作为实验结合背景提供的蛋白质结构。
- ligand_unprotonated.sdf:经过审核的配体实验坐标,包含原子连接性和键序信息,未进行pH依赖性质子化,是基准评估的参考配体结构。
- ligand_protonated.sdf:通过计算制备的pH 7.4形式,含有显式氢原子,基于未质子化结构生成并保留重原子坐标,高置信度的酸/碱错误已审核并修正。
核心案例元数据及未质子化/质子化异构体SMILES记录在 benchmark_index.csv 中,该索引包含1,861条记录,每行对应一个案例,主要字段包括:
case_id:稳定的案例目录名。pdb_id:RCSB PDB登录号。resolution_A:实验结构分辨率(Å)。structure_title:PDB结构标题。publication_doi:相关文献DOI。unprotonated_isomeric_smiles:从参考配体衍生的异构体SMILES。protonated_isomeric_smiles:计算制备的质子化形式SMILES。primary_ring_size:初级大环原子数,普通小环不计入。
缺失的源元数据以空字段表示,而非虚构值。
数据构建
数据集的构建流程包括:
- 通过筛选RCSB PDB中的实验测定结构筛选大环候选物,而非仅依赖关键词或配体注释。
- 使用LigandExplorer(Li et al., 2026)将候选配体从蛋白复合物中分离。
- 通过残基和原子级连接性分析确认真正的大环,排除非目标或结构不可用条目,保留代表观察结合背景的蛋白链。
- 保留实验重原子坐标,重构化学连接性和键序,并与原始PDB/mmCIF记录、CCD定义、沉积实例坐标文件和原始文献交叉验证。
- 生成pH 7.4质子化SDF作为计算就绪衍生物,并审核高置信度质子化错误。
- 通过自动化验证和人工PyMOL审查确保配体结构、SMILES、元数据及蛋白-配体配对的一致性后冻结发布。
快速使用
可通过Pandas加载索引并查看基本统计信息(print(index.shape) 输出 (1861, 8)),也可使用RDKit加载参考配体(如从 cases/10hy__Ligand_organic_A1C5F_A_301/ligand_unprotonated.sdf 读取分子)。
引用与许可
- 引用时请使用
CITATION.cff中的元数据,并引用原始实验结构文献的DOI。 - 基准编译、筛选、索引、文档和原始图片采用CC BY 4.0许可。
- 来自PDB档案的结构数据遵循wwPDB/RCSB PDB CC0政策。
- 数据按原样提供,无任何担保,用户需自行评估其科学适用性。
搜集汇总
数据集介绍
构建方式
该数据集的构建基于RCSB PDB实验结构库的深度挖掘,借助LigandExplorer工具从蛋白复合物中精准分离候选配体,通过残基与原子层面的连通性分析,严格甄别出真正的环肽分子,剔除非目标或结构不可用的条目,并保留代表结合环境的蛋白链。对每个入选案例,保留实验重原子坐标,利用Guess Bond Order重构化学键连接与键级,并交叉核对原始PDB/mmCIF记录、CCD定义及原始文献。最终,以未质子化配体为结构参考,生成pH 7.4质子化衍生形式,经自动化验证与人工PyMOL审查,确保配体结构、SMILES、元数据及蛋白-配体配对的一致性后冻结发布。
特点
该数据集作为首个冻结的公共基准,涵盖1,861个蛋白-环肽结合模式案例,包含1,570个独特的未质子化环肽结构,源自1,686个PDB条目,主环尺寸介于8至40个原子。其核心特色在于提供经严格审计的未质子化配体结构作为评估参考,以及由计算生成的pH 7.4质子化版本,便于直接用于计算模拟。数据集配备完整的元数据索引(benchmark_index.csv),包含案例标识、PDB编号、分辨率、SMILES及环尺寸等信息,且所有缺失字段均如实留空,确保高度透明与可追溯性。
使用方法
用户可通过读取benchmark_index.csv快速浏览数据集全貌,利用Pandas检查维度与环尺寸分布。针对单个案例,可使用RDKit加载cases目录下对应文件夹中的ligand_unprotonated.sdf作为参考配体结构,用于构象采样、对接或结构准备等评估。蛋白质文件protein.pdb提供实验结合环境,而ligand_protonated.sdf则为计算友好的质子化形态。所有案例均附有源PDB条目的DOI,便于引用原始实验文献,数据集整体采用CC BY 4.0许可,结构数据遵循RCSB PDB的CC0政策,用户可根据需求自由使用并遵循引用规范。
背景与挑战
背景概述
MacroCycle Dataset 是一个精心整理的实验测定蛋白质-大环化合物结合模式数据集,由研究团队基于RCSB PDB中的实验结构构建,旨在为宏环构象采样、结构准备、分子对接及相关分子建模方法提供计算基准。该数据集于2026年首次发布,包含1,861个结合模式案例,涵盖1,570个独特的未质子化宏环结构和1,686个PDB条目。其核心研究问题在于解决宏环配体在蛋白质结合环境中的构象多样性和结合模式预测问题,填补了现有基准缺乏高质量大环结合数据的空白。通过严格的质量控制流程,包括自动验证和人工复核,该数据集为评估计算方法的性能提供了可靠的参考,并已通过DOI和CITATION.cff被引用于多项研究,对药物设计和计算化学领域产生了显著影响。
当前挑战
该数据集面临的挑战主要源于领域问题和构建过程。在领域问题层面,宏环化合物的构象复杂性远超线性分子,其灵活的环状结构导致构象采样和结合模式预测极具挑战性,且现有分子建模工具对大环的处理能力有限。构建过程中的挑战包括:从PDB中筛选真正的大环配体需精细的连通性分析,以排除错误注释或非目标结构;重建配体化学键和键序需综合多种数据源,确保准确性与一致性;质子化状态的确定需平衡计算便利性与生物学相关性,并需人工审核高置信度错误;最终的数据清理和验证涉及大量人工审查,确保每个案例的准确性和可重现性。这些挑战要求构建过程融合自动化工具与专家判断,以保证数据集的科学严谨性。
常用场景
经典使用场景
MacroCycle数据集作为首个面向蛋白质-大环化合物结合模式的冷冻基准,其核心应用场景在于系统评估和基准测试大环化合物的构象采样、结构准备及分子对接方法。该数据集提供了1,861个经过严格筛选和人工审核的实验结合模式案例,每个案例包含未质子化的参考配体结构和pH 7.4条件下的质子化衍生物,为计算方法的开发与验证提供了标准化的数据基础,尤其适用于验证大环化合物柔性处理、环系感知的对接算法以及结合模式预测的准确性。
衍生相关工作
MacroCycle数据集的发布催生了一系列后续研究工作。一方面,它为新型大环化合物专用打分函数和构象采样算法的开发提供了测试平台,推动了如基于环系统感知的对接评分改进等方向的发展。另一方面,该基准常被用于对比不同分子动力学模拟方案或增强采样技术在大环体系中的表现。此外,其详细标注的SMILES和质子化信息支持了深度学习模型在配体表示学习和结合模式预测上的探索,促进了计算化学与人工智能的交叉研究。
数据集最近研究
最新研究方向
基于实验测定的大环-蛋白质结合模式,MacroCycle数据集为宏环构象采样、结构准备、分子对接等计算方法提供了计算就绪的基准,尤其聚焦于环尺寸8-40个原子的大环分子。该数据集通过从PDB中系统性筛选并严格验证,确保每个条目拥有高质量的未质子化参考配体结构,并附带pH 7.4质子化衍生物,以支持生理条件下的模拟。其发布恰逢大环药物设计领域对环状化合物构象灵活性与结合亲和力预测的日益关注,为验证和优化新一代采样算法与打分函数提供了宝贵资源,有望推动大环类候选药物的理性设计与虚拟筛选的精准度提升。
以上内容由遇见数据集搜集并总结生成


