
遇见数据集

fzmnm/TinyStoriesAdv-zh

收藏
Hugging Face2024-08-21 更新2024-12-14 收录
官方服务:

资源简介:

TinyStoriesAdv是一个约1B tokens的小学知识水平的大语言模型训练语料库,旨在提升模型的事实性知识、元认知、思维链、阅读理解RAG、逻辑推理等能力。数据集是众多数据集的集合,通过创新的提示词生成方法,生成了具有多样性和针对性的子数据集。数据集可以作为TinyStories数据集的替代品,供对人工智能感兴趣的爱好者和学生入门体验大模型的魔力。数据集覆盖了小学生的日常常识、小学百科全书以及小学语文课程内容,支持了阅读理解、问题回答等多种交互模态。使用本数据集,可以在100M参数规模下得到一个可以实现基本的小学生常识问答的大语言模型。

TinyStoriesAdv is a comprehensive large language model training corpus based on elementary school knowledge level, inspired by papers such as TinyStories and Phi2, containing various innovative prompt-generated sub-datasets with diversity and targeting. The dataset covers elementary school students daily common sense, elementary encyclopedias, and elementary Chinese curriculum content, supporting various interactive modalities such as reading comprehension and question answering. The construction method of the dataset includes multiple sub-datasets such as encyclopedias generated by GPT4o, tinystories_adv, chinese_class, math, tinygames, quizs, and tinybooks, aiming to enhance the models various capabilities, such as factual knowledge, metacognition, chain of thought, reading comprehension RAG, and logical reasoning.
提供机构:
fzmnm
搜集汇总
数据集介绍
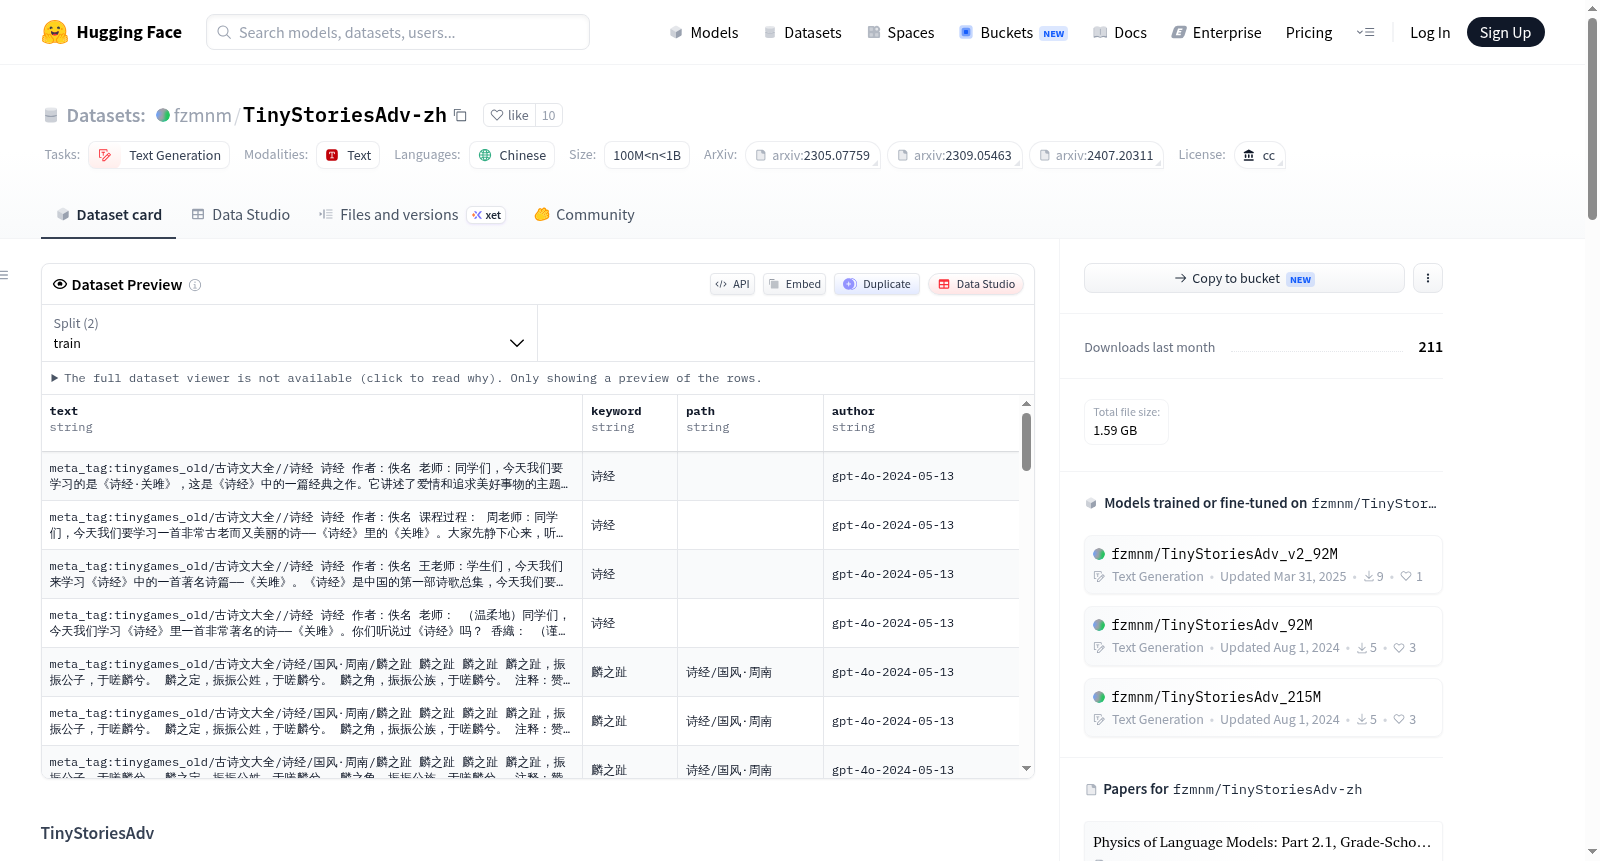
fzmnm/TinyStoriesAdv-zh 数据集图片
构建方式
TinyStoriesAdv-zh数据集构建于前沿语言模型研究基础之上,旨在为小型语言模型提供高质量训练语料。其构建方法融合了多种创新策略,首先以GPT-4o生成适合幼儿园至小学生认知水平的百科全书词条作为核心知识源。随后,借助GPT-4o-mini基于这些词条生成大量多样化的小故事,过程中通过插入百科参考以缓解模型幻觉问题。为增强数据丰富性,设计了多个子数据集:包括通过词条联想生成连贯故事的association_generation、要求模型向缺乏常识的外星人解释逻辑的cot_problem_solving、融合多文本提升RAG能力的story_merge、仿写语文课本的style_reference_generation,以及覆盖基础常识的tuple_generation。此外,还利用GPT-4o模拟小学语文和数学课堂、游戏过程,生成问答与练习数据。整体采用meta_tag标记数据来源,引导模型关注高质量子集。
特点
该数据集以小学知识水平为核心,覆盖日常常识、百科全书及语文课程内容,显著扩展了传统TinyStories的知识范畴。其最大特点在于多样性:不仅包含多种文体如散文、议论文、记叙文、书信等,还融入负面结局、对话、转折等叙事元素,模拟真实语言场景。数据集特别强化了模型的元认知能力,通过标注修辞手法(如排比、讽刺)使模型“明白自己在使用何种表达”。同时,通过思维链任务、阅读理解选择题和文本融合生成,提升了模型的逻辑推理、RAG及上下文学习能力。此外,tinygames子数据集专注于Object Persistence、Theory of Mind等认知能力的训练。所有数据均以中文呈现,总量约1B tokens,适合中小规模模型预训练。
使用方法
本数据集适用于从头训练或微调中文语言模型,尤其适合参数规模在100M至215M之间的模型。用户可直接从HuggingFace加载数据集,无需额外预处理。训练时建议使用标准文本生成任务格式,每个样本前附带的meta_tag可作为领域标签,帮助模型区分不同子数据集质量。对于计算资源有限的场景,如使用单张A100 GPU,可在约7小时内完成100M参数模型的预训练;普通游戏显卡(如RTX 2080)亦可在不到一周内完成。训练后可实现小学生常识问答、阅读理解、思维链推理等任务。数据集未进行安全或幻觉审核,用户在使用前应自行评估风险。相关模型权重和生成代码已开源,便于复现与扩展。
背景与挑战
背景概述
在自然语言处理领域,大语言模型的训练语料库构建一直是研究热点,尤其是针对资源受限场景下的小型模型。TinyStoriesAdv-zh数据集由研究者fzmnm于2024年创建,受TinyStories和Phi2等开创性工作的启发,旨在为小学知识水平的大语言模型提供高质量训练数据。该数据集突破了传统故事补全任务的局限,通过整合百科全书、语文课程、数学逻辑及认知游戏等多模态子数据集,构建了一个约1B tokens的综合性语料库。其核心研究问题在于:在100M参数规模下,如何实现具备基础常识问答、阅读理解与逻辑推理能力的小型语言模型。该数据集不仅降低了入门门槛(如7小时A100 GPU即可预训练92M模型),还通过meta_tag标注策略优化了异构数据的知识聚焦能力,对推动小型语言模型在教育和认知模拟领域的应用具有重要影响。
当前挑战
该数据集面临的核心挑战包括:其一,领域问题层面,需在极低参数规模下同时覆盖事实性知识、元认知、思维链与RAG能力,这对数据多样性与任务耦合设计提出极高要求。例如,TinyStoriesAdv通过联想词生成、故事融合等六种子数据集策略,试图解决小型模型知识覆盖不足与语境碎片化之间的矛盾,但模型在复杂逻辑推理与长文本理解上的泛化能力仍存疑。其二,构建过程中,合成数据依赖GPT-4o/-mini生成,虽引入百科词条参考以减少幻觉,但未进行人工审核,导致安全、事实性错误及逻辑漏洞未被系统过滤。此外,不同子数据集的质量差异(如GPT-4o-mini生成的quizs数据)可能通过meta_tag机制部分缓解,但低质量数据对模型知识记忆的干扰仍需通过更精细的领域标注与数据加权策略进一步解决。
常用场景
经典使用场景
TinyStoriesAdv-zh数据集的核心经典使用场景在于为小型语言模型(如参数规模在100M左右的模型)提供高质量、多样化的中文训练语料,使其能够掌握小学知识水平的基本常识、语言表达与逻辑推理能力。受TinyStories与Phi2等先驱工作的启发,该数据集通过合成大量具有不同文体、语境和交互模态的小故事、百科词条、语文课模拟、数学题与游戏对话,显著扩展了传统故事补全任务的范畴。研究者可借助该数据集从头训练一个能够进行基础问答、阅读理解与简单思维链推理的迷你语言模型,在极低的算力成本下(如7小时A100 GPU)快速验证小模型在知识密集型任务上的潜力。
解决学术问题
该数据集精准回应了当前大语言模型研究中的两个核心学术问题:其一,如何在极小参数规模下(如10M至100M)实现超越简单模式匹配的语义理解与常识推理,TinyStoriesAdv-zh通过引入事实性知识、元认知标签与多模态交互数据,突破了原始TinyStories仅聚焦故事连贯性的局限;其二,如何有效利用合成数据缓解高质量中文语料稀缺的困境,其创新的分层生成策略(如词条联想、思维链解释、文本融合与风格仿写)为数据增强提供了可复现的方法论范式。此外,通过加入domain labeling机制,该数据集探索了在异构质量数据中引导模型关注高价值子集的学习规律,对理解语言模型的知识容量缩放律具有重要参考意义。
衍生相关工作
TinyStoriesAdv-zh的发布催生了一系列富有启发性的后续工作。在模型层面,研究者基于该数据集训练了92M与215M参数的预训练模型(fzmnm/TinyStoriesAdv_92M与fzmnm/TinyStoriesAdv_215M),验证了极小模型在问答与多模态任务上的可行性,并开源了模型权重供社区复现与改进。在方法论层面,其创新的子数据集设计(如association_generation、cot_problem_solving与story_merge)为合成数据领域提供了新的增强策略,后续工作借鉴了其词条递归联想与文本融合范式,用于提升生成故事的主题连贯性与事实准确性。此外,该数据集对元认知标签与domain labeling的运用,启发了若干关于数据质量标注与模型知识记忆机制的研究,成为探索小规模语言模型知识容量缩放律的重要实验平台。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

