
drought-manager-sim synthetic dataset
收藏官方服务:
资源简介:
一个完全合成的、经过校准的数据集,用于模拟真实水公用事业的数据结构,包括账户级日消费面板、主水表日聚合输入、SCADA成品水生产数据、压力区映射等,所有数据基于虚构的城镇和客户生成,但统计特性与真实数据一致。
A fully synthetic and calibrated dataset designed to replicate the data structures of real water utilities, including account-level daily consumption panels, daily aggregated input data from master water meters, SCADA finished water production data, pressure zone mappings, and more. All data is generated based on fictional towns and customers, while its statistical properties are consistent with real-world water utility datasets.
创建时间:
2026-07-24
原始信息汇总
数据集概述:drought-manager-sim
数据集简介
该数据集是一个完全合成的数据集,用于水务公用事业的需水预测与因果推断研究。核心特点是:数据虽为虚构,但经过校准以复现真实公用事业数据的统计结构,不包含任何真实客户记录或真实基础设施位置。
数据文件构成
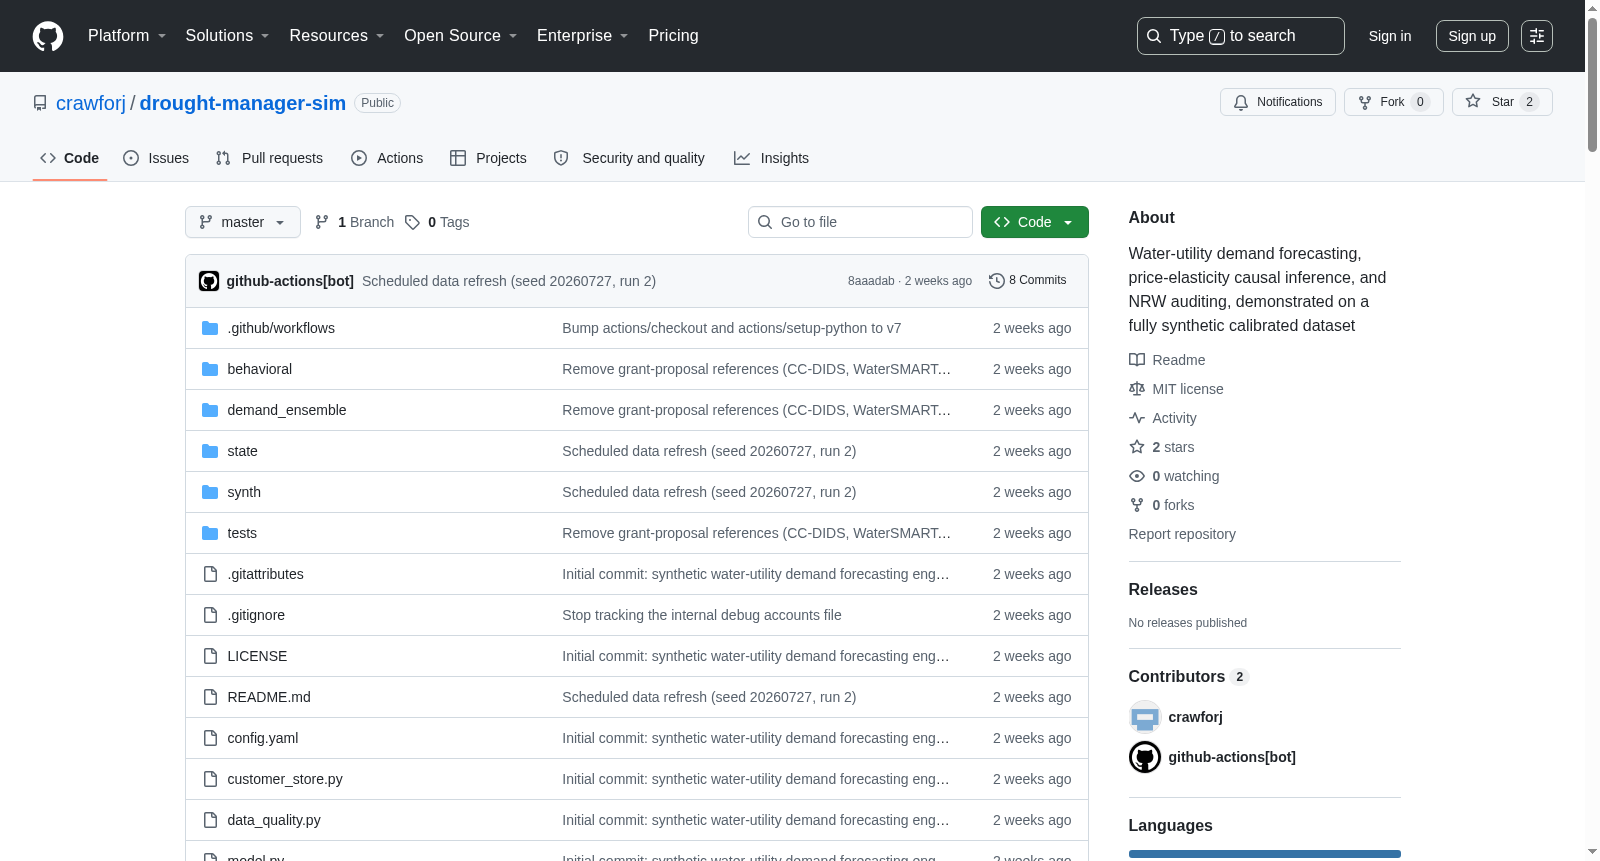
- 客户历史面板 (
state/customer_history/):约9,000个虚构账户的日消费面板数据,覆盖2023–2026年,以月度parquet文件存储 - 主表历史数据 (
state/entry_point_history.parquet):系统A的主表日聚合输入数据 - 生产历史数据 (
production_history.csv):系统B的SCADA成品水生产数据 - 表计区域映射 (
state/meter_zone_map.parquet):账户至压力区/系统的映射关系 - 压力区地理信息 (
state/gis/pressure_zones.shp):虚构压力区shapefile(含配套.dbf/.shx/.prj文件) - 配置文件 (
config.yaml):虚构主表站点表、定价等级、模型配置 - 天气缓存 (
state/weather_cache.csv):用于驱动合成需求序列的真实公共NOAA天气数据 - 验证结果 (
synth/validation_results.json):验证表的完整精度数据(账户计数、精确p值等)
合成数据生成方法
采用“校准-生成-验证”三步流程:
- 校准(私有完成):从真实数据分析中提取聚合统计参数——处理效应大小及标准误、聚类质心和协方差、季节/天气响应系数、自相关结构、输入-消费相关性
- 虚构地理:通过Voronoi镶嵌程序化生成虚构的压力区域系统和主表站点表
- 生成面板:使用校准参数与虚构地理,合成账户级日常面板和系统聚合序列(约9,000个虚构账户,2023–2026年)
- 验证:在合成面板上运行真实分析代码并与真实结果对比
验证效果
| 指标 | 真实值 | 合成值 |
|---|---|---|
| 价格弹性DiD:tier1效应 | -10.2% | -14.4% |
| 价格弹性DiD:tier2/3效应 | -9.7% | -15.4% |
| DiD效应显著性 | 负向,p=0.033 | 负向,p=0.0000 |
| 头部用户体积占比 | 1.0%账户→25.5%体积 | 1.0%→24.6% |
| 空闲/间歇用户占比 | 3.2% | 3.2% |
| NRW相关性(系统A) | 0.988 | 0.989 |
| NRW相关性(系统B) | 0.939 | 0.914 |
| 需求预测均值 (MGD) | 10.7 | 4.3 |
匹配良好的方面:NRW相关性、头部用户和空闲账户占比、价格弹性效应的方向与显著性。 存在的差异:价格弹性效应百分比高于校准目标;聚类分析恢复出2个簇而非3个(归因于未保持真实的跨特征相关性)。
数据更新机制
- 每月1日通过GitHub Actions自动重新生成数据(新的随机种子)
- 重新运行测试套件和验证过程,更新README中的验证表
- 仅使用仓库内已包含的数据(天气缓存覆盖固定日期范围),无需API令牌
- 虚构地理信息不重新生成,仅重新生成客户面板
配套分析代码
behavioral/:天气归一化、差分中的差分、中断时间序列、贝叶斯结构时间序列因果影响、双重机器学习、k-means行为分割demand_ensemble/:SARIMA+SVM+梯度提升多模型需求预测集成nrw.py:非收益水日常水收支审计(AWWA M36约定)model.py:含自动偏差校正的OLS/气候学需求预测synth/:合成数据流水线及验证/更新脚本
搜集汇总
数据集介绍
构建方式
该合成数据集源自一项针对真实水务公司运营数据的分析引擎,鉴于真实数据涉及客户隐私与基础设施敏感信息,无法直接公开。因此,研究者采用“校准-生成-验证”的范式,先于私有环境中从真实数据提炼出聚合统计参数(如处理效应量、聚类中心、季节性系数、自相关结构等),再虚构一个名为“Antler Creek”的小镇地理空间(通过Voronoi镶嵌算法程序化生成压力分区与站点布局),进而生成约9000个虚构账户的日度用水面板及系统级序列,覆盖2023至2026年。整个流程确保任何真实账户或位置信息均不涉及,而合成数据的统计特性与真实数据高度吻合。
特点
该数据集的最大特色在于其时序与横截面的双重仿真性。它融合了真实NOAA气象数据驱动需求序列,使得用水模式具备天气响应性;同时,通过校准参数复现了价格弹性效应(负向显著)、高消费用户集中度(约1%账户贡献25%水量)、空置账户占比等关键业务指标。此外,数据集支持非收益水(NRW)审计,其主表与SCADA产水量数据的相关性高达0.9以上,且具备多模型预测所需的序列自相关结构。每月自动再生的机制保证了数据的新鲜度,且所有生成过程基于仓库内已有数据,无需外部依赖。
使用方法
用户可便捷地通过Git LFS克隆仓库获取全部Parquet及Shapefile文件。运行环境配置简单,执行`pip install -r requirements.txt`后,即可运行测试套件或独立模块(如`python -m behavioral.did`)进行价格弹性估计、用户分群、需求预测等分析。若要重新生成数据集,可依次运行`python -m synth.geography`与`python -m synth.generate_panel`。此外,仓库预置的验证脚本与自动化工作流(每月刷新)允许用户复现或更新验证结果,确保数据质量与论文结论的可复现性。
背景与挑战
背景概述
干旱管理模拟合成数据集(drought-manager-sim)由美国科罗拉多州虚构小镇“Antler Creek”的供水公用事业需求预测与因果推断引擎团队于2023至2026年间构建,旨在解决真实客户级用水数据因隐私和识别风险而无法公开的难题。该数据集通过“校准-生成-验证”流程,在完全合成的数据中复现真实公用事业数据的统计结构,涵盖约9000个虚构账户的日消费面板、主表日聚合流量、SCADA产水量、压力区GIS数据及NOAA气象驱动序列。其核心研究问题包括价格弹性估计、客户行为分群、短期/中期需求预测集成及无收益水审计。该数据集在隐私保护与科研可复现性之间取得平衡,为水务领域提供了可公开共享的基准数据,推动了需求预测和因果推断方法的验证与比较。
当前挑战
该数据集面临的核心挑战包括:1) 领域问题层面,需在完全合成的数据上复现真实数据的统计特性,以支持需求预测、因果推断等分析任务,但合成数据在跨特征相关性上存在偏差,如分群数量从真实数据的3类降为2类,且价格弹性效应幅度高于校准目标,影响模型泛化能力;2) 构建过程中,需在不泄露任何真实客户记录或基础设施位置的前提下,确保合成数据的效度,这要求从真实数据中仅提取聚合统计参数(如处理效应、聚类中心、季节系数)并重构地理拓扑,同时通过月度自动化流水线重新生成数据并验证一致性,但验证方法(如代理分类)与注入的真实分类存在差异,导致结果噪声增加,权衡了数据保真度与发布安全性。
常用场景
经典使用场景
该合成数据集为水务公用事业的需水预测与因果推断研究提供了理想的实验平台,尤其适用于价格弹性估计、用户行为细分以及短期与中期需水集成预测等场景。其精心校准的统计特性,如自相关结构和气象响应系数,使研究者能够在无真实客户隐私风险的前提下,复现真实数据的分析流程,验证模型在模拟环境中的有效性,从而加速算法迭代与方法论创新。
衍生相关工作
基于此数据集,研究社区可衍生出多项经典工作,包括开发更鲁棒的因果效应估计框架、改进聚类算法以精准识别行为细分、构建混合预测模型以增强需水预报精度,以及探索数据合成方法在隐私保护领域的泛化应用。该数据集作为基准测试平台,催生了针对合成数据有效性验证的评估指标,并促进了跨领域(如统计学与机器学习)合作,推动了水务智能管理研究的深入与拓展。
数据集最近研究
最新研究方向
面向水务智能化的因果推断与合成数据验证,drought-manager-sim数据集通过校准真实统计结构生成全合成客户面板,支撑需求预测弹性估计、用户行为分群及无收益水审计等前沿分析。该数据集契合当前水务行业数字化转型与隐私保护并重的热点,其创新在于以‘生成而非匿名化’策略,在完全虚构的地理与账户体系上复现真实数据的因果效应和模式,使研究可复现且无隐私泄露风险。验证机制和月度自动刷新确保数据时效性,为算法从真实场景向开源迁移提供可信基准,对促进水务AI模型的稳健性和跨域泛化研究具有范式意义。
以上内容由遇见数据集搜集并总结生成


