dh-unibe/image-text_parlamentsdienste-protokolle
收藏资源简介:
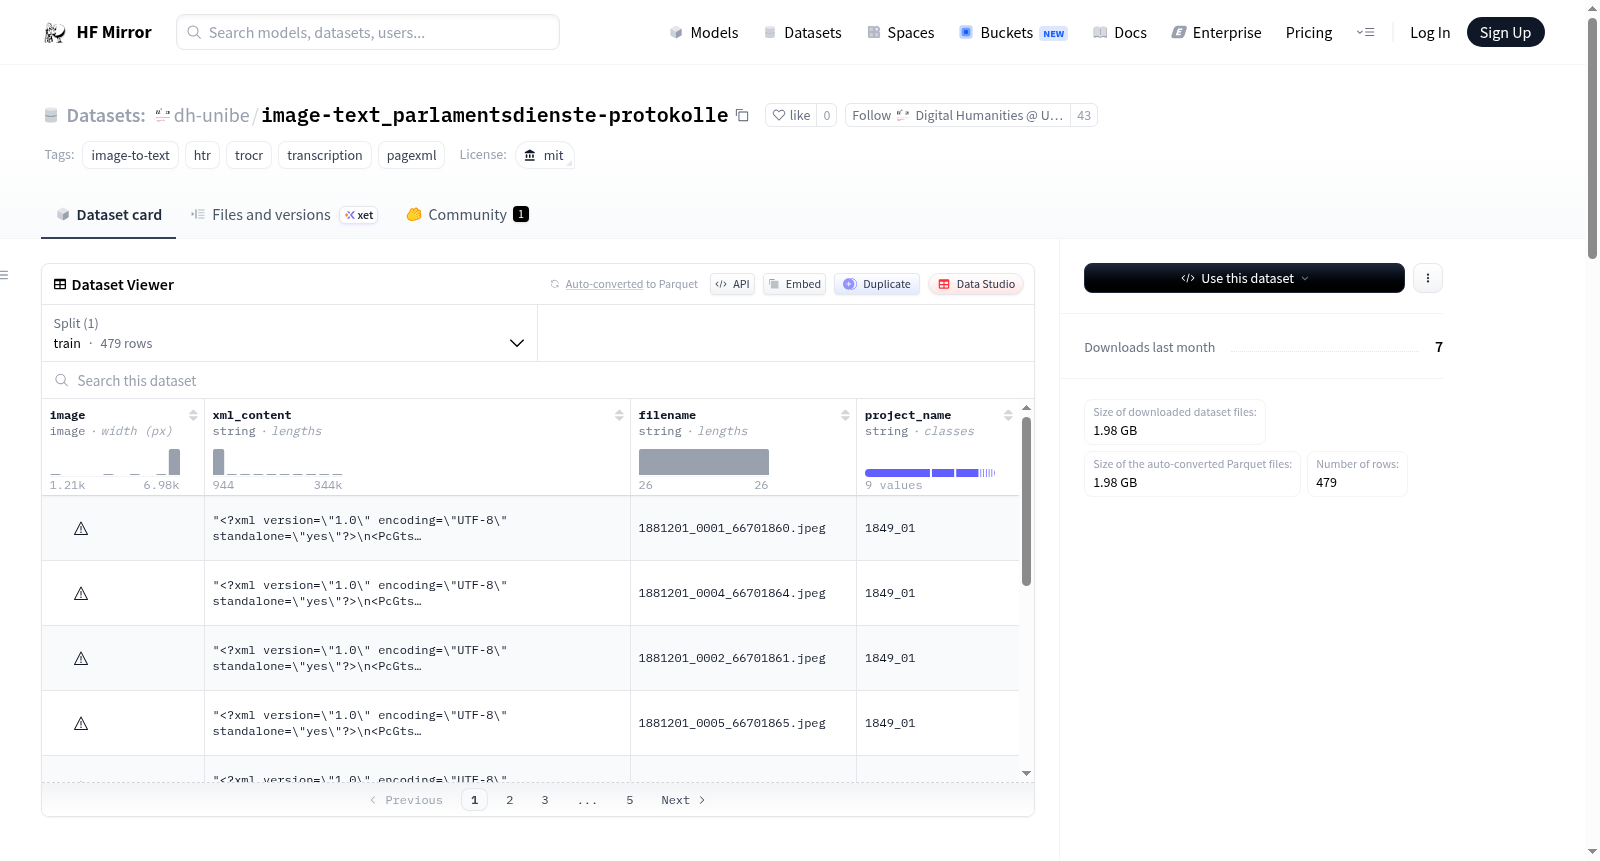
--- dataset_info: config_name: default features: - name: image dtype: image: decode: false - name: xml_content dtype: string - name: filename dtype: string - name: project_name dtype: string splits: - name: train num_examples: 479 num_bytes: 13996110802 download_size: 13996110802 dataset_size: 13996110802 configs: - config_name: default data_files: - split: train path: data/train/**/*.parquet tags: - image-to-text - htr - trocr - transcription - pagexml license: mit --- # Dataset Card for transkribus-exports-280089-1-raw-xml This dataset was created using pagexml-hf converter from Transkribus PageXML data. ## Dataset Summary This dataset contains 479 samples across 1 split(s). Geographical scope: Switzerland<br>Period: 1848-1900<br>Languages: German, French<br>Type of document: Protocols<br>Provenance: Swiss Federal Archives ### Projects Included - 1849_01 - 1849_02 - 1849_03 - 1849_04 - 1849_05 - 1849_06 - 1849_07 - 1849_08 - 637157213248534270_verkleinert ## Dataset Structure ### Data Splits - **train**: 479 samples ### Dataset Size - Approximate total size: 13347.73 MB - Total samples: 479 ### Features - **image**: `Image(mode=None, decode=False)` - **xml_content**: `Value('string')` - **filename**: `Value('string')` - **project_name**: `Value('string')` ## Data Organization Data is organized as parquet shards by split and project: ``` data/ ├── <split>/ │ └── <project_name>/ │ └── <timestamp>-<shard>.parquet ``` The HuggingFace Hub automatically merges all parquet files when loading the dataset. ## Usage ```python from datasets import load_dataset # Load entire dataset dataset = load_dataset("dh-unibe/transkribus-exports-280089-1-raw-xml") # Load specific split train_dataset = load_dataset("dh-unibe/transkribus-exports-280089-1-raw-xml", split="train") ```
数据集信息: 配置名称:默认(default) 特征项: - 名称:图像(image),数据类型: 图像类型,解码(decode)设为false - 名称:XML内容(xml_content),数据类型:字符串(string) - 名称:文件名(filename),数据类型:字符串(string) - 名称:项目名称(project_name),数据类型:字符串(string) 数据划分: - 名称:训练集(train),样本数量:479,字节数:13996110802 下载大小:13996110802 数据集总大小:13996110802 配置项: - 配置名称:默认,数据文件: - 数据划分:训练集,路径:data/train/**/*.parquet 标签: - 图像到文本(image-to-text) - 手写文本识别(htr) - TrOCR(trocr) - 转录(transcription) - PageXML(pagexml) 许可证:MIT许可证(mit) --- # transkribus-exports-280089-1-raw-xml 数据集卡片 本数据集基于Transkribus的PageXML数据,通过pagexml-hf转换器生成。 ## 数据集概览 本数据集包含1个数据划分,共计479个样本。 地理覆盖范围:瑞士<br>研究时段:1848-1900<br>涉及语言:德语、法语<br>文档类型:会议纪要<br>数据来源:瑞士联邦档案馆(Swiss Federal Archives) ### 包含的项目 - 1849_01 - 1849_02 - 1849_03 - 1849_04 - 1849_05 - 1849_06 - 1849_07 - 1849_08 - 637157213248534270_verkleinert ## 数据集结构 ### 数据划分 - **训练集(train)**:共479个样本 ### 数据集规模 - 近似总大小:13347.73 MB - 总样本量:479 ### 特征项说明 - **图像(image)**:`Image(mode=None, decode=False)` - **XML内容(xml_content)**:`Value('string')` - **文件名(filename)**:`Value('string')` - **项目名称(project_name)**:`Value('string')` ## 数据组织方式 数据按数据划分与项目名称组织为Parquet分片,目录结构如下: data/ ├── <split>/ │ └── <project_name>/ │ └── <timestamp>-<shard>.parquet Hugging Face Hub 在加载数据集时会自动合并所有Parquet文件。 ## 使用示例 python from datasets import load_dataset # 加载完整数据集 dataset = load_dataset("dh-unibe/transkribus-exports-280089-1-raw-xml") # 加载指定数据划分 train_dataset = load_dataset("dh-unibe/transkribus-exports-280089-1-raw-xml", split="train")