
us-caselaw-md
收藏官方服务:
资源简介:
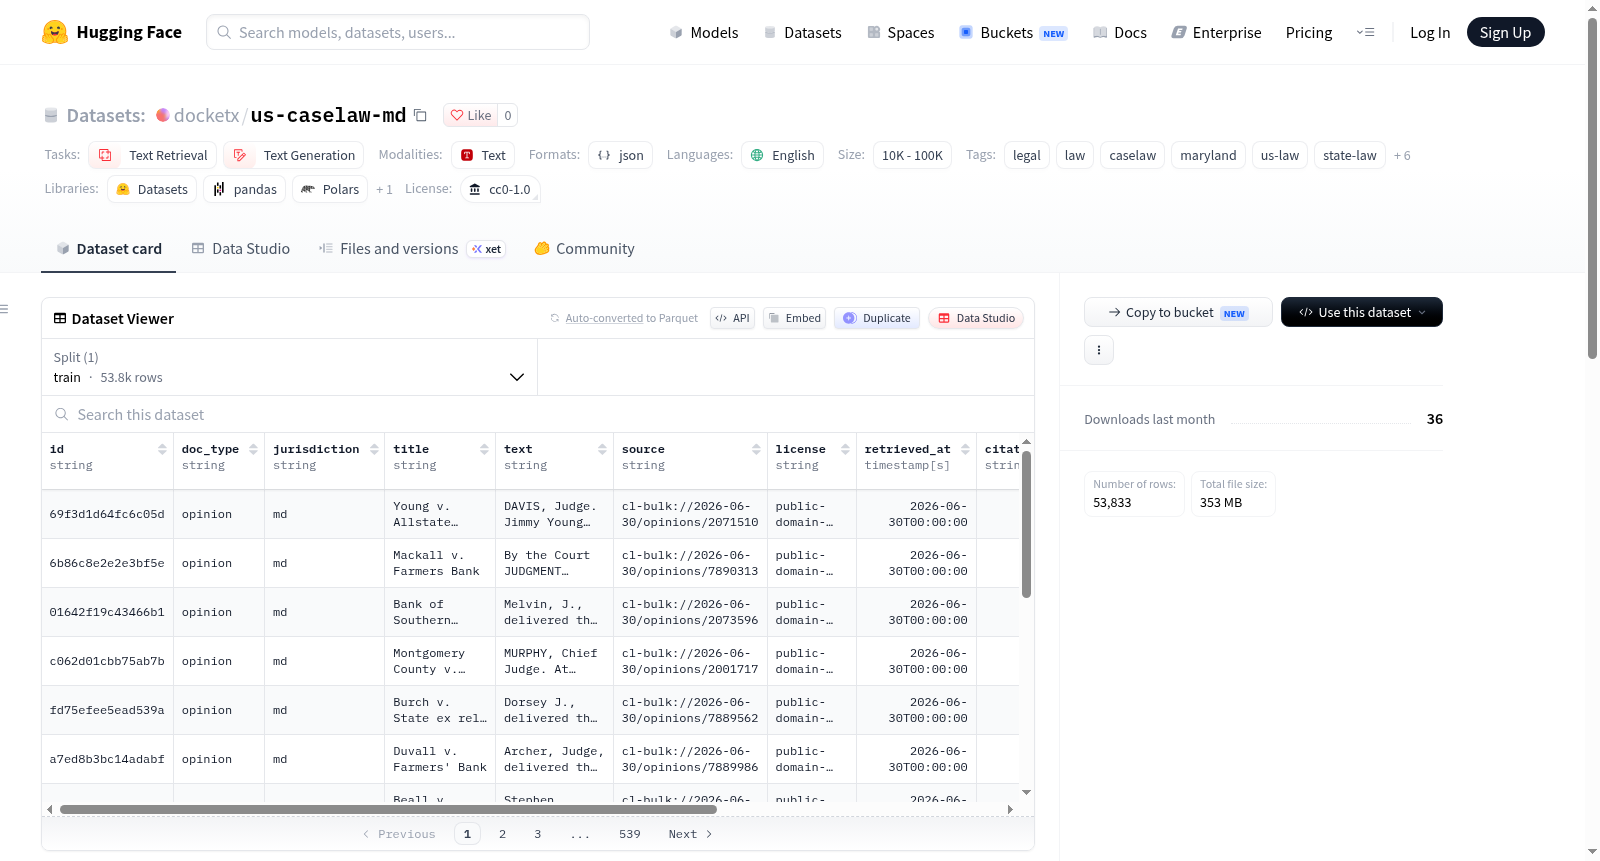
该数据集为马里兰州上诉法院意见全文数据集,包含53,833份来自公开记录的法院意见文档。数据源自Free Law Project的CourtListener批量导出(2026-06-30),覆盖三个马里兰州法院:马里兰州上诉法院(md)、马里兰州特别上诉法院(mdctspecapp)以及马里兰州最高法院(mdch,即原马里兰州上诉法院)。数据集包含主要意见和单独意见,并排除了长度小于1个字符的文档。文档长度分布:43,075份(80.0%)超过2000字符,6,719份(12.5%)在200-1999字符之间,4,039份(7.5%)不足200字符(这些短文档为真实的记录,如调卷令拒绝、单行命令和判决条录,故意保留以呈现完整公共记录)。数据格式采用docketx record v1标准,每条记录一行,包括字段:id(唯一标识)、doc_type(文档类型)、jurisdiction(管辖区域)、title(标题)、text(全文文本)、source(来源)、license(许可证)、retrieved_at(获取时间)、citation(引用信息)、court(法院)、date(日期)、extra(额外信息,包含CourtListener意见/集群ID及意见类型)。该数据集适用于法律文本检索、法律文本生成、RAG(检索增强生成)以及法律自然语言处理等任务。所有司法意见均为公共领域作品,本打包版本以CC0 1.0许可证发布,不添加任何注释,不主张任何权利。
创建时间:
2026-09-06
搜集汇总
数据集介绍
构建方式
该数据集源起于美国马里兰州上诉法院公开裁判文书的系统性整理需求,以Free Law Project旗下CourtListener平台于2026年6月30日发布的批量导出数据为底本,经由严格的白名单机制筛选出马里兰州三个上诉法院(md、mdch、mdctspecapp)的裁判意见,涵盖主意见与单独意见,仅剔除文本长度不足1个字符的文档,从而完整保留了公共记录的全貌。切片过程采用sha256校验确保数据完整性,最终形成53,833份裁判文书,并以docketx record v1格式逐行存储,每行对应一份意见,字段包括标识符、文书类型、管辖法院、标题、正文、来源、许可、检索时间以及引证、法院、日期等扩展信息。
特点
数据集的核心特质在于其完整性与原真性。全部文本均属政府法令,依据Banks诉曼彻斯特案及佐治亚州诉Public.Resource.Org案所确立的规则,司法意见不受版权保护,属于公共领域作品,故本数据集以CC0 1.0许可发布,不附加任何权利主张。数据规模逾五万份,其中约八成文档正文超过2,000字符,另有少量调卷令驳回、单行命令与判决登记等短记录被刻意保留,以维持公共记录的完整性。文档统一遵循docketx记录格式,为跨数据集的检索与生成任务提供一致性基础。
使用方法
使用者可通过HuggingFace datasets库以一行代码加载该数据集,即调用load_dataset("docketx/us-caselaw-md"),获取默认配置下的数据文件。加载后的数据集适用于文本检索、文本生成及法律自然语言处理等任务,尤其适合构建法律领域的检索增强生成系统。若仅需实质性裁判意见,可依据文本长度字段进行过滤,例如筛选len(text)大于2,000的文档。数据行中丰富的元数据字段支持按法院、日期、引证等维度进行细粒度分析与建模,为法律研究、判例检索与司法文本挖掘提供结构化的语料基础。
背景与挑战
背景概述
法律判例文本的规模化获取与结构化管理,长期以来构成法律信息学与计算语言学交叉领域的基础性议题。马里兰州判例法数据集(us-caselaw-md)于2026年6月30日由DocketRouter团队基于Free Law Project旗下CourtListener批量导出数据构建而成,收录马里兰州三级上诉法院共53,833份公开裁判文书,涵盖主意见与并存意见,以docketx record v1统一格式封装,遵循CC0 1.0许可。该数据集回应了法律检索增强生成与判例检索研究中对州级上诉法院全量语料的迫切需求,为法律自然语言处理提供了可复现的公共领域语料基础。
当前挑战
该数据集所面向的核心领域问题在于法律文本检索与生成任务中判例语料的完整性、结构化与可追溯性之间的平衡。构建过程中,研究者需应对多重挑战:其一,法院标识须采用显式白名单精确匹配,避免前缀匹配引入无关司法管辖区文书;其二,裁判文书长度分布高度不均,约7.5%的记录不足200字符,涵盖调卷令驳回、单行命令与判决登记等真实司法记录,若简单过滤将损害公共记录的完整性;其三,需确保数据切片哈希与来源清单一致,以保障大规模语料在分布式环境下的可验证性与可复现性,同时避免对公有领域文本附加任何不当权利主张。
常用场景
经典使用场景
在计算法学与法律信息检索领域,判例全文语料库长期构成实证研究的基石。us-caselaw-md汇集马里兰州三级上诉法院五万余份公开裁判文书,其经典使用场景集中于判例检索与法律问答系统的构建。研究者可依托该数据集训练稠密检索模型,将自然语言案情描述映射至相关判决,亦可借助检索增强生成框架,使大语言模型在援引具体判例的基础上生成法律意见。由于文书涵盖主意见与并存意见,该数据集亦适用于判决论证结构的细粒度分析,为法律文本的篇章建模提供高质量素材。
解决学术问题
法律人工智能研究长期受制于高质量判例语料的稀缺与格式异构,既有资源多聚焦联邦层级,州法层面的系统性文本近乎阙如。本数据集以统一的docketx记录格式整合马里兰州上诉法院裁判全文,有效缓解了州法语料碎片化的困境。其保留全部公开记录而不作实质性过滤,使研究者得以考察简易裁定与实体判决的分布差异,进而回答检索模型在不同文书长度下的鲁棒性、判例引用的时间衰减效应等基础问题,为州法语料的标准化整理树立了可复用的范式。
衍生相关工作
作为DocketRouter法律语料体系的组成部分,该数据集与同系列的其他州法及联邦判例数据集共享统一模式,衍生出一批跨辖区法律检索与生成研究。基于此类语料,学界相继提出面向判例的稠密检索基准、法律问答评测集以及引文网络分析工具,推动了法律自然语言处理从单一文本分类向检索增强推理的范式迁移。该数据集所采用的docketx记录格式亦被后续资源建设沿用,逐步形成州法语料标准化封装的事实约定,为法律大模型的持续预训练与领域适配提供了可扩展的数据基础设施。
以上内容由遇见数据集搜集并总结生成
相关数据集

暂无相关数据集


