
greek-hle
收藏官方服务:
资源简介:
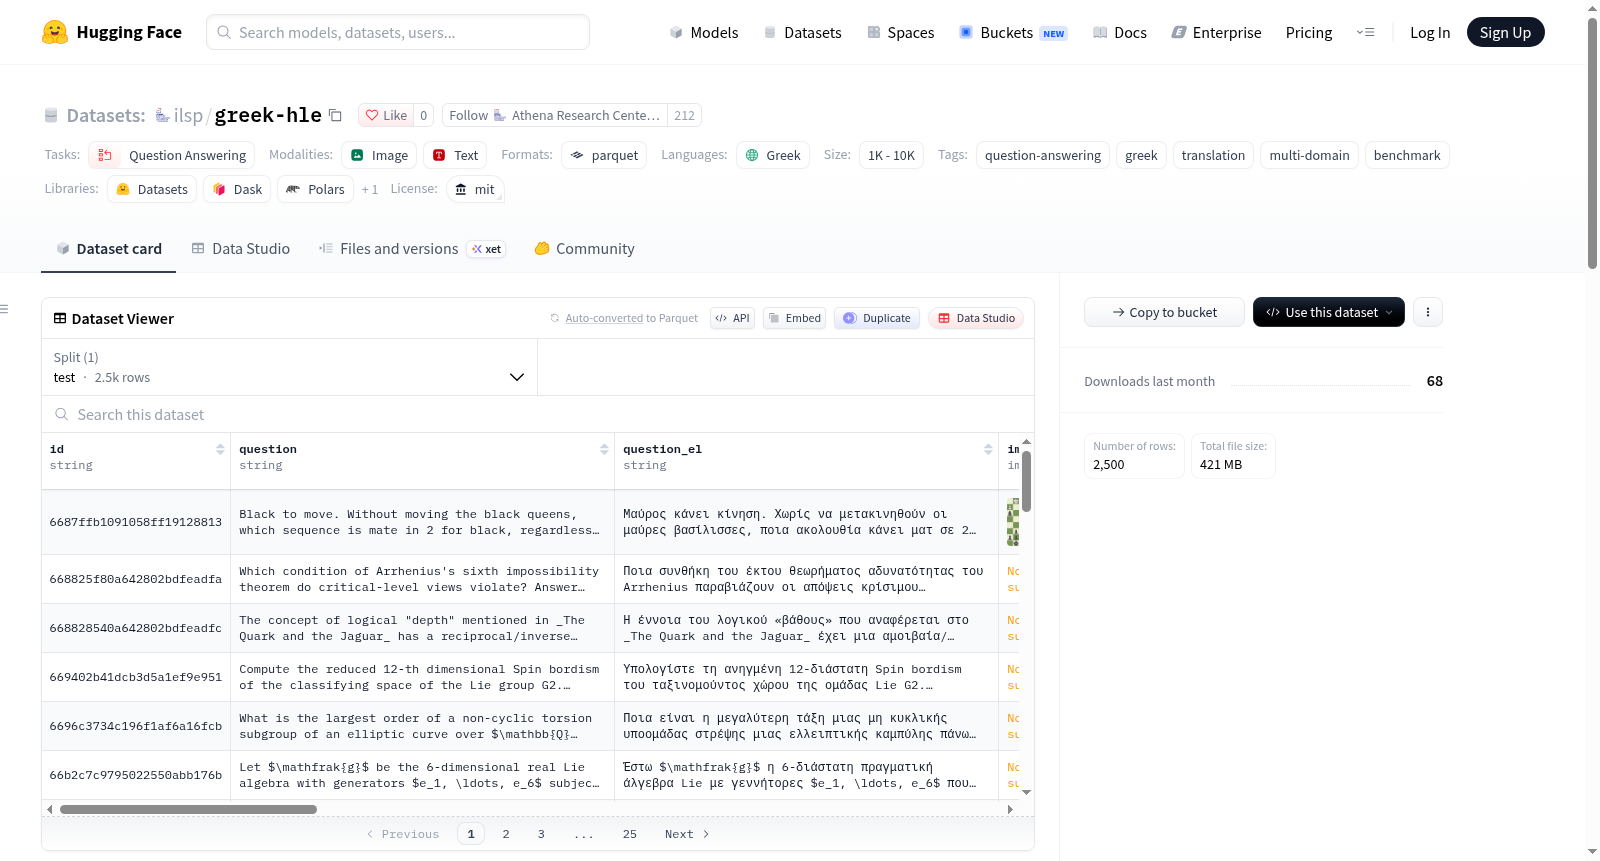
Humanity's Last Exam – 希腊语翻译版(greek-hle)是原始 Humanity's Last Exam(cais/hle)基准数据集的希腊语版本。该数据集包含2,500个专家级问题,覆盖广泛的学术与专业领域,旨在评估或微调模型在多领域专家级问答任务上的能力。数据集仅包含测试集,每个样本包含英文和希腊语双语的问題、答案、推理过程,以及相关的图像、作者信息、学科分类和类别标签。字段包括:唯一标识符(id)、英文问题(question)、希腊语问题(question_el)、问题相关图像(image)、英文答案(answer)、希腊语答案(answer_el)、答案类型(answer_type,如精确匹配或多项选择)、问题作者(author_name)、英文推理(rationale)、希腊语推理(rationale_el)、推理相关图像(rationale_image)、原始学科(raw_subject)、希腊语学科(raw_subject_el)、广泛类别(category)、希腊语类别(category_el),以及用于训练数据过滤的canary字符串。
创建时间:
2026-09-30
搜集汇总
数据集介绍
构建方式
该数据集的构建源于对原始Humanity's Last Exam基准的希腊语本地化需求,通过自动化翻译流程将2,500道专家级问题从英语转译为希腊语。构建过程涵盖问题、答案、推理依据及相关类别标签的完整翻译,并邀请领域专家对翻译结果进行审核,以checked_translation字段标记审核状态,确保译文的准确性与专业术语的一致性。
特点
数据集涵盖广泛的学科与专业领域,提供双语对照的问答内容,包含问题、答案、推理依据及其希腊语译文,并保留原始图像与 rationale 图像。数据字段丰富,涵盖answer_type、raw_subject、category等多维度信息,配套canary字符串用于训练数据过滤,且经过专家审核的翻译条目显著提升了跨语言评测的可靠性。
使用方法
研究者可通过Hugging Face的datasets库以load_dataset('ilsp/greek-hle')加载该数据集,获取测试集共2,500条样本。数据适用于希腊语专家级问答任务,支持模型评估与微调,可利用question_el、answer_el及rationale_el字段进行希腊语场景下的推理与验证,同时借助checked_translation字段筛选高质量翻译样本,结合图像字段处理多模态问答。
背景与挑战
背景概述
人类终极考试(Humanity's Last Exam, HLE)系由人工智能安全中心(Center for AI Safety)与Scale AI于2025年联合推出的专家级基准数据集,旨在以跨学科高难度问题评估大语言模型的深层推理与知识边界。希腊语版本greek-hle由希腊语言与语音处理研究所(ILSP)主导构建,将原版2,500道题目系统译介为希腊语,涵盖数学、人文、自然科学及专业领域,并保留原版图像与解析。该数据集为低资源语言环境下的模型能力评估提供了关键资源,推动了希腊语自然语言处理与多语言基准测试的融合发展。
当前挑战
该数据集所应对的领域问题在于:现有专家级问答基准多集中于英语,低资源语言(如希腊语)缺乏同等难度与规模的评估工具,难以衡量大模型在非英语语境下的专业推理能力。构建过程中的核心挑战包括:专业术语与学术表达的精准跨语言映射,文化特定概念的等效转换,以及确保翻译后题目在语义与难度上与原版严格对齐。此外,人工审校覆盖不全可能导致部分条目质量参差,图像与文本的跨模态一致性维护亦构成显著难题。
常用场景
经典使用场景
在跨语言基准评测的浪潮中,greek-hle作为Humanity's Last Exam的希腊语版本,最经典的用途在于评估大语言模型在希腊语语境下的专家级问答能力。该数据集涵盖2,500道经领域专家撰写并翻译的多学科高难度问题,涉及数学、物理、法律、医学等广泛领域,模型需以精确匹配或多项选择形式输出答案。研究者借助该数据集衡量模型在低资源语言环境中的知识迁移与推理表现,并可通过对比原始英文版与希腊语版的性能差异,系统分析翻译质量对模型理解的影响,从而为多语言模型的鲁棒性评估提供关键测试基准。
实际应用
在实际应用层面,greek-hle为希腊语智能问答系统的开发与优化提供了直接支撑。教育科技机构可借助该数据集构建面向希腊语学习者的自适应测评工具,医疗、法律等垂直领域亦可利用其专家级题目评估本地化助手的专业可靠性。模型开发者能够以该数据集为验证集,微调或筛选适用于希腊语场景的大语言模型,特别是在需要高精度推理的问答任务中,该数据集可作为上线前的质量门禁。此外,其附带的答案类型与专家解析字段,为自动化评分系统与解释生成模块的设计提供了结构化参考,有助于加速希腊语人工智能产品的落地进程。
衍生相关工作
greek-hle的问世催生了一系列围绕跨语言基准迁移与低资源语言适配的衍生工作。部分研究以其为蓝本,探索将Humanity's Last Exam进一步扩展至其他语言(如意大利语、葡萄牙语)的可行路径,并分析翻译与本地化过程中的语义损耗。与此同时,若干模型评估报告将该数据集纳入多语言评测套件,用于比较不同架构在希腊语专家任务上的表现差异。还有工作聚焦于利用其checked_translation标签,研究人工审核对翻译质量与下游任务性能的调节效应。这些衍生研究共同深化了对多语言评测方法论的理解,并推动了高难度跨语言数据集的构建标准与共享实践。
以上内容由遇见数据集搜集并总结生成
相关数据集

暂无相关数据集


