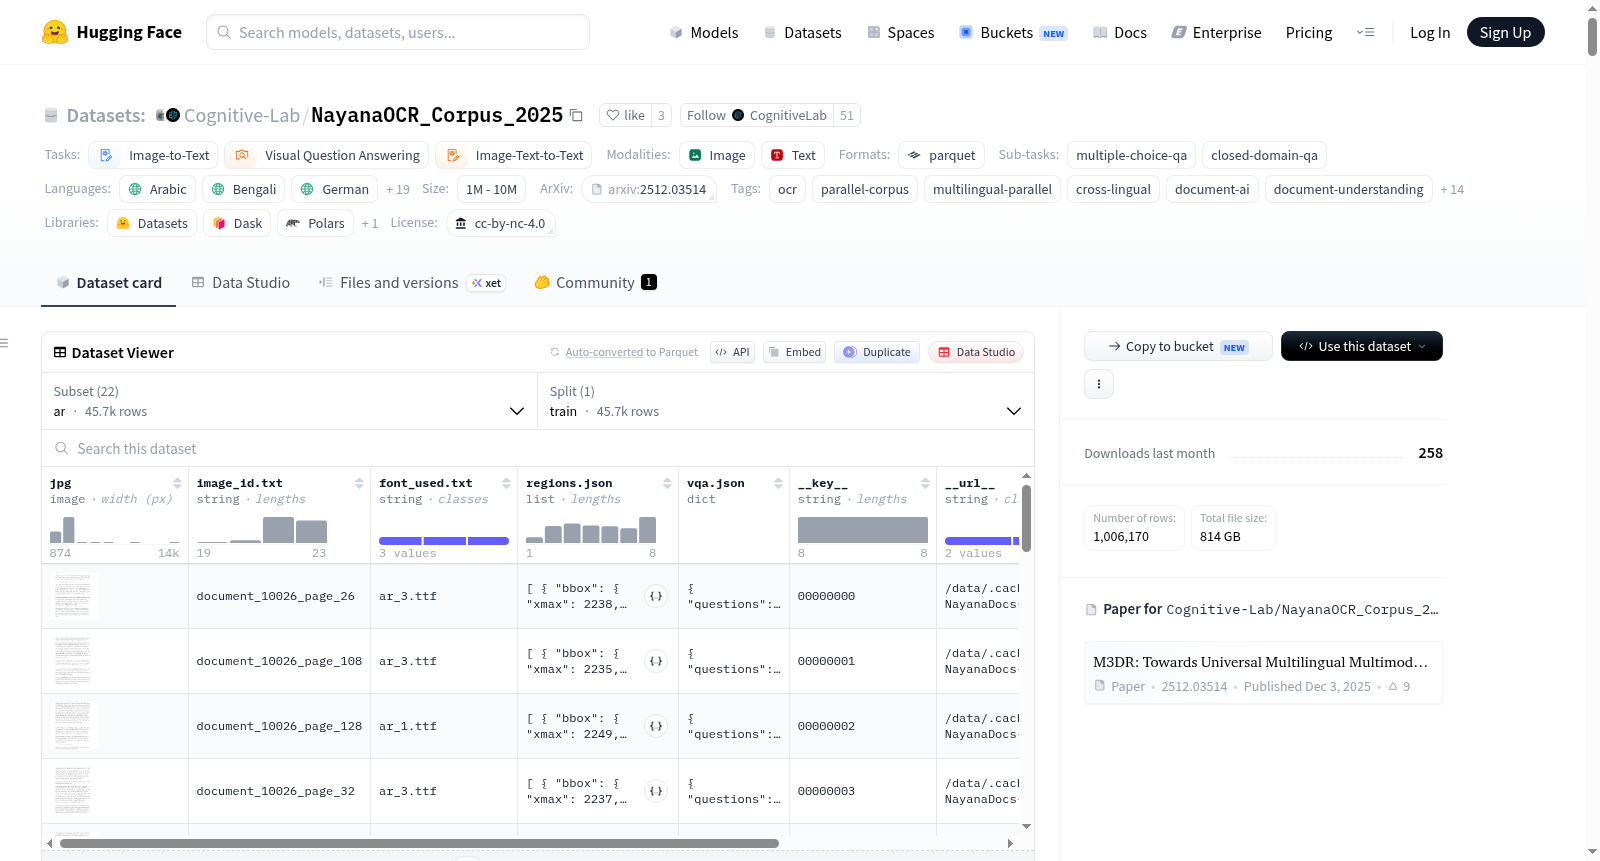
NayanaOCR_Corpus_2025
收藏资源简介:
NayanaOCR语料库2025版是一个大规模、多语言、机器生成的文档图像数据集,专为光学字符识别(OCR)、文档理解、视觉问答(VQA)和跨语言视觉语言建模任务而设计。它涵盖23种语言,包括阿拉伯语、孟加拉语、德语、英语、西班牙语、法语、古吉拉特语、印地语、意大利语、日语、卡纳达语、韩语、马拉雅拉姆语、马拉地语、奥里亚语、旁遮普语、俄语、梵语、泰米尔语、泰卢固语、泰语和中文,特别关注印度语言和其他低资源语言。每个数据样本包含JPG格式的文档图像、图像标识符和字体信息、详细的区域级标注(如边界框坐标、布局类型、区域ID、原始英文文本及目标语言翻译文本,构成高质量多语言平行语料库),以及一个视觉问答(VQA)标注集(包含多项选择题、答案、选项列表和问题类型)。数据集规模庞大,每个语言配置的训练集约45,735个样本,总体在百万到千万级别(1M < n < 10M),以语言为维度组织,每个语言子集为独立配置,适用于训练和评估多模态模型在文档图像分析、多语言文本提取、跨语言信息检索和文档级视觉问答等任务上的性能。
The 2025 version of the NayanaOCR corpus is a large-scale, multilingual, machine-generated document image dataset designed for optical character recognition (OCR), document understanding, visual question answering (VQA), and cross-lingual vision-language modeling tasks. It covers 23 languages, including Arabic, Bengali, German, English, Spanish, French, Gujarati, Hindi, Italian, Japanese, Kannada, Korean, Malayalam, Marathi, Odia, Punjabi, Russian, Sanskrit, Tamil, Telugu, Thai, and Chinese, with a special focus on Indian languages and other low-resource languages. Each data sample contains a document image in JPG format, image identifiers and font information, detailed region-level annotations (including bounding box coordinates, layout type, region ID, original English text and target language translated text, forming a high-quality multilingual parallel corpus), as well as a visual question answering (VQA) annotation set that includes multiple-choice questions, answers, option lists, and question types. The dataset has a massive scale: each language-specific training split contains approximately 45,735 samples, with the overall size ranging from 1 million to 10 million (1M < n < 10M). It is organized by language, with each language subset as an independent configuration, suitable for training and evaluating the performance of multimodal models on tasks such as document image analysis, multilingual text extraction, cross-lingual information retrieval, and document-level visual question answering.
数据集名称:NayanaOCR Corpus 2025
核心信息
- 主要用途:用于光学字符识别(OCR)、多语种平行语料、跨语言文档理解与视觉问答(VQA)的合成数据集。
- 许可协议:Creative Commons Attribution Non Commercial 4.0 (cc-by-nc-4.0),并附有独立的 Nayana OCR 研究许可。
- 数据规模:总样本量超过 100 万且小于 1000 万(1M < n < 10M),共包含 22 个语言子集,每个子集均含 45,735 个训练样本。
- 数据来源:原始生成(machine-generated),所有标注均为机器自动生成。
语言覆盖
该数据集是一个多语种平行语料库,涵盖以下 22 种语言,每种语言作为一个独立配置(config):
| 语种 | 代码 | 语种 | 代码 |
|---|---|---|---|
| 阿拉伯语 | ar | 孟加拉语 | bn |
| 德语 | de | 英语 | en |
| 西班牙语 | es | 法语 | fr |
| 古吉拉特语 | gu | 印地语 | hi |
| 意大利语 | it | 日语 | ja |
| 卡纳达语 | kn | 韩语 | ko |
| 马拉雅拉姆语 | ml | 马拉地语 | mr |
| 奥里亚语 | or | 旁遮普语 | pa |
| 俄语 | ru | 梵语 | sa |
| 泰米尔语 | ta | 泰卢固语 | te |
| 泰语 | th | 中文 | zh |
任务类型
数据集支持以下三类任务:
- 图像到文本(image-to-text)
- 视觉问答(visual-question-answering)
- 图像-文本到文本(image-text-to-text)
具体任务包括多重选择问答(multiple-choice-qa)和封闭域问答(closed-domain-qa)。
数据结构与特征
每个语言子集(例如 ar, en, hi)均包含以下特征字段,但英文子集(en)的翻译文本字段(translated_text)除外:
| 字段名 | 类型 | 说明 |
|---|---|---|
jpg |
图像 | 文档页面图像 |
image_id.txt |
字符串 | 图像唯一标识符 |
font_used.txt |
字符串 | 生成该图像所使用的字体信息 |
regions.json |
列表 | 文档区域标注,包含以下子字段 |
├─ bbox |
结构(xmax, xmin, ymax, ymin) | 边界框坐标(整数) |
├─ english_text |
字符串 | 区域内英文原文 |
├─ layout_type |
字符串 | 布局类型(如段落、标题等) |
├─ region_id |
整数 | 区域唯一标识 |
├─ translated_text |
字符串 | 该区域英文文本对应的目标语言翻译(英文子集无此字段) |
vqa.json |
结构 | 视觉问答标注,包含以下子字段 |
├─ questions |
列表 | 关于该图像的问题列表 |
│ ├─ answer |
字符串 | 正确答案 |
│ ├─ options |
字符串列表 | 候选选项 |
│ ├─ question |
字符串 | 问题文本 |
│ ├─ type |
字符串 | 问题类型 |
数据划分与大小
所有子集仅提供 train 一个划分,每个子集包含 45,735 个示例。各语言子集的大小(以字节为单位)对比如下(按大小降序):
| 语言 | 数据集大小(字节) | 下载大小(字节) |
|---|---|---|
| ru | 44,510,980,243 | 40,981,126,526 |
| ml | 44,484,045,110 | 41,486,205,192 |
| de | 43,560,050,637 | 40,214,753,809 |
| ta | 43,202,258,433 | 40,161,750,777 |
| kn | 42,756,469,883 | 39,726,502,251 |
| fr | 42,041,691,546 | 38,585,494,503 |
| it | 41,910,804,470 | 38,451,788,872 |
| es | 41,298,697,550 | 37,518,697,055 |
| or | 41,357,857,942 | 38,323,671,608 |
| hi | 40,725,011,127 | 37,592,601,136 |
| en | 40,341,644,513 | 37,492,877,638 |
| sa | 40,503,563,888 | 37,345,327,352 |
| bn | 40,197,529,965 | 37,080,372,202 |
| pa | 39,812,643,165 | 36,707,388,972 |
| mr | 39,057,695,885 | 35,882,976,729 |
| gu | 38,668,362,592 | 35,597,322,238 |
| te | 未完全给出 | 有待补充 |
| ja | 36,080,909,756 | 32,519,562,806 |
| ko | 36,386,121,775 | 33,123,200,769 |
| ar | 32,251,897,661 | 27,973,653,719 |
标签与关键词
数据集标注了丰富的标签,涵盖以下领域:OCR、多语种平行语料、跨语言、文档AI、文档理解、文档分析、Indic语言、低资源语言、视觉语言模型(VLM)、视觉问答(VQA)、布局分析、边界框、合成数据、检索等。
相关链接
- 数据集主页:https://huggingface.co/datasets/Cognitive-Lab/NayanaOCR_Corpus_2025
- 代码/论文引用标识(Papers with Code):nayana-ocr