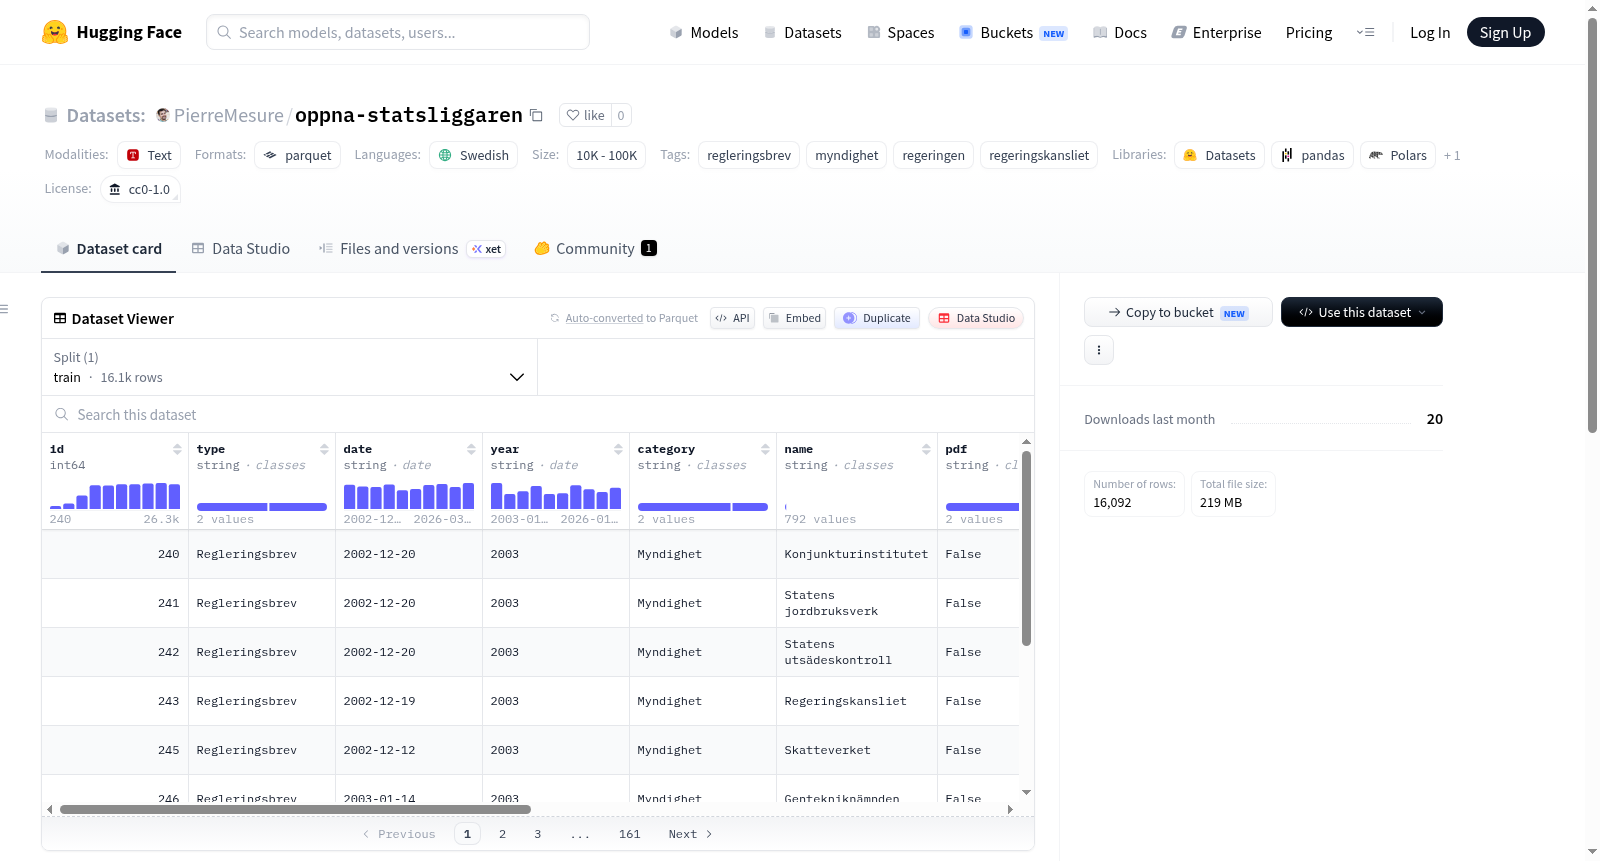
oppna-statsliggaren
收藏资源简介:
Öppna Statsliggaren 是一个包含瑞典政府向其下属政府机构下达的任务指令信(regleringsbrev)的数据集。这些指令信以原始HTML格式从瑞典国家行政署(Statskontoret)的官方网站Statsliggaren页面抓取而来,并通过托管在Github上的爬虫工具每日自动更新。数据集提供了每封信件的元数据列表以及相关附件的列表。在数据处理方面,原始HTML内容首先被清理并转换为更统一、精简且尽可能保持原意的XHTML版本,随后进一步转换为(存在信息损失的)Markdown版本。因此,该数据集最终包含了每封信件的三种格式版本(原始HTML、XHTML和Markdown)及其对应的元数据。数据集规模在1万到10万条记录之间,适用于自然语言处理、政府文件分析、信息公开研究等任务。用户可以通过HuggingFace工具灵活地下载和加载数据子集,例如仅选择ID和Markdown内容字段,而无需将整个数据集载入内存。
Öppna Statsliggaren is a dataset consisting of official mandate letters (regleringsbrev) issued by the Government of Sweden to its subordinate government agencies. These letters were scraped from the official Statsliggaren page of the Swedish National Administrative Agency (Statskontoret) in their raw HTML format, and are automatically updated daily via a crawler tool hosted on GitHub. The dataset provides a list of metadata and associated attachments for each letter. In terms of data processing, the raw HTML content is first cleaned and converted into a unified, streamlined XHTML version that preserves the original intent as much as possible, then further converted to a Markdown version with some information loss. Consequently, the dataset ultimately includes three format variants (raw HTML, XHTML, and Markdown) for each letter alongside their corresponding metadata. The dataset contains between 10,000 and 100,000 records, and is suitable for tasks including natural language processing (NLP), government document analysis, and information disclosure research. Users can flexibly download and load data subsets via Hugging Face tools; for example, they can select only the ID and Markdown content fields without loading the entire dataset into memory.
Öppna Statsliggaren 数据集概述
数据集基本信息
- 许可证: CC0-1.0(公共领域)
- 语言: 瑞典语
- 数据集大小: 10,000 到 100,000 条记录
- 数据集名称: Öppna Statsliggaren
数据集内容
该数据集包含瑞典政府向其政府机构发出的任务信函(letters of missions)。这些信函以原始HTML格式从Statskontoret的网站获取,数据通过每晚在GitHub上运行的爬虫程序收集。
数据格式与版本
数据集中包含同一内容的三种版本及其元数据:
- 原始HTML版本:从网站直接获取的原始格式
- XHTML版本:经过清洗,转为更一致、最小化的XHTML格式(力求无损转换)
- Markdown版本:从XHTML转换而来(有损转换)
附加资源
GitHub仓库中发布了所有信函和附件的列表及其元数据:
- 信函列表: https://flatgithub.com/civictechsweden/oppna-statsliggaren?filename=letters.csv
- 附件列表: https://flatgithub.com/civictechsweden/oppna-statsliggaren?filename=attachments.csv
使用说明
由于需要下载完整数据集,即使只需部分列或行也无法按需选择。但可以使用HuggingFace的Python库加载指定列的子集,避免将所有数据加载到内存中。示例代码如下:
python path = hf_hub_download( repo_id="PierreMesure/oppna-statsliggaren", repo_type="dataset", filename="letters.parquet", table = pq.read_table(path, columns=["id", "md"] )
df = table.to_pandas()