
遇见数据集

open-llm-leaderboard/details_lemon-mint__gemma-ko-7b-instruct-v0.62

收藏
Hugging Face2024-04-03 更新2024-06-11 收录
官方服务:

资源简介:

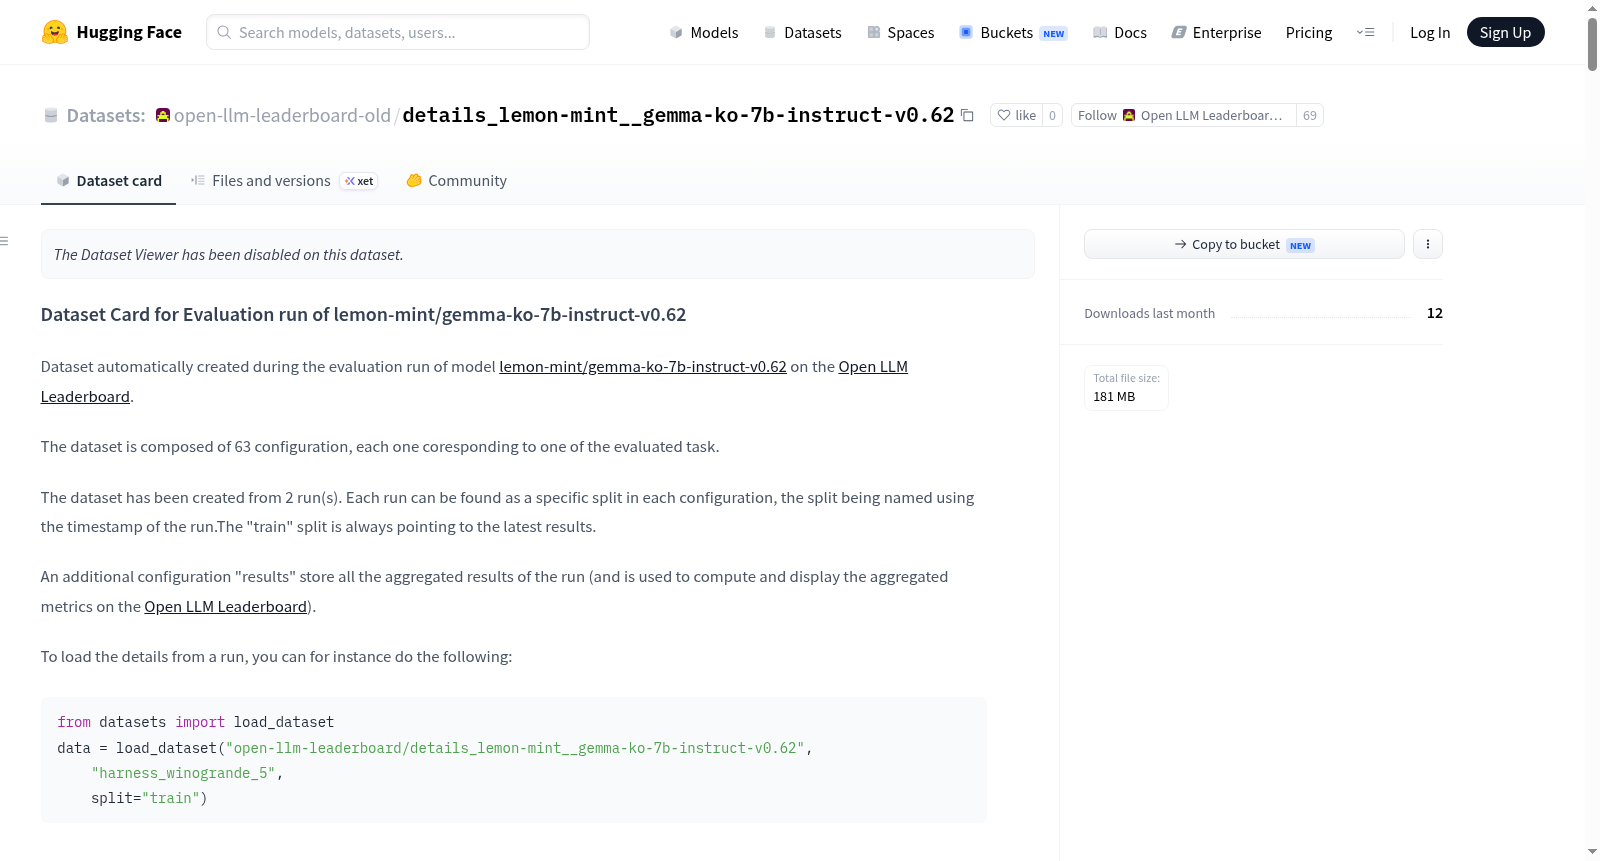
该数据集是在模型 lemon-mint/gemma-ko-7b-instruct-v0.62 在 Open LLM Leaderboard 上的评估运行期间自动创建的。数据集由 63 个配置组成,每个配置对应一个被评估的任务。数据集是从 2 次运行中生成的,每次运行在每个配置中表示为特定的分割,train 分割始终指向最新的结果。一个名为 results 的额外配置存储了所有运行的聚合结果,用于计算和显示 Open LLM Leaderboard 上的聚合指标。README 还提供了如何使用 Python 中的 datasets 库加载运行详情的示例。

该数据集是在模型 lemon-mint/gemma-ko-7b-instruct-v0.62 在 Open LLM Leaderboard 上的评估运行期间自动创建的。数据集由 63 个配置组成,每个配置对应一个被评估的任务。数据集是从 2 次运行中生成的,每次运行在每个配置中表示为特定的分割,train 分割始终指向最新的结果。一个名为 results 的额外配置存储了所有运行的聚合结果,用于计算和显示 Open LLM Leaderboard 上的聚合指标。README 还提供了如何使用 Python 中的 datasets 库加载运行详情的示例。

提供机构:
open-llm-leaderboard
原始信息汇总

数据集概述

数据集名称

  • pretty_name: Evaluation run of lemon-mint/gemma-ko-7b-instruct-v0.62

数据集创建

数据集组成

  • 配置数量: 63个配置,每个配置对应一个评估任务。
  • 数据来源: 数据集由2次运行创建,每次运行对应一个特定分割,分割名称使用运行的时间戳命名。
  • 额外配置: 一个名为"results"的配置存储了所有运行的聚合结果,用于计算和显示聚合指标。

数据加载示例

python from datasets import load_dataset data = load_dataset("open-llm-leaderboard/details_lemon-mint__gemma-ko-7b-instruct-v0.62", "harness_winogrande_5", split="train")

最新结果

  • 最新结果来自2024-04-03T13:31:01.310721的运行,包含多个任务的评估数据。

数据集配置详情

配置列表

  • config_name: harness_arc_challenge_25
  • config_name: harness_gsm8k_5
  • config_name: harness_hellaswag_10
  • config_name: harness_hendrycksTest_5

每个配置包含多个数据文件,每个文件对应不同的运行时间戳,以及一个指向最新结果的"latest"分割。
搜集汇总
数据集介绍
open-llm-leaderboard/details_lemon-mint__gemma-ko-7b-instruct-v0.62 数据集图片
构建方式
在大型语言模型评估领域,Open LLM Leaderboard 提供了一个标准化的评测框架。该数据集专为记录 lemon-mint/gemma-ko-7b-instruct-v0.62 模型在 Open LLM Leaderboard 上的评估过程而自动生成。数据集构建基于两次独立的评估运行,每次运行的结果被组织为独立的 splits,并以运行时间戳命名。数据集包含 63 个配置,每个配置对应一个被评估的任务。特别的,'train' split 始终指向最新一次运行的结果,而一个名为 'results' 的额外配置则存储了所有评估运行的聚合指标,用于在 Leaderboard 上计算和展示最终的模型性能。
特点
该数据集的核心特征在于其结构化的评估记录方式。它细致地捕捉了模型在多项任务上的表现,涵盖 ARC Challenge、HellaSwag、GSM8K、TruthfulQA、Winogrande 以及涵盖 57 个学科的 MMLU 基准测试。每个任务配置下,不同时间戳的 splits 忠实记录了模型性能的演进,便于进行纵向比较。数据集中不仅存储了每项任务的准确率(acc)及其标准误差,还包含了如 acc_norm、mc1、mc2 等精细化指标,为深入研究模型在不同维度上的能力提供了丰富的数据支撑。
使用方法
研究人员可通过 Hugging Face 的 datasets 库便捷地加载该数据集。加载时需指定目标配置名称(例如 'harness_winogrande_5')以及所需的 split(如 'train' 以获取最新结果)。加载后的数据可直接用于复现 Leaderboard 上的评估结果,或进行更细致的错误分析。对于希望追踪模型性能变化的用户,可以通过选择特定的时间戳 split 来访问历史评估数据。此外,'results' 配置提供了所有任务的聚合指标,方便进行快速的模型性能概览与横向对比。
背景与挑战
背景概述
随着大语言模型在自然语言处理领域的飞速发展,如何系统性地评估模型在多样化任务中的表现成为研究焦点。在此背景下,Hugging Face团队于2024年推出了Open LLM Leaderboard,旨在为开源语言模型提供统一的性能基准。本数据集正是该排行榜对lemon-mint团队开发的gemma-ko-7b-instruct-v0.62模型进行评测的产物,由Clementine Fourrier等人主导创建。该模型基于Google的Gemma架构,针对韩语指令进行了微调,核心研究问题在于衡量其在常识推理、数学运算、知识问答等63项子任务上的综合能力。该数据集通过自动生成评测细节,为社区提供了可复现的评估范例,推动了多语言、多领域模型评测的标准化进程,对后续韩语大模型的优化与比较产生了重要影响。
当前挑战
当前该数据集面临的挑战主要体现在两方面。在领域问题层面,它旨在解决多任务语言理解与生成能力的评估难题,例如模型在ARC挑战集、HellaSwag、GSM8K等任务上的准确率差异显著,尤其是在高难度数学与科学推理任务中表现波动较大,反映出模型在复杂逻辑与领域知识整合上的局限。在构建过程中,挑战则源于评测的自动化和标准化:需确保63个配置项与多次运行结果的一致性,处理不同时间戳分片的数据对齐,以及从原始评测日志中精准提取并聚合指标,避免因任务覆盖不全或统计误差导致排名偏差。此外,如何确保评测公平性并抵御潜在的过拟合风险,也是持续存在的技术难点。
常用场景
经典使用场景
在大语言模型评估领域,该数据集作为Open LLM Leaderboard的标准化评测产物,承载了gemma-ko-7b-instruct-v0.62模型在63项任务上的细粒度表现数据。研究者可借助其分层配置结构,针对ARC挑战集、HellaSwag常识推理、GSM8K数学解题及MMLU多学科知识等经典基准,精准提取模型在特定维度的推理与知识掌握情况。通过加载不同时间戳的评测分片,还能纵向追踪模型迭代过程中的能力演变轨迹。
解决学术问题
该数据集系统性地解决了大语言模型能力评估中缺乏标准化细粒度记录的问题。学术研究长期面临模型表现难以复现、跨任务对比维度混乱的困境,而此数据集通过统一的任务配置与结果聚合机制,为模型在常识推理、数学计算、多领域知识等维度的泛化能力提供了可量化的参照系。其贡献在于构建了从原始推理日志到宏观指标的完整证据链,推动了模型评估的透明化与可解释性研究。
衍生相关工作
该数据集催生了一系列关于模型能力诊断与对比分析的研究工作。后续研究者基于其提供的任务级评测结果,发展了针对特定能力短板(如形式逻辑、道德推理)的增强训练策略。同时,数据集的分时快照特性支持了模型进化动力学分析,衍生出关于训练数据配比与能力涌现关系的实证研究。这些工作共同深化了我们对大语言模型能力边界与增长规律的理解。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

