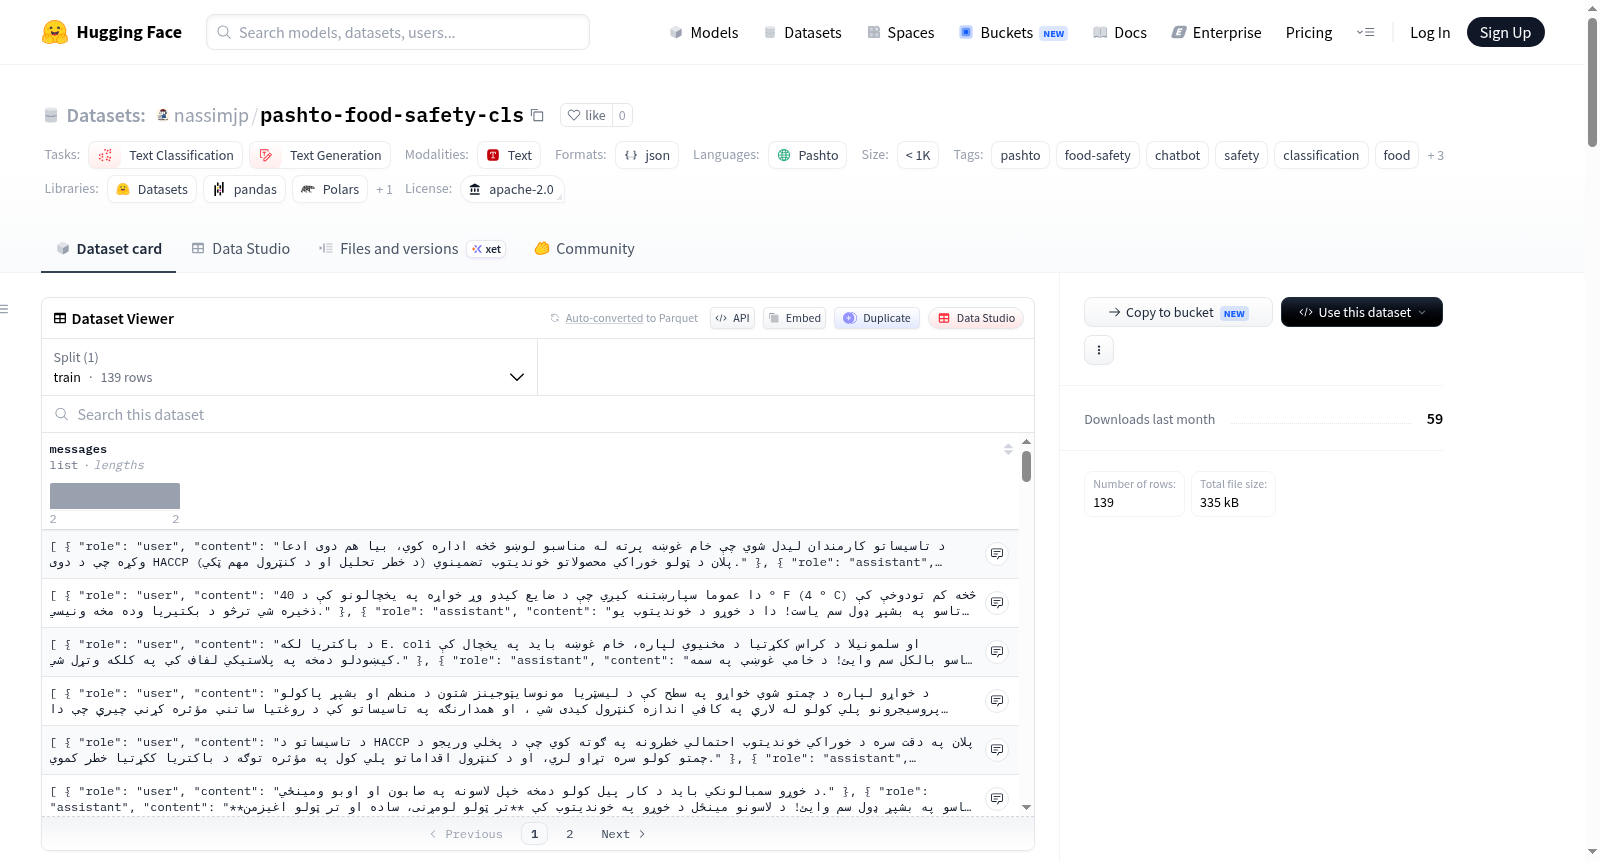
pashto-food-safety-cls
收藏资源简介:
Pashto Food Safety CLS 是一个以普什图语(Pashto)编写的食品安全数据集,专注于食品卫生、污染预防、安全食品处理等主题。该数据集包含用户与助手之间的对话对,采用标准的 messages 结构(JSON/JSONL 格式),适用于文本分类、对话微调、指令微调以及大语言模型(LLM)的训练。数据规模较小(少于1K样本),当前处于早期实验阶段,并计划在未来扩展更多场景、分类标签、HACCP相关类别、食物污染案例等。数据集可用于构建普什图语食品安全聊天机器人、食品卫生助手、安全导向的LLM微调、普什图语指令微调、食品安全问答系统、分类实验以及教育AI系统。该数据集仅供教育和AI研究使用,不能替代专业的食品安全法规、检查程序或医疗建议。许可证为 Apache-2.0。
Pashto Food Safety CLS is a food safety dataset written in Pashto, focusing on topics such as food hygiene, contamination prevention, and safe food handling. The dataset contains conversation pairs between users and assistants, using the standard messages structure (JSON/JSONL format). It is suitable for text classification, dialogue fine-tuning, instruction fine-tuning, and training large language models (LLMs). The dataset is small (fewer than 1K samples), currently in the early experimental stage, and plans to expand more scenarios, classification labels, HACCP-related categories, food contamination cases, etc. in the future. It can be used to build Pashto food safety chatbots, food hygiene assistants, safety-oriented LLM fine-tuning, Pashto instruction fine-tuning, food safety question-answering systems, classification experiments, and educational AI systems. The dataset is intended for educational and AI research purposes only and cannot replace professional food safety regulations, inspection procedures, or medical advice. The license is Apache-2.0.
🥗 Pashto Food Safety CLS 数据集详情
数据集简介
Pashto Food Safety CLS 是一个专注于食品安全、食品卫生、污染预防和食品处理安全的普什图语(Pashto)数据集,旨在支持普什图语自然语言处理(NLP)和大型语言模型(LLM)的训练与研究。
数据集采用 Apache-2.0 许可证,目前处于实验性阶段,规模较小(n<1K),但计划持续扩展。
基本信息
| 属性 | 详情 |
|---|---|
| 语言 | 普什图语(Pashto, ps) |
| 格式 | JSON / JSONL |
| 结构 | messages(对话式结构) |
| 任务类型 | 文本分类 / 文本生成 |
| 领域 | 食品安全与卫生 |
| 许可证 | Apache-2.0 |
| 状态 | 实验性 / 持续扩充中 |
内容覆盖范围
数据集涵盖以下食品安全相关主题:
- 🍖 生肉的安全处理
- 🦠 细菌污染
- 🔄 交叉污染
- ❄️ 冷藏与安全温度
- 🧼 食品卫生
- 🥘 安全的食品制备
- 📋 HACCP 原则
- ⚠️ 食品安全风险
- 🧑🍳 食品从业人员的规范操作
- 🥬 易腐食品的储存
数据格式说明
数据集采用标准的对话式 messages 结构,每条样本包含用户提问与助手回答:
json { "messages": [ { "role": "user", "content": "خامه غوښه څنګه په خوندي ډول وساتو؟" }, { "role": "assistant", "content": "خامه غوښه باید په پاک او تړل شوي لوښي کې وساتل شي او له نورو تیار خوړو څخه جلا وساتل شي." } ] }
该格式适用于对话式微调(conversational fine-tuning),并可适配现代 LLM 训练流程。
预期用途
该数据集可用于以下场景:
- 普什图语食品安全聊天机器人
- 食品卫生助手
- 面向安全领域的 LLM 微调
- 普什图语指令微调(instruction tuning)
- 食品安全问答系统
- 分类与安全实验
- 教育类 AI 系统
- 普什图语 NLP 研究
重要说明
⚠️ 该数据集仅供教育和 AI 研究目的使用,不应替代专业的食品安全法规、检验程序、医疗建议或来自合格食品安全机构的指导。食品安全建议可能因国家和监管体系而异。
数据集状态与未来规划
当前版本为早期阶段的小规模发布,作为构建更大普什图语食品安全数据集的基础。
未来版本可能包含:
- 更多食品安全场景
- 正反示例
- 分类标签
- HACCP 相关类别
- 食品污染案例
- 储存温度场景
- 餐厅与厨房安全
- 食源性疾病预防
- 更多自然的普什图语对话
技术使用方式
加载数据集
python from datasets import load_dataset
dataset = load_dataset("nassimjp/pashto-food-safety-cls") print(dataset)
访问示例
python example = dataset["train"][0] print(example["messages"])
作者信息
- 作者:Nasibullah Nassim (Nassim JP)
- 机构:Pashto AI Research & Development, Japan 🇯🇵
引用格式
bibtex @misc{nassimjp_pashto_food_safety_cls_2026, author = {Nasibullah Nassim}, title = {Pashto Food Safety CLS}, year = {2026}, publisher = {Hugging Face Datasets}, url = {https://huggingface.co/datasets/nassimjp/pashto-food-safety-cls} }
数据集链接
🔗 Hugging Face 地址:https://huggingface.co/datasets/nassimjp/pashto-food-safety-cls