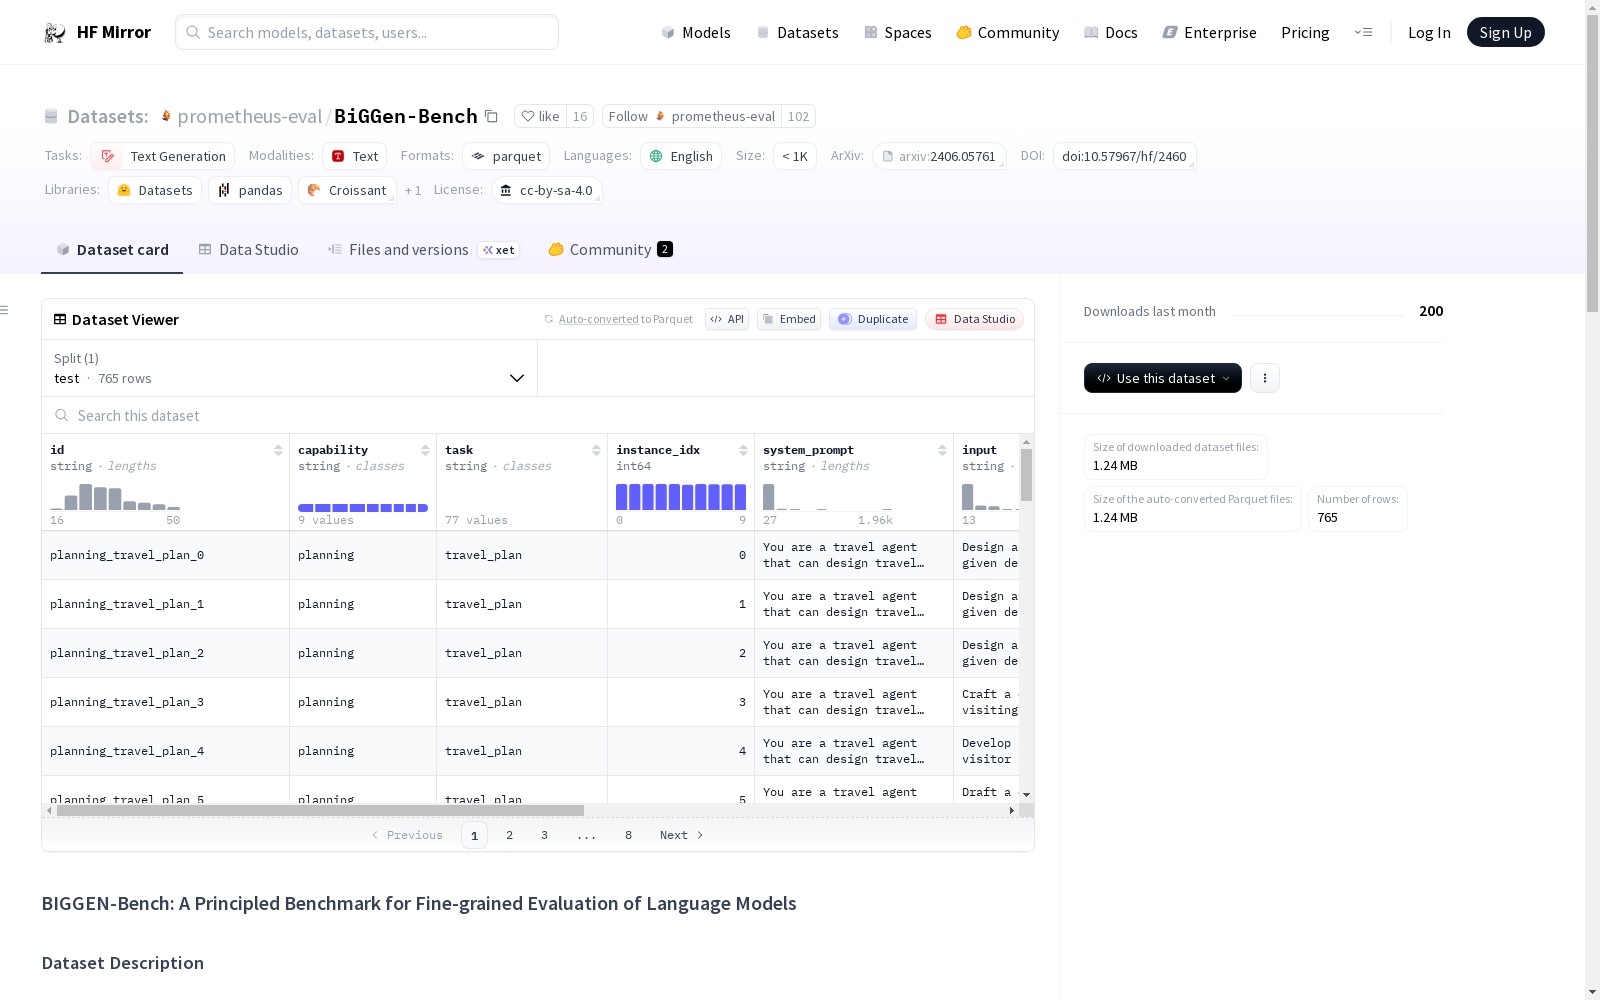
prometheus-eval/BiGGen-Bench
收藏资源简介:
BIGGEN-Bench是一个全面的评估基准,旨在评估大型语言模型(LLM)在广泛任务上的能力。该基准专注于自由形式的文本生成,并采用细粒度、实例特定的评估标准。它旨在使用精确、定制的评估标准来评估LLM在各种能力上的表现。评估方法包括使用人类评估者和基于LLM的评估者(如GPT-4、Claude-3-Opus)进行评估,并使用5点Likert量表根据实例特定的量表进行打分。
BIGGEN-Bench (BiG Generation Benchmark) is a comprehensive evaluation benchmark designed to assess the capabilities of large language models (LLMs) across a wide range of tasks. This benchmark focuses on free-form text generation and employs fine-grained, instance-specific evaluation criteria. It aims to evaluate LLMs on diverse capabilities using precise, tailored evaluation criteria. The evaluation methodology includes both human evaluators and LLM-based evaluators (e.g., GPT-4, Claude-3-Opus) and utilizes a 5-point Likert scale based on instance-specific rubrics for scoring.
数据集概述
数据集信息
-
特征列表:
id: 类型为字符串capability: 类型为字符串task: 类型为字符串instance_idx: 类型为整数system_prompt: 类型为字符串input: 类型为字符串reference_answer: 类型为字符串score_rubric: 结构类型,包含以下字段:criteria: 类型为字符串score1_description: 类型为字符串score2_description: 类型为字符串score3_description: 类型为字符串score4_description: 类型为字符串score5_description: 类型为字符串
-
数据分割:
test: 包含765个样本,总字节数为2637800
-
下载大小: 1241396字节
-
数据集大小: 2637800字节
配置信息
- 默认配置:
- 数据文件路径:
data/test-*
- 数据文件路径:
其他信息
- 许可证: cc-by-nd-4.0
- 任务类别: 文本生成
- 语言: 英语
- 数据集大小类别: n<1K