
商用车新增运营数据
收藏官方服务:
资源简介:
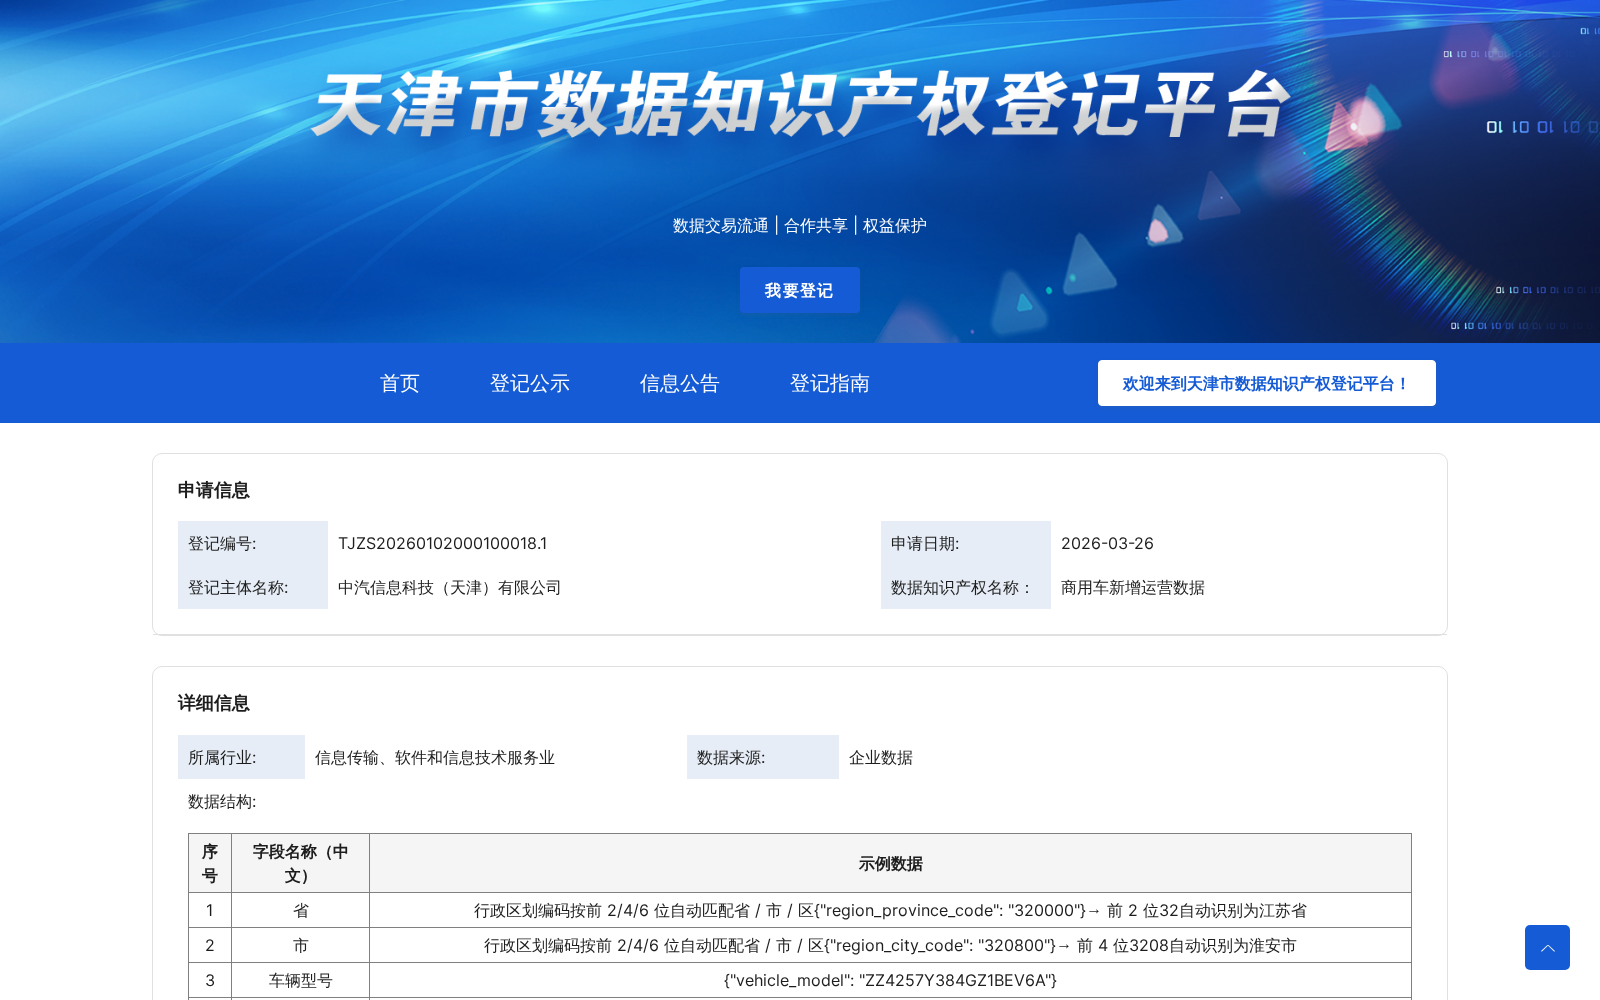
数据抽取(Extract)从源系统采集原始指标数据,包含VIN,发动机号,车辆型号,区划代码等字段。数据转换(Transform)对原始指标进行清洗,去除空值、异常值、重复记录;计算衍生指标,如品系,车型分类,细分场景等聚合数据;按业务维度进行归类、聚合与汇总,形成标准指标宽表。数据加载(Load)将清洗、转换后的标准化指标数据,加载至目标数据库表,用于统计分析与报表展示。本 ETL 流程采用规则驱动的数据清洗与聚合算法。主要算法包括:重复数据去重算法、异常值过滤算法(阈值判定)、指标聚合算法(平均值计算)、数据格式标准化算法。本数据集不包含可识别自然人的个人信息(如姓名、手机号、身份证号、地址、设备唯一标识等)。若后续引入用户标识、设备 ID 等敏感数据,将执行以下安全处理:去标识化:删除 / 脱敏直接标识符;匿名化:过不可逆哈希算法处理敏感字段,确保无法反向还原原始信息;数据不可逆:所有脱敏算法均为单向不可逆,杜绝通过模型或算法还原原始数据。算法规则": {"algorithm_rule": "行政区划编码按前2/4/6位自动匹配省/市/区;车辆型号含BEV则自动判定为纯电动车型,牵引类关键词自动归类为牵引汽车"}}}。{"algorithm_rule": "总质量≥25吨自动归类为重卡;电池容量≥500kWh标记为区隔标记为长续航纯电"}}}。
提供机构:
中汽信息科技(天津)有限公司创建时间:
2026-03-26
搜集汇总
数据集介绍
背景与挑战
背景概述
该数据集来源于企业,每月更新约1.5万条记录,通过ETL流程对车辆VIN、型号、区域等原始字段进行清洗、去重与标准化处理,并基于规则自动分类(如按行政区划编码匹配区域、按车辆型号识别纯电动或牵引车、按总质量归类重卡等)。数据主要用于汽车及物流行业分析新增重卡运营情况,支持按区域、品牌等维度进行市场景气度研究,且不包含任何可识别自然人的个人信息。
以上内容由遇见数据集搜集并总结生成


