
遇见数据集

jAEhEEkIM/operationbench-baf-raw

收藏
Hugging Face2026-05-28 更新2026-05-31 收录
官方服务:

资源简介:

这是一个用于OperationBench可重复性研究的银行账户欺诈数据集原始快照,源自NeurIPS 2022的Bank Account Fraud Dataset Suite(BAF)。数据集包含六个原始CSV文件(Base.csv和Variant I-V.csv),用于表格分类任务,专注于欺诈检测。数据是合成的,具有概念漂移特性,适用于非商业研究。数据集规模在100万到1000万条记录之间,旨在减少Kaggle下载障碍,支持OperationBench实验。上游来源为Kaggle数据集sgpjesus/bank-account-fraud-dataset-neurips-2022,遵循CC BY-NC-SA 4.0许可证。

This is an unofficial raw-data snapshot of the Bank Account Fraud Dataset Suite (BAF, NeurIPS 2022) for OperationBench reproducibility. It contains six raw CSV files (Base.csv and Variant I-V.csv) for tabular classification tasks, focusing on fraud detection. The data is synthetic with concept drift, intended for non-commercial research. The dataset size is between 1M and 10M records, designed to reduce Kaggle download friction for OperationBench experiments. The upstream source is the Kaggle dataset sgpjesus/bank-account-fraud-dataset-neurips-2022, licensed under CC BY-NC-SA 4.0.
提供机构:
jAEhEEkIM
搜集汇总
数据集介绍
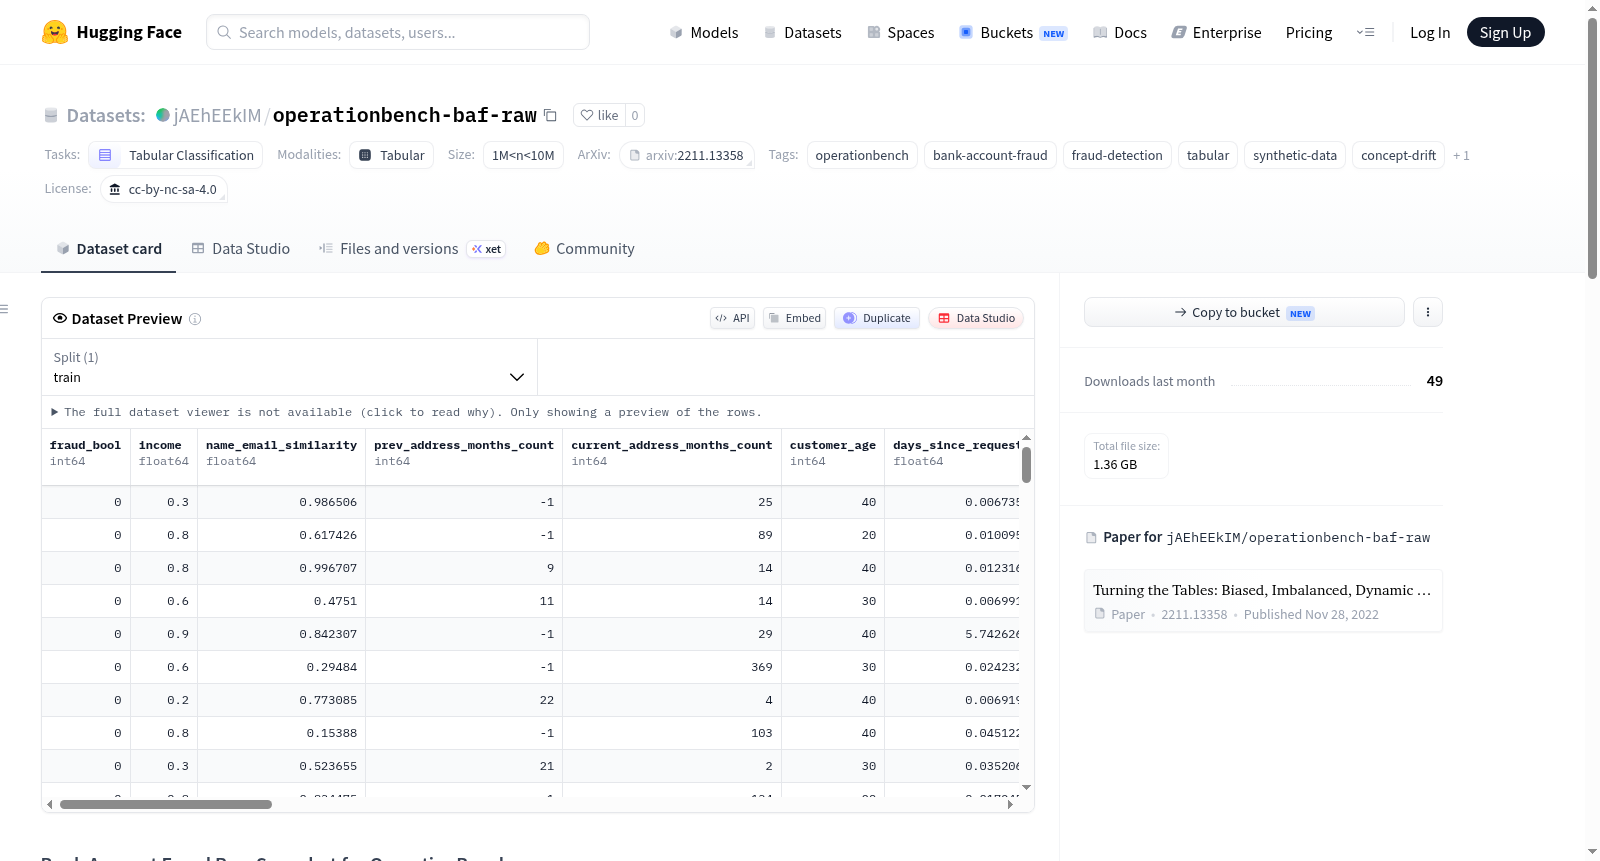
jAEhEEkIM/operationbench-baf-raw 数据集图片
构建方式
OperationBench-BAF-Raw数据集源自NeurIPS 2022上发布的银行账户欺诈检测数据集套件(Bank Account Fraud Dataset Suite, BAF),其上游数据存储于Kaggle平台。该原始快照未经任何场景生成、过滤、拆分或特征变换处理,直接以六个原始CSV文件的形式呈现,分别为Base.csv及Variant I至Variant V。这些文件旨在消除用户从Kaggle下载数据时遇到的个体摩擦,为OperationBench实验的可重复性提供统一且便捷的数据入口。研究者可通过Hugging Face的`huggingface_hub`库,执行特定命令将CSV文件下载至本地指定目录,从而复现OperationBench所需的原始数据目录结构。
特点
该数据集具有鲜明的结构化表格分类特征,专注于银行账户欺诈检测这一金融安全核心任务。其样本规模介于一百万至一千万之间,属于大规模数据集,能够支撑稳健的模型训练与评估。尤为突出的是,该数据集模拟了现实场景中的概念漂移(concept drift)现象,使得模型在动态环境下的泛化能力成为评价焦点。此外,数据集以CC BY-NC-SA 4.0许可协议发布,仅限非商业用途,并要求使用者保持署名、非商业性使用及相同方式共享,体现了对原始研究伦理与版权的尊重。
使用方法
该数据集专为OperationBench研究框架设计,用于执行非商业目的的欺诈检测实验。使用时,用户需将六个原始CSV文件存放于`data/raw/bank-account-fraud-neurips-2022/`路径下,OperationBench将在本地生成评估者私有的场景清单,包含隐藏的时间调度、未来行、预言轨迹以及私有评估输出,这些资源对智能体(agent)完全不可见。推荐通过运行`uv run hf download`命令并指定固定修订版本号的方式,确保数据来源的精确可复现。研究者应遵循上游许可要求,在派生工作中注明原始作者并链接源数据集。
背景与挑战
背景概述
在金融科技迅猛发展的当下,在线银行账户欺诈检测已成为维护金融安全的核心议题。为了评估和推动相关机器学习模型的鲁棒性与公平性,Feedzai研究团队与多位学者合作,于2022年在NeurIPS上发布了Bank Account Fraud Dataset Suite (BAF),由Sergio Jesus等人在《Turning the Tables: Biased, Imbalanced, Dynamic Tabular Datasets for ML Evaluation》论文中系统阐述。该数据集以表格形式模拟真实世界中银行账户开户申请时的欺诈场景,包含六种精心设计的变体,旨在覆盖数据偏差、类别不平衡、概念漂移等复杂动态条件。operationbench-baf-raw作为BAF的原始快照,专为OperationBench评估框架提供可复现的基础数据,免除了用户从Kaggle下载时可能遇到的摩擦,从而推动了非商业环境下欺诈检测研究的严谨性与可重复性。这一资源在金融机器学习领域具有重要影响,为后续方法比较和模型鲁棒性分析奠定了标准化基准。
当前挑战
该数据集所解决的核心领域挑战在于银行账户欺诈检测中普遍存在的多重困境:第一,数据天然呈现高度不平衡,真实欺诈样本极为稀疏,极易导致模型对少数类忽略。第二,训练与部署之间存在概念漂移,欺诈模式随时间演化,使静态模型迅速失效。第三,数据中隐含的群体偏差(如地域、年龄等)可能诱发算法歧视,损害公平性。在构建过程中,研究团队面临的关键技术挑战包括:如何通过合成生成技术在不泄露隐私的前提下保留真实数据的统计特性与非线性相关性;如何设计多个变体以分别模拟不同的现实瓶颈(如时序漂移、标签噪声),同时保持变体间的可比性;以及如何通过原始快照形式确保下游评估框架(如OperationBench)能独立生成隐蔽的评估调度,防止过拟合。这些挑战共同塑造了该数据集作为动态、偏差敏感评估工具的独特价值。
常用场景
经典使用场景
在金融风控与欺诈检测研究领域,Bank Account Fraud Raw Snapshot for OperationBench(简称BAF)数据集作为经典的表格型分类基准,被广泛用于评估和比较各种监督学习模型在银行账户欺诈检测任务上的表现。该数据集通过精心设计的多个变体(Variant I至V),模拟了真实世界中因概念漂移、类别不平衡和特征偏差而产生的复杂场景。研究者利用这些原始CSV文件,能够系统地测试模型在动态环境下的鲁棒性与泛化能力,从而推动欺诈检测算法向更贴近实际部署的方向发展。
解决学术问题
BAF数据集的核心学术贡献在于填补了现有表格分类基准在动态非平稳环境下的评价空白。传统的数据集往往假设训练与测试数据分布一致,而BAF通过引入随时间变化的概念漂移和多种偏差结构,使得研究者可以深入探究模型在数据分布发生渐进或突变时的适应能力。该数据集系统性地解决了如何在类别极度不平衡、特征相关性和环境噪声不断演进的情境下保持分类性能的难题,为评估选择性分类器、在线学习算法以及域适应技术提供了标准化的实验平台,显著提升了欺诈检测学术研究的可复现性和可比性。
衍生相关工作
BAF数据集衍生了一系列具有影响力的学术工作,其中最典型的是OperationBench——一个面向操作环境动态评测的基准框架,它借助BAF的原始数据生成私有的场景清单,用于量化智能体在隐藏日程与不可见未来数据上的决策表现。此外,围绕BAF数据套件,研究者提出了针对概念漂移感知的集成学习方法、基于元学习的自适应阈值策略,以及结合图神经网络的账户关联风险传播模型。这些工作不仅深化了对非平稳表格数据建模的理论理解,也催生了诸如时序特征漂移检测工具和自动化机器学习流水线等开源实践,进一步推动了动态风控研究的生态建设。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

