
遇见数据集

UniParser/RxnBench-Doc

收藏
Hugging Face2026-05-18 更新2026-01-03 收录
官方服务:

资源简介:

RxnBench-Doc是一个文档级问答(DocQA)基准,包含540个多项选择题,旨在评估博士级别的有机化学反应在文本和多模态上下文中的理解能力。所有问题都经过多轮专家评审,以确保清晰性、一致性和科学严谨性。RxnBench-Doc发布了英文和中文两个版本。基准涵盖两种关键任务类型:上下文推理,需要整合来自多模态源(如反应图像、表格和文本)的信息以回答问题;以及结构推理,专注于与分子和Markush结构、反应组分和机制推理相关的问题。评估方法包括将PDF格式文档渲染为144 dpi的图像序列,并将其作为多模态大语言模型(MLLM)的输入,通过模型输出提取最终的多项选择答案并与标准答案进行比较。

RxnBench (FD-QA) is a document-level question answering (DocQA) benchmark comprising 540 multiple-select questions designed to assess PhD-level understanding of organic chemistry reactions in textual and multimodal contexts. All questions underwent multiple rounds of expert review to ensure clarity, consistency, and scientific rigor. RxnBench-Doc is released in both English and Chinese versions. The benchmark covers two key task types: Context Reasoning, which requires integrating information from multimodal sources such as reaction images, tables, and text to answer questions; and Structure Reasoning, which focuses on reasoning questions related to molecular and Markush structures, reaction components, and mechanistic inference. The evaluation involves rendering each PDF format document into images sequence at 144 dpi and using them as inputs to the MLLM, extracting the final multiple-select answer from the model’s raw output and comparing it against the ground truth.
提供机构:
UniParser
搜集汇总
数据集介绍
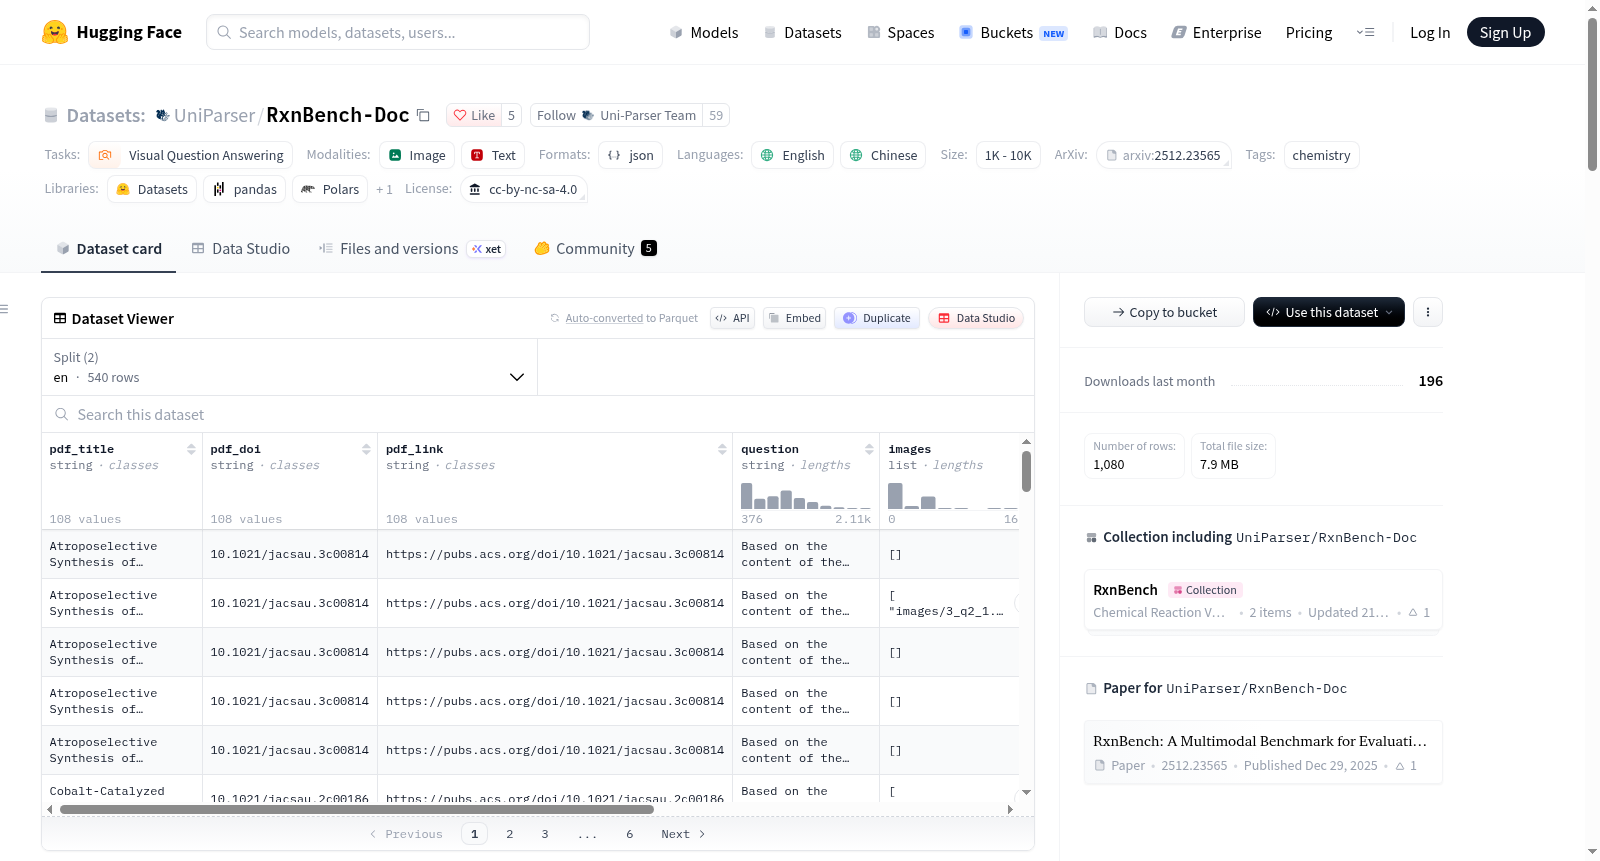
UniParser/RxnBench-Doc 数据集图片
构建方式
面向有机化学反应文献智能理解这一兼具文本与图示信息的前沿领域,RxnBench-Doc的构建围绕文档级多选问答展开。其以化学文献PDF为文档载体,将页面以144 dpi渲染为图像序列,并针对反应图像、表格、文本以及分子与Markush结构等证据设计问题;每题中的<answer>标签作为占位符,与images列表中的对应图像建立关联,从而形成图文交错的多模态样例。全部540道题目历经多轮专家审阅,以保障题面清晰、选项一致与科学严谨,并同步推出英文与中文版本,为化学反应领域多模态评测提供规范化的文档级资源。
特点
立足于有机化学文献中文本、图像与结构式交织呈现的知识形态,RxnBench-Doc呈现出鲜明的文档级与多模态评测特征。该基准包含540道多选题,指向博士层级的有机化学反应理解,覆盖Context Reasoning与Structure Reasoning两类任务:前者要求整合反应图像、表格与文本信息,后者关涉分子及Markush结构、反应组分与机理推断。数据集提供英文和中文两个版本,所有题目经过多轮专家审核,并以default配置下的en与zh分片发布,任务类别为visual-question-answering,适用于考察模型在长文档与跨模态证据中的综合推理能力。
使用方法
面向多模态大模型在化学文献中的推理能力检验,RxnBench-Doc的使用遵循文档图像序列与交错视觉语言提示相结合的流程。PDF格式文档以144 dpi渲染为图像序列并作为模型输入;问题中的<answer>标签由images列表中对应图像替换,构成图文交错提示。模型原始输出经GPT-4o抽取最终多选答案A–E,其中“None of the above”映射为E;抽取结果与真值比对,缺失或多余选择均记为错误,并分别报告英文与中文版本的绝对准确率。数据文件为rxnbench_doc.en.jsonl与rxnbench_doc.zh.jsonl,相关代码见RxnBench项目仓库。
背景与挑战
背景概述
在化学信息学与多模态学习深度交汇的背景下,RxnBench-Doc作为文档级化学反应文献问答基准于2025年提出,由Li Hanzheng等研究者完成,并获Journal of Chemical Information and Modeling接收。该数据集依托UniParser项目发布,含540道博士级多项选择题,覆盖英文与中文,聚焦有机化学反应文本与多模态语境。其核心研究问题在于评测多模态大模型能否整合反应图像、表格与正文信息,并完成分子结构、Markush结构、反应组分及机理推断等推理。该基准为化学文献理解提供了严格、双语且可持续更新的评价平台,对推动科学文献多模态智能解析具有参考意义。
当前挑战
从化学文献智能解析的难点出发,RxnBench-Doc所应对的领域问题远超单幅反应图像问答,要求模型在文档级语境中贯通图文表信息,理解复杂分子与Markush结构,并进行反应组分识别与机理推断。其构建亦面临多重挑战:题目需达博士级认知深度并经多轮专家审校,以保证清晰性、一致性与科学严谨性;PDF文档须按144 dpi渲染为图像序列,构成交错视觉—语言输入;多项选择答案在缺失或多余选择时均判错,且需保持英中双语等价性。这些因素共同提升了基准的学术门槛与评测难度。
常用场景
经典使用场景
在有机化学反应文献理解与多模态大模型评测深度交汇的背景下,RxnBench-Doc以文档级问答基准的形态,承载了博士级化学反应的文本与视觉综合理解任务。其经典使用场景是将PDF格式文献以144 dpi渲染为图像序列,并以<answer>标签与问题交错拼接,形成视觉—语言提示,要求模型在多选题中整合反应图像、表格与叙述文本,完成上下文推理;同时围绕分子结构、Markush结构、反应组分与机理推断展开结构推理。中英双语版本与540道专家审核题目,使该基准成为衡量多模态模型能否真正读懂化学文献的典型试验场。
衍生相关工作
围绕该基准形成的学术脉络,RxnBench-Doc与同系列的RxnVQA相互呼应,后者将评测粒度聚焦于单张反应图像的视觉问答,前者则扩展至文档级多模态理解,共同构成有机化学反应智能评测的递进式体系。相关论文RxnBench已被Journal of Chemical Information and Modeling接受,并公开代码与榜单,推动后续研究在Gemini、Qwen、GPT等模型上开展可比实验。该基准亦启发文档级化学问答、Markush结构推理与机理推断等方向的延伸工作,为多模态科学文献理解提供了可复用的数据资源与评价范式。
数据集最近研究
最新研究方向
伴随化学文献理解从单图问答迈向文档级多模态推理,RxnBench-Doc正推动有机化学知识获取的评测范式转向兼具文本、反应图像、表格与Markush结构的跨模态整合。该基准以540道专家多轮审校的多选题覆盖中英双语,围绕Context Reasoning与Structure Reasoning考察模型对反应组分、分子结构及机理推断的PhD级理解;其被Journal of Chemical Information and Modeling接收,并持续更新的模型榜单显示,顶尖多模态模型整体准确率仍约五成,结构推理尤为薄弱。此方向为科学文献问答、化学信息抽取与多模态大模型安全评估提供了严格基准,对加速AI辅助化学研究具有标志意义。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

