遇见数据集

mb7419/career-guidance-reddit

收藏
Hugging Face2024-02-04 更新2024-03-04 收录
官方服务:

资源简介:

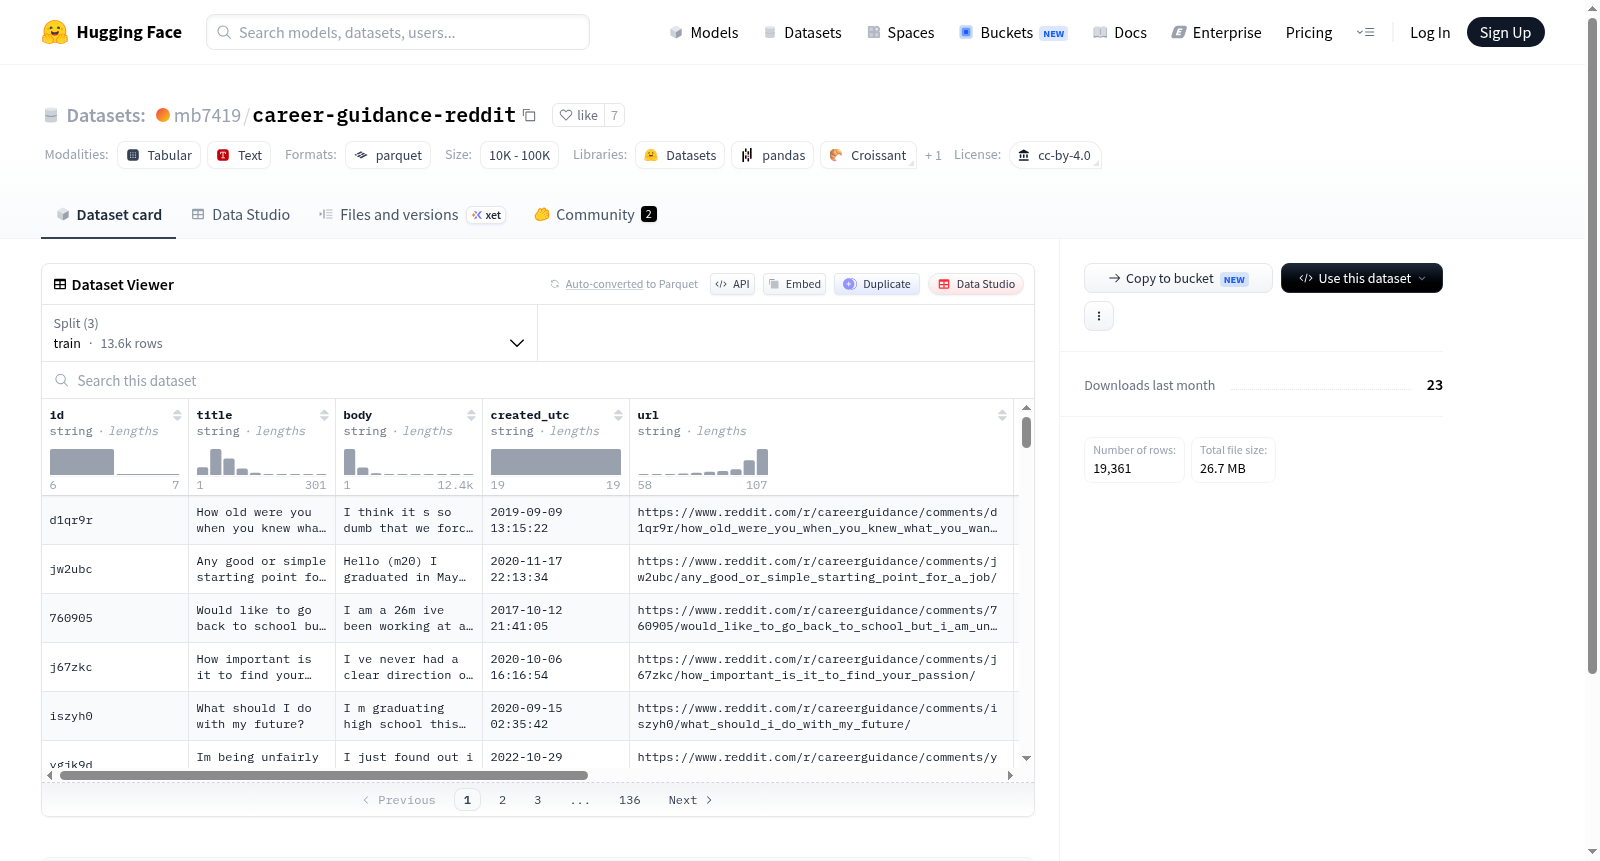
--- license: cc-by-4.0 dataset_info: features: - name: id dtype: string - name: title dtype: string - name: body dtype: string - name: created_utc dtype: string - name: url dtype: string - name: retrieved_on dtype: string - name: question_content dtype: string - name: dominant_topic dtype: int64 - name: dominant_topic_name dtype: string - name: __index_level_0__ dtype: int64 splits: - name: train num_bytes: 32409618 num_examples: 13552 - name: validation num_bytes: 6891421 num_examples: 2904 - name: test num_bytes: 7021155 num_examples: 2905 download_size: 26693366 dataset_size: 46322194 configs: - config_name: default data_files: - split: train path: data/train-* - split: validation path: data/validation-* - split: test path: data/test-* ---

许可证:知识共享署名4.0(CC BY 4.0) 数据集信息: 特征项: - 名称:id,数据类型:字符串 - 名称:title,数据类型:字符串 - 名称:body,数据类型:字符串 - 名称:created_utc,数据类型:字符串(UTC格式创建时间) - 名称:url,数据类型:字符串 - 名称:retrieved_on,数据类型:字符串(UTC格式获取时间) - 名称:question_content,数据类型:字符串 - 名称:dominant_topic,数据类型:64位整数 - 名称:dominant_topic_name,数据类型:字符串 - 名称:__index_level_0__,数据类型:64位整数 数据集划分: - 划分名称:train(训练集),占用字节数:32409618,样本总数:13552 - 划分名称:validation(验证集),占用字节数:6891421,样本总数:2904 - 划分名称:test(测试集),占用字节数:7021155,样本总数:2905 下载总大小:26693366,数据集总存储大小:46322194 配置项: - 配置名称:default(默认配置),数据文件: - 拆分:train(训练集),路径:data/train-* - 拆分:validation(验证集),路径:data/validation-* - 拆分:test(测试集),路径:data/test-*

提供机构:
mb7419
原始信息汇总

数据集概述

许可证

  • 许可证: CC BY 4.0

数据集信息

特征

  • id: 字符串类型
  • title: 字符串类型
  • body: 字符串类型
  • created_utc: 字符串类型
  • url: 字符串类型
  • retrieved_on: 字符串类型
  • question_content: 字符串类型
  • dominant_topic: 整数类型
  • dominant_topic_name: 字符串类型
  • __index_level_0__: 整数类型

数据分割

  • train: 字节数 32409618, 样本数 13552
  • validation: 字节数 6891421, 样本数 2904
  • test: 字节数 7021155, 样本数 2905

数据大小

  • 下载大小: 26693366 字节
  • 数据集大小: 46322194 字节

配置

  • 配置名称: default
  • 数据文件路径:
    • train: data/train-*
    • validation: data/validation-*
    • test: data/test-*
搜集汇总
数据集介绍
mb7419/career-guidance-reddit 数据集图片
构建方式
在职业发展日益多元化的当下,社交媒体平台如Reddit已成为个体寻求职业建议的重要渠道。该数据集基于Reddit社区中与职业指导相关的讨论内容构建,通过系统化的数据采集与清洗流程,最终收录了约1.9万条帖子。每条记录包含帖子的唯一标识符、标题、正文、发布时间、原始链接、抓取时间、用户提出的具体问题、通过主题建模算法自动标注的主导话题编号及对应的话题名称等字段。数据集被划分为训练集(13552条)、验证集(2904条)和测试集(2905条),以支持模型训练与评估。
特点
该数据集的核心特色在于其融合了原始社交媒体文本与经过语义挖掘的结构化标签。其中,'question_content'字段精准提取了发帖者寻求建议的核心问题,而'dominant_topic'与'dominant_topic_name'则通过无监督学习方法揭示了帖子所涉的主要议题,如求职策略、转行困惑或技能提升等。这种双重结构既保留了自然语言的丰富语境,又提供了可量化的分析维度,为研究职业咨询领域的语言模式与话题演化提供了独特的数据基础。
使用方法
研究人员可直接通过Hugging Face Datasets库加载该数据集,指定配置名为'default',并选择所需的划分(train、validation或test)。数据以Parquet格式存储,支持高效的批量读取。典型应用场景包括训练文本分类模型以自动识别职业咨询问题的话题类别,或构建问答系统以生成个性化的职业建议。此外,结合时间戳字段,还可开展职业指导话题流行趋势的时序分析,为就业市场的动态变化提供数据洞察。
背景与挑战
背景概述
在职业发展日益多元化的当代社会,个体在面临教育路径选择与职业规划时,往往需要借助集体智慧与经验分享来做出明智决策。Reddit等社交平台汇聚了大量关于职业困惑、技能转型与行业洞察的讨论,成为研究公众职业认知与决策行为的宝贵数据源。由研究者mb7419于2023年构建的career-guidance-reddit数据集,系统采集了Reddit社区中与职业指导相关的海量帖文,涵盖标题、正文、时间戳及通过主题建模提取的主导话题标签。该数据集的核心研究问题在于如何从非结构化的社交媒体文本中自动识别与归纳职业咨询的核心议题,从而为自然语言处理领域中的主题识别与对话系统提供基准。数据集包含近两万条标注样本,划分为训练、验证与测试集,其发布为职业咨询领域的人机交互研究、推荐系统开发以及社会网络分析提供了坚实的语料基础,显著推动了相关领域的实证探索。
当前挑战
该数据集所面临的挑战首先体现在领域问题的复杂性上:社交媒体上的职业咨询讨论往往混杂着情感宣泄、非正式用语与多义性表达,使得从文本中精准提取职业发展相关的核心诉求成为一项艰巨任务,传统主题模型难以捕捉深层的语义关联与语境依赖。其次,在数据构建过程中,研究者需应对Reddit平台内容的高度动态性与噪声问题,包括帖文话题漂移、重复内容以及用户隐私信息的潜在泄露风险。此外,如何确保从海量未标注数据中通过无监督或弱监督方法生成的高质量主题标签具有跨文化、跨行业的泛化能力,亦是构建过程中的一大技术瓶颈。这些挑战不仅考验数据清洗与特征工程的效率,也对后续模型在职业指导场景下的鲁棒性与可解释性提出了更高要求。
常用场景
经典使用场景
在职业发展与人机交互的交叉研究领域,mb7419/career-guidance-reddit数据集以其丰富的Reddit论坛职业咨询帖文为核心,成为探索个体职业困惑与群体智慧交互模式的经典资源。研究者常利用该数据集进行主题建模与情感分析,通过提取帖子中的‘主导主题’与‘问题内容’字段,揭示当代求职者面临的核心议题——从转行抉择、技能提升到行业前景的普遍焦虑。该场景下,数据集不仅支持对职业指导对话的语义解析,还为构建个性化推荐系统提供了训练语料,堪称理解数字时代职业叙事的重要窗口。
解决学术问题
该数据集直面职业心理学与计算社会科学中的若干关键难题:如何从非结构化文本中系统识别职业发展痛点?如何量化网络社区中‘隐性知识’的传播模式?通过整合标题、正文与主题标签,它使研究者能够量化分析不同职业阶段(如初入职场与中年转型)的求助偏好差异,并验证社会支持理论在虚拟空间中的适用性。这一资源有效弥合了质性访谈与大数据分析之间的方法论鸿沟,为验证‘弱连接’理论在职业咨询中的有效性提供了可复现的实证基础,显著推动了职业指导领域的计算转向。
衍生相关工作
该数据集催生了一系列具有影响力的衍生研究。例如,基于其‘问题内容’与‘主导主题’的映射关系,学者提出了职业咨询对话的层级分类框架,并开发了首个专门用于职业意图识别的预训练语言模型。另有工作利用其时间戳字段,追踪COVID-19疫情前后职业焦虑话题的语义漂移,揭示了远程办公对职业认同感的深层冲击。这些衍生探索不仅拓展了数据集的应用边界,还反向推动了Reddit等社交平台在职业研究中的方法论创新,形成了从数据采集到理论验证的良性学术生态。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务