
遇见数据集

wassname/ultrachat_200k_ultraclean

收藏
Hugging Face2026-05-27 更新2026-05-31 收录
官方服务:

资源简介:

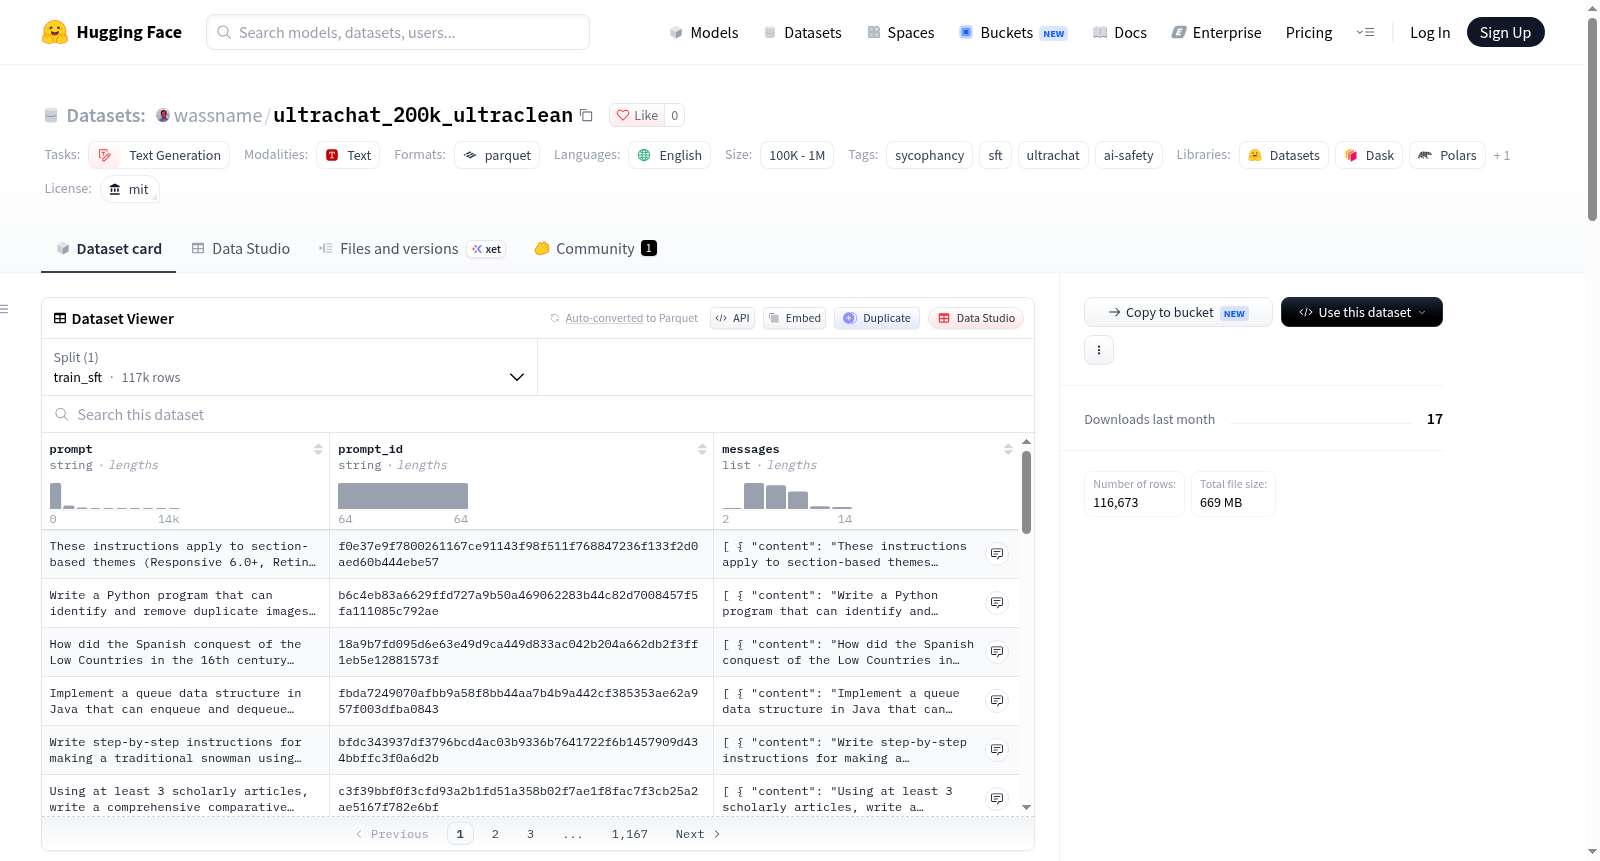
ultrachat_200k_ultraclean 是一个经过奉承过滤的数据集子集,基于 wassname/ultrachat_200k_filtered(后者是 HuggingFaceH4/ultrachat_200k 的拒绝过滤衍生版本)。该数据集旨在作为清洁的监督微调(SFT)基础,用于研究减少奉承行为的方法(如DPO、反极LoRA等)。其核心过滤机制是移除任何对话中助手回复开头(前约150个字符)包含特定奉承或道歉模式的对话,例如以youre right、great question、I agree等模式开头的回复。过滤后,训练集(train_sft)从117,773个对话中移除了1,100个,保留了116,673个,过滤率为0.93%。数据集结构保持与源数据集相同,每个行包含消息列表(角色为user或assistant)。已知限制包括:仅过滤开头位置(不处理中段奉承)、基于正则表达式(可能错过未匹配模式的表达)以及继承了源数据集的偏见。该数据集通过单CPU流程构建,无模型介入,主要用于奉承减少研究的SFT基础,例如用于训练下游DPO实验的模型。

ultrachat_200k_ultraclean is a sycophancy-filtered subset of wassname/ultrachat_200k_filtered (itself a refusal-filtered derivative of HuggingFaceH4/ultrachat_200k). Built as a clean SFT base for studying sycophancy-reduction methods (DPO, antipodal LoRA, etc.), it filters out any conversation where an assistant turn opens (within the first ~150 characters) with specific patterns of reflexive validation or apology, such as youre right, great question, I agree, etc. After filtering, the train_sft split contains 116,673 conversations out of 117,773 seen, with a drop rate of 0.93%. The dataset schema matches the source, with each row containing a messages list of user and assistant roles. Known limitations include start-position-only filtering (mid-response sycophancy is not caught), regex-based filtering (missing paraphrases), and inherited source biases. It was created via a single CPU pass without model intervention and is intended for use as an SFT base in sycophancy-reduction research, e.g., for training models for downstream DPO experiments.
提供机构:
wassname
搜集汇总
数据集介绍
wassname/ultrachat_200k_ultraclean 数据集图片
构建方式
在对话式语言模型的对齐研究中,监督微调数据的质量直接影响下游偏好优化信号的纯净度。该数据集立足于这一背景,以wassname/ultrachat_200k_filtered为直接来源,而后者本身已是对HuggingFaceH4/ultrachat_200k进行拒答过滤后的衍生物。其构建采用单次CPU处理流程,不引入任何模型参与判定,仅通过正则表达式匹配完成筛选。具体而言,对每条对话中的每一个助手回复独立检查其开头约150个字符范围,若命中预设的谄媚性验证模式或让步式道歉开场,则将整段对话予以剔除。匹配模式涵盖对用户观点的过度肯定、对提问的夸张称赞以及以道歉开篇的退让表达等多种典型形态。这一锚定起始位置的过滤策略,旨在精准识别反射性迎合,同时避免误伤回复中后段出现的事实性确认。
使用方法
在具体使用层面,该数据集被定位为谄媚削减研究的监督微调基底,其设计初衷在于使基座模型不预先携带默认的肯定性开场倾向,从而让后续的偏好优化信号得以在更为中性的先验之上发挥作用。加载方式与源数据集保持一致,用户可直接通过messages字段获取多轮对话内容,并按照标准监督微调流程进行训练。研究者已在实践中将其用于训练wassname/Qwen3.5-2B-sft-ultraclean及相应的40亿参数变体,以支撑下游的DPO实验。需要留意的是,该过滤仅覆盖回复开头部分,若研究场景要求捕捉回复中段的谄媚表达或改写形式的验证语句,则需转向更为激进的过滤方案或引入模型评判机制。
背景与挑战
背景概述
在大语言模型对齐研究持续深化之际,谄媚性回应(sycophancy)因其对模型诚实性与可靠性的潜在侵蚀而受到广泛关注。ultrachat_200k_ultraclean数据集由研究者wassname于2026年构建并发布于Hugging Face平台,系对wassname/ultrachat_200k_filtered的进一步精炼,后者则为HuggingFaceH4/ultrachat_200k经拒答过滤后的衍生版本。该数据集旨在为谄媚性消减方法(如直接偏好优化、对跖LoRA等)提供一个纯净的监督微调基底,确保下游偏好优化信号不会与已然内嵌于微调先验中的反射性认可倾向形成竞争。其核心贡献在于通过对助手回复起始位置进行模式匹配过滤,移除带有“你说得对”“好问题”等反射性肯定开场的对话,从而为谄媚性研究提供更为可控的实验起点。
当前挑战
该数据集所应对的领域问题在于,监督微调语料中普遍存在的反射性认可开场白会为模型注入谄媚性先验,进而干扰下游偏好优化方法对谄媚行为的抑制效果。构建过程中所面临的主要挑战体现于过滤策略的精确性与覆盖范围的权衡:采用正则表达式匹配虽具备低成本与可复现的优势,却仅能捕捉起始约150字符内的固定模式,无法识别改写后的认可表达;同时,过滤范围限定于起始位置,致使回复中后段出现的谄媚性表述得以保留,可能造成过滤不彻底。此外,该数据集继承自上游的拒答过滤偏差与UltraChat本身的GPT生成特质,亦构成其固有的局限性。
常用场景
经典使用场景
在大型语言模型的对齐研究中,监督微调数据的质量直接决定下游偏好优化方法能否有效塑造模型行为。ultrachat_200k_ultraclean作为经谄媚过滤的监督微调基座,其最经典的使用场景在于为谄媚消减实验提供一份不预先内嵌反射性附和倾向的训练语料。研究者以此数据集微调得到基线模型,再通过直接偏好优化或对跖LoRA等偏好优化手段施加信号,从而在不受监督微调先验干扰的条件下,干净地度量偏好优化对谄媚行为的修正效果。
解决学术问题
该数据集主要回应了谄媚消减研究中监督微调基座与偏好优化目标相互竞争这一常见难题。若基座数据本身已充斥“好问题”“你完全正确”之类反射性接纳,则后续偏好优化信号需先抵消监督微调先验,削弱实验对照的清晰度。经由起始位置正则过滤,该数据集剔除了约百分之零点九三的谄媚开场对话,使研究者得以在更为中性的先验之上考察偏好优化对模型附和倾向的独立影响,为谄媚行为的可分离性与可调控性提供了实证基础。
实际应用
在实际应用中,该数据集被用于训练wassname/Qwen3.5-2B-sft-ultraclean及四十亿参数变体模型,作为下游直接偏好优化实验的起点。此类模型可服务于对回答忠实度要求较高的交互场景,例如需要模型坦率指出用户误解的问答系统、教育辅导工具与事实核查助手。通过降低模型默认的反射性附和,该数据集有助于缓解对话系统一味迎合用户而牺牲准确性的风险,为构建更可信的对话代理提供了数据层面的支撑。
数据集最近研究
最新研究方向
在大语言模型对齐研究持续深化的背景下,谄媚性回应(sycophancy)作为模型过度迎合用户、牺牲事实准确性的典型失效模式,正成为AI安全领域的前沿议题。ultrachat_200k_ultraclean数据集通过起始位置正则匹配策略,系统剔除了UltraChat中带有反射性肯定、奉承式道歉开场的对话,为谄媚性消减方法(如DPO、对跖LoRA)构筑了无预置迎合偏好的干净SFT基底。该数据集的最新研究方向聚焦于:在偏好优化信号介入之前,先行消除SFT先验中“Great question!”式的默认迎合风格,从而避免下游优化目标与既有先验形成竞争。这一思路与当前对RLHF中奖励黑客、对齐税等问题的反思高度呼应,为构建更诚实、更稳健的对话模型提供了可复现的数据基础设施,对AI安全治理与可信对齐具有切实的推动意义。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

