Fara-40-baseline-artifact
收藏资源简介:
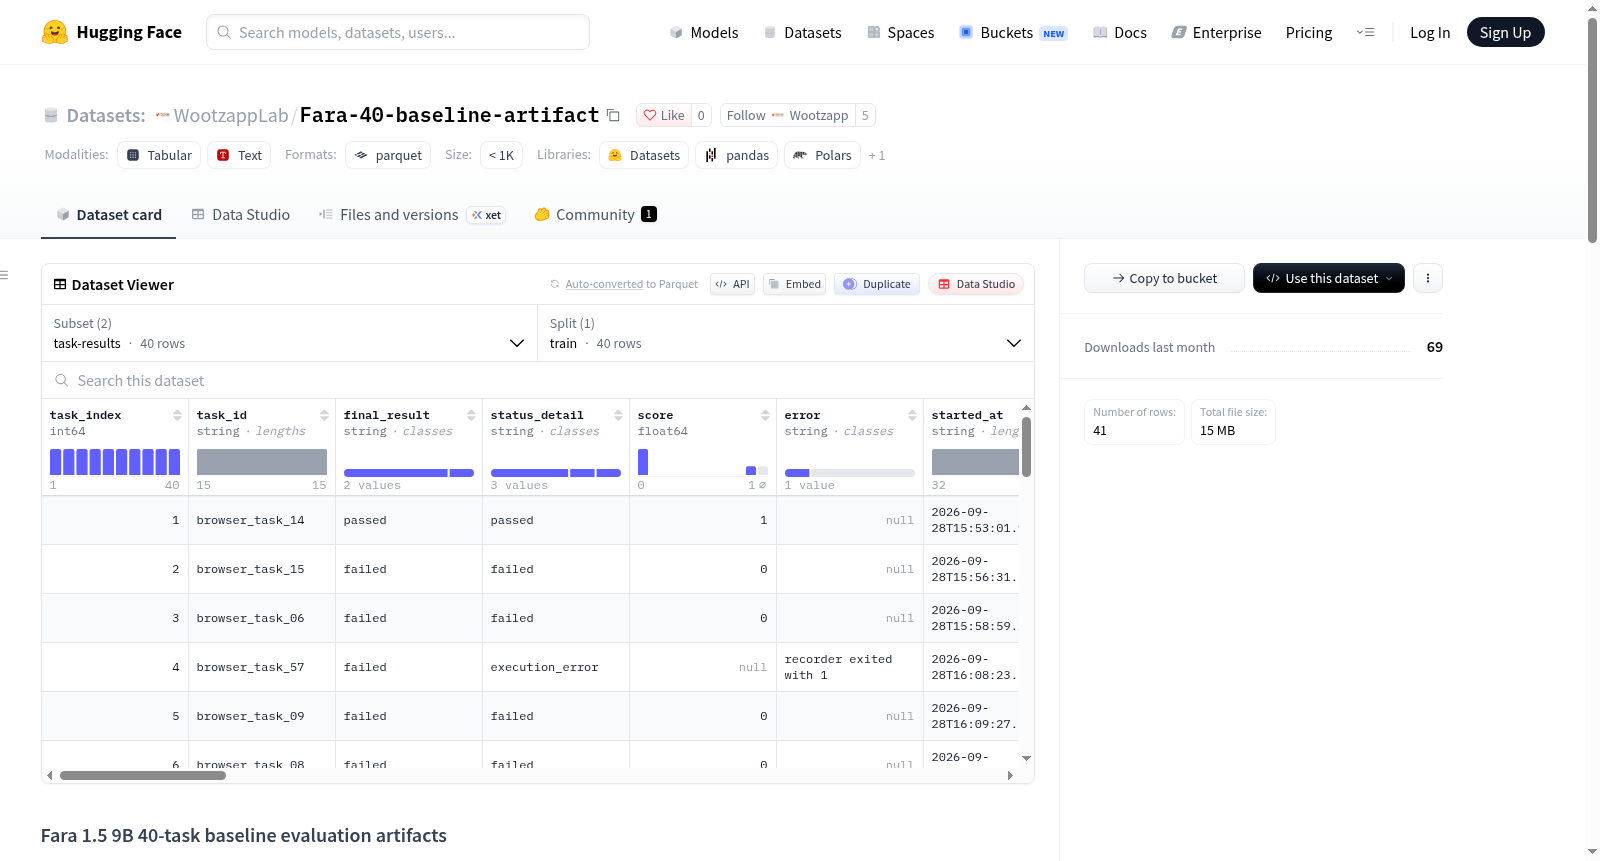
该数据集提供了 WootzApp CUA Bench 中 Fara 1.5 9B 模型在40个任务上的基线评估完整工件。数据包含两个配置:任务级结果(task-results)和评估摘要(summary),均以 Parquet 格式存储。评估记录了每个任务的原始输出、模型输出、日志、评分标准及验证器结果,并提供了精确的来源追踪(模型检查点、任务数据集、基础设施代码等)。在40个选定任务中,模型通过了8个,24个出现验证器失败,8个出现执行错误,总通过率(Pass@1)为20.0%,在通过验证的任务中通过率为25.0%。该数据集适用于审计、复现评估结果以及深入分析模型在特定任务上的表现。
This dataset provides the complete baseline evaluation artifacts of the Fara 1.5 9B model on 40 tasks in the WootzApp CUA Bench. The data contains two configurations: task-level results (task-results) and evaluation summary (summary), both stored in Parquet format. The evaluation records raw output, model output, logs, scoring criteria, and validator results for each task, along with precise source tracking (model checkpoint, task dataset, infrastructure code, etc.). Among the 40 selected tasks, the model passed 8, had 24 validator failures, and 8 execution errors, with a total pass rate (Pass@1) of 20.0% and a pass rate of 25.0% among tasks that passed validation. This dataset is suitable for auditing, reproducing evaluation results, and conducting in-depth analysis of model performance on specific tasks.
Fara 1.5 9B 40-Task Baseline Evaluation Artifacts
数据集概述
该数据集保存了 WootzApp CUA Bench 中 40 项任务的 Fara 基线评估的完整评估产物。
评估结果
| 指标 | 数值 |
|---|---|
| 选定任务数 | 40 |
| 通过 | 8 |
| 验证器失败 | 24 |
| 执行错误 | 8 |
| 基础设施错误 | 0 |
| 所有选定任务的 Pass@1 | 20.0% |
| 已验证任务的通过率 | 25.0% |
执行错误仍保留在分母中。数据集包含原始任务日志,因此这八个任务可以与验证器评分的失败任务分开审计。
精确来源
| 组件 | 仓库或资源 | 精确版本 |
|---|---|---|
| 上游模型 | microsoft/Fara1.5-9B | 1a93677cd89d5601bc2ed759791e981f3a520032 |
| 保留的模型检查点 | WootzappLab/fara-9b-baseline-eval | 6b15345b4dd7d567863bc08ec3bc79b44780dd99 |
| Fara 推理源代码 | 服务设置所使用的 Microsoft Fara 源代码 | a675d6d61c41c47ae87bacefeab22caad18e3e84 |
| 任务数据集 | WootzappLab/cua-bench-baseline-40 | c2dd9ed8f23cbc477f49be7b7704e42bf4d46de6;精确快照 SHA256 745f113b9c45f1a8dc3581ebc671435a3eafdfdbfb38bcaa6df1097ec10ab2e3 |
| 记录器、浏览器测试框架、环境、验证器 | tokenbender/w8-cua-bench | 09976c86454f9a87e2fa6a3a3589d2e4d24f180e |
| 基础设施代码 | infra-changes 分支 |
eb5dc3d9e0cbfbe389334b0600002f8db3a795dd |
| 结果包 | 原始产物与任务快照清单 | 43f4ed88b79d9c0abe7a733ac6499b0000364e3f1f676a29320e83d1682e081b |
评估使用了 GCP 实例 w8-fara-9b-8115f370-head-3ibtw2ah-compute,项目为 lifeandhalf-24122025,区域为 us-central1-a。
仓库结构
artifacts/43f4ed88b79d9c0abe7a733ac6499b0000364e3f1f676a29320e83d1682e081b/raw/:完整原始输出,包括每个任务的录制、模型输出、日志、评分标准和验证器结果artifacts/43f4ed88b79d9c0abe7a733ac6499b0000364e3f1f676a29320e83d1682e081b/source/tasks.jsonl:精确的 40 项任务输入快照data/task-results-00000-of-00001.parquet:每个任务一行规范化记录,以及默认数据集视图data/summary-00000-of-00001.parquet:评估级摘要与来源信息metadata/evaluation.json:机器可读的评估回执与任务结果metadata/publication.json:发布身份信息manifests/43f4ed88b79d9c0abe7a733ac6499b0000364e3f1f676a29320e83d1682e081b.sha256:每个原始产物与源快照的 SHA256
完整性检查
bash sha256sum -c manifests/43f4ed88b79d9c0abe7a733ac6499b0000364e3f1f676a29320e83d1682e081b.sha256
结果包 SHA256 是基于原始评估输出与精确任务快照的规范化清单派生的完整性校验和。
范围
该仓库包含评估证据与结构化结果。它不包含访问令牌、TLS 证书、浏览器缓存或模型权重。权重单独保存在上述链接的检查点仓库中。
配置
task-results(默认):data/task-results-*.parquetsummary:data/summary-*.parquet