
遇见数据集

reveng-labs/public-opj-corpus

收藏
Hugging Face2026-05-29 更新2026-05-31 收录
官方服务:

资源简介:

Public OPJ/OPJU Corpus 是一个内容寻址的语料库,包含从公共科学数据存储库收集的OriginLab项目文件(扩展名为.opj和.opju)。该数据集以分片形式组织,存储在opj/和opju/目录下的tar文件中,每个分片最多包含100个文件,并通过metadata.jsonl文件提供元数据,包括文件路径、SHA256哈希值、大小、来源信息(如存储库类型、ID、查看URL和DOI)以及下载方式。数据集经过去重处理,确保文件唯一性。用户可以通过HuggingFace数据集库加载元数据,并使用huggingface_hub下载分片文件以提取原始项目文件。每个文件的上游许可证可能不同,因此没有统一的数据集许可证,用户需通过来源信息遵守相应许可条款。

The Public OPJ/OPJU Corpus is a content-addressable corpus containing OriginLab project files with extensions .opj and .opju, collected from public scientific data repositories. This dataset is organized into shards, stored as tar files under the opj/ and opju/ directories. Each shard contains up to 100 files, and metadata is provided via the metadata.jsonl file, including file paths, SHA256 hashes, file sizes, source information such as repository type, ID, view URLs, DOIs, and download methods. The dataset has undergone deduplication to ensure file uniqueness. Users can load the metadata using the Hugging Face Datasets library, and download the shard files via huggingface_hub to extract the original project files. The upstream licenses for each individual file may vary, so there is no unified dataset license. Users are required to comply with the corresponding license terms based on the provided source information.
提供机构:
reveng-labs
搜集汇总
数据集介绍
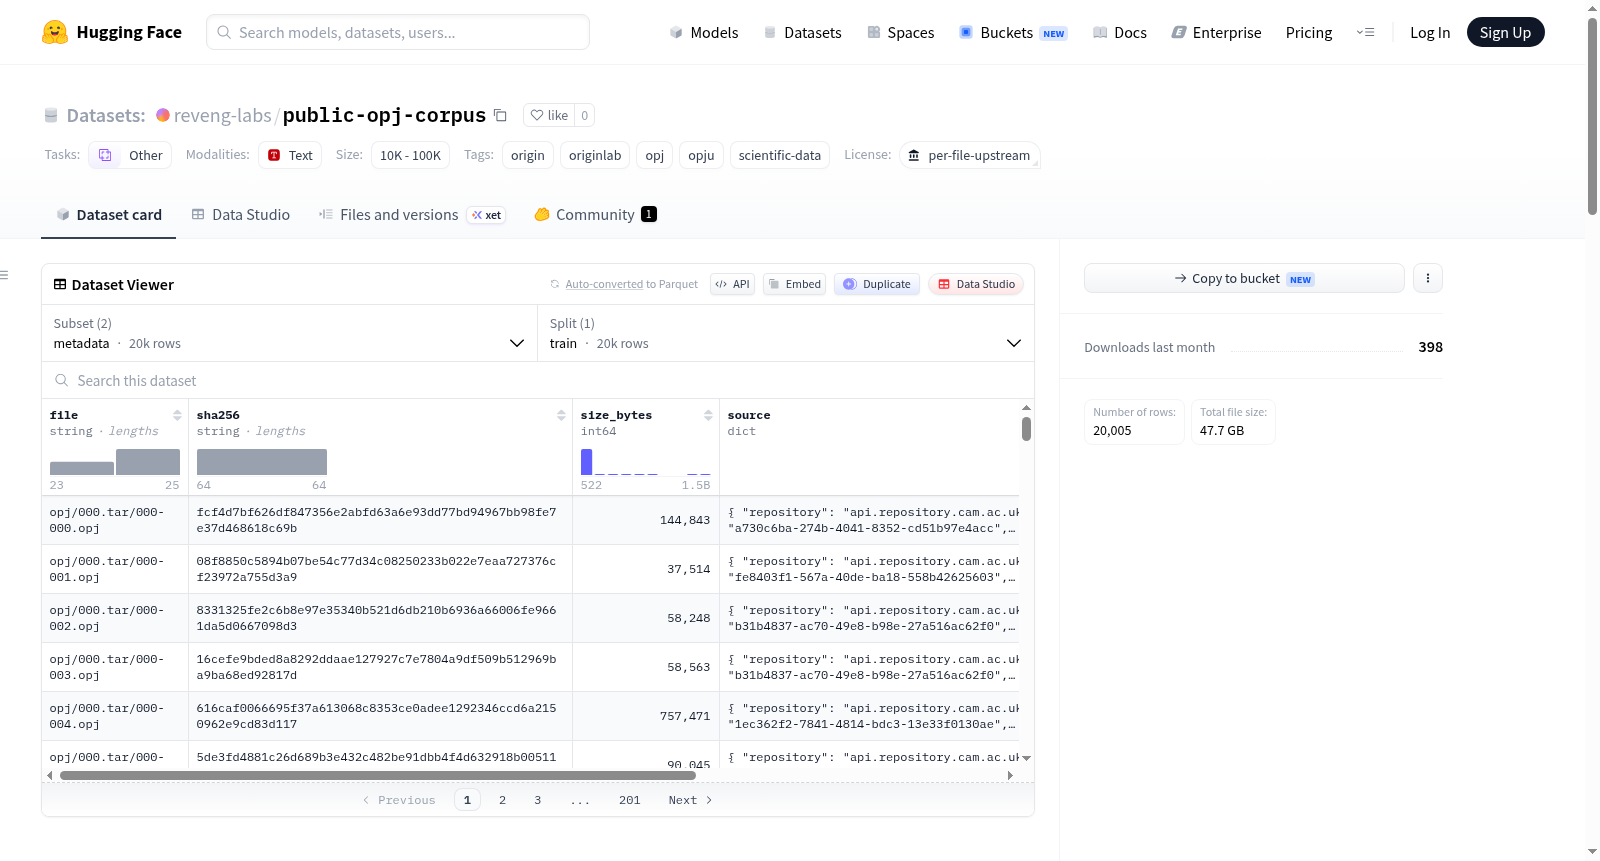
reveng-labs/public-opj-corpus 数据集图片
构建方式
该数据集由公共科学数据仓库中收集的OriginLab项目文件(.opj与.opju格式)构成,采用内容寻址(content-addressed)策略组织。每个文件经SHA-256哈希去重后,以tar分片(shard)形式存储,每片最多容纳100个文件,并附有零化uid/gid/mtime的标准化处理以确保字节可复现性。配套的metadata.jsonl文件为每个数据点提供文件路径、哈希值、来源仓库(如Zenodo、Figshare、GitHub等)及下载方式等结构化元信息,支持可追溯的溯源与重新获取。
特点
数据集的显著特色在于其内容寻址与去重机制:通过SHA-256哈希判定文件同一性,确保唯一性并避免冗余存储。元信息详尽丰富,涵盖来源类型、记录标识、DOI以及下载策略(如直接URL、归档内路径或缺失状态),便于用户按需验证和关联上游数据。此外,tar分片设计兼顾了存储效率与批量处理需求,而元数据符合JSON Schema 2020-12规范,为自动化解析与集成提供了标准化基础。
使用方法
使用此数据集时,可借助HuggingFace Datasets库加载元数据:通过load_dataset("reveng-labs/public-opj-corpus", "metadata", split="train")获取文件清单。随后,利用huggingface_hub的hf_hub_download函数下载对应tar分片,再通过Python的tarfile模块提取指定成员文件。例如,根据元数据行中的file字段解析出分片和成员路径,下载后读取二进制内容并验证其大小,即可恢复原始OriginLab项目文件,便于进一步分析或应用。
背景与挑战
背景概述
在科学数据日益数字化与开放共享的浪潮中,大量研究人员采用OriginLab软件(以.opj和.opju格式存储)进行实验数据的可视化和分析,但这些宝贵的科学项目文件散落在GitHub、Zenodo、Figshare等多个公共数据存储库中,缺乏统一、可检索、可复用的语料库。为此,reveng-labs团队于近期构建了Public OPJ/OPJU Corpus数据集,专注于从各大公开科学数据仓库中收集并去重整理OriginLab项目文件。核心研究问题在于如何建立一套内容可寻址、元数据完备的科学项目文件语料体系,以支持数据重用、工具开发与科学可重复性研究。该数据集对科学数据管理、数据挖潜以及OriginLab生态工具链的标准化具有重要奠基意义。
当前挑战
该数据集面临的核心挑战首先是领域问题:科学项目文件(如.opj/.opju)作为高度异构的二进制格式,长期以来缺乏标准化采集与元数据体系,导致大量隐藏在科研数据附录中的宝贵项目文件难以被发现和二次利用;数据集的构建过程同样充满困难,包括从超过十二种不同类型的数据仓库(如Zenodo、Figshare、Mendeley等)中爬取文件,需处理各平台差异化的API接口与访问限制;更为棘手的是文件去重问题,数据集为此采用SHA256内容寻址策略来保证同一文件的唯一性,但跨仓库重复文件的元信息合并与溯源仍需精妙设计。此外,许可证的复杂性亦构成挑战,每个文件仅继承其上游许可证,数据集本身无法提供统一授权,这对后续合规分发提出了严格要求。
常用场景
经典使用场景
在科学数据管理与复现性研究的交汇领域,Public OPJ/OPJU Corpus作为一个专门收录OriginLab项目文件的语料库,为研究人员提供了宝贵的数据资源。该数据集最经典的使用场景是作为科学数据开放共享与归档的标准化基准,研究者可基于其内容寻址的特性验证文件完整性,并通过元数据中的SHA256哈希值实现跨平台的数据去重与溯源。此外,该语料库常用于评估和训练面向科学工作流的文件解析模型,帮助自动化提取OriginLab文件中嵌入的实验参数、图表配置与统计分析结果,为跨学科的数据复现与再分析奠定基础。
衍生相关工作
围绕Public OPJ/OPJU Corpus已衍生出多项经典工作。在数据溯源领域,研究者提出了基于内容寻址哈希的跨存储库引用方法,利用该语料集中的sha256字段构建了去中心化的科学文件标识体系。在开放科学计量方面,衍生工作通过分析metadata中repository字段的统计分布,揭示了不同学科对OriginLab文件的偏好性沉积规律,并据此优化了学科专属的数据爬取策略。此外,数据复现性评估工具的开发团队利用该语料集中的download字段自动化验证了数百个OPJ文件的持续可访问性,其结果直接推动了相关存储库的链接维护策略改进。在软件生态层面,有工作基于该语料集训练了OPJ文件的结构化信息抽取模型,能够自动识别并提取图表标题、统计检验结果与注释文本,为构建可查询的科学图表数据库提供了关键技术支撑。
数据集最近研究
最新研究方向
该数据集聚焦于从Zenodo、Figshare、GitHub等公共科学数据仓库中大规模收集并去重的OriginLab项目文件(.opj/.opju),为科学计算与数据可视化领域提供了标准化、内容可寻址的研究素材。当前前沿研究方向包括:利用该语料库训练专用大语言模型以解析OriginLab的图形化数据处理逻辑,实现科研工作流的自动化转录与复现;结合元数据中的来源与许可证信息,推动开放科学数据的跨平台溯源与合规复用。该语料库的构建恰逢全球科研数据共享与可重复性危机备受瞩目的时期,其SHA256去重与分片压缩设计显著降低了异构数据整合的存储成本,为跨学科科学数据集的高效分发与协作研究树立了新范式。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

