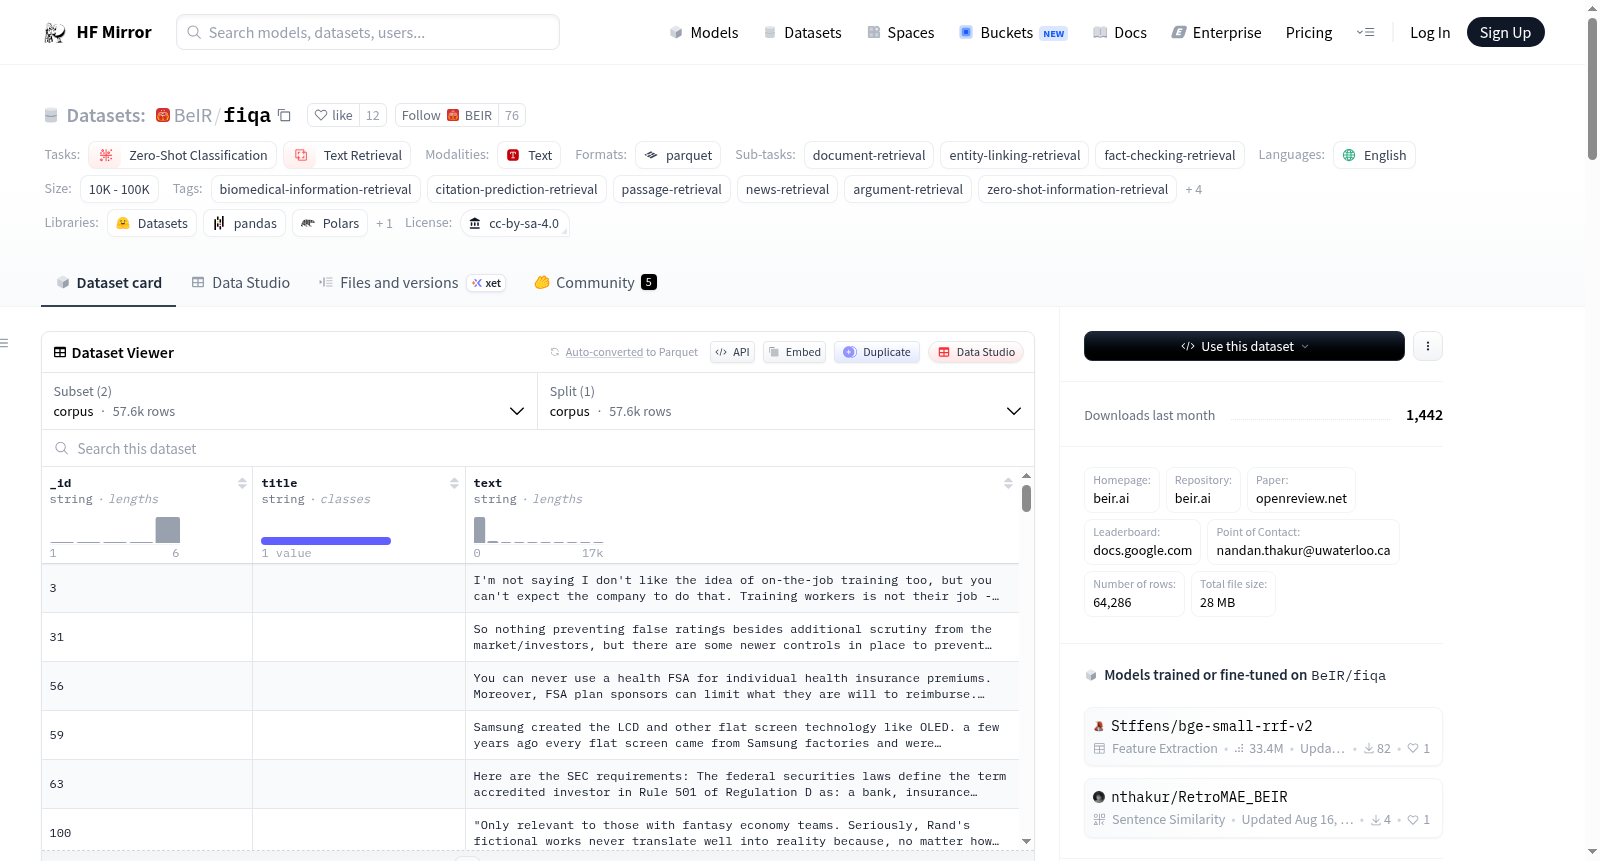
BeIR/fiqa
收藏资源简介:
BEIR是一个异构基准测试,由18个不同的数据集组成,代表了9种信息检索任务,包括事实核查、问答、生物医学信息检索、新闻检索、论点检索、重复问题检索、引用预测、推文检索和实体检索。所有数据集均为英文,并已预处理,可用于实验。数据集的结构包括corpus、queries和qrels三个部分,分别以jsonl和tsv格式存储。
BEIR is a heterogeneous benchmark composed of 18 distinct datasets, covering 9 information retrieval tasks including fact checking, question answering (QA), biomedical information retrieval, news retrieval, argument retrieval, duplicate question retrieval, citation prediction, tweet retrieval, and entity retrieval. All datasets are in English and have been preprocessed for experimental use. The datasets are structured into three core components: corpus, queries, and qrels, which are stored in jsonl and tsv formats respectively.
数据集概述
名称: BEIR Benchmark
描述: BEIR是一个异构基准,由18个多样化的数据集组成,涵盖9种信息检索任务。这些数据集包括事实核查、问答、生物医学信息检索、新闻检索等多个领域。
语言: 英语 (en)
许可: CC-BY-SA-4.0
多语言性: 单语
数据集结构
数据集大小:
- MSMARCO: 1M<n<10M
- TREC-COVID: 100k<n<1M
- NFCorpus: 1K<n<10K
- NQ: 1M<n<10M
- HotpotQA: 1M<n<10M
- FiQA: 10K<n<100K
- ArguAna: 1K<n<10K
- Touche-2020: 100K<n<1M
- CQADupstack: 100K<n<1M
- Quora: 100K<n<1M
- DBpedia: 1M<n<10M
- SciDocs: 10K<n<100K
- FEVER: 1M<n<10M
- Climate-FEVER: 1M<n<10M
- SciFact: 1K<n<10K
任务类别:
- 文本检索
- 零样本检索
- 信息检索
- 零样本信息检索
任务ID:
- 段落检索
- 实体链接检索
- 事实核查检索
- 推文检索
- 引用预测检索
- 重复问题检索
- 论证检索
- 新闻检索
- 生物医学信息检索
- 问答检索
数据集创建
源数据:
- 数据集未提供源数据的具体信息。
注释:
- 数据集未提供注释过程和注释者的具体信息。
个人和敏感信息:
- 数据集未提供关于个人和敏感信息的处理细节。
使用数据集的考虑
社会影响:
- 数据集未提供关于其社会影响的讨论。
偏见讨论:
- 数据集未提供关于潜在偏见的讨论。
其他已知限制:
- 数据集未提供其他已知限制的信息。
附加信息
数据集管理员:
- 数据集未提供数据集管理员的具体信息。
许可信息:
- 数据集的许可为CC-BY-SA-4.0。
引用信息:
@inproceedings{ thakur2021beir, title={{BEIR}: A Heterogeneous Benchmark for Zero-shot Evaluation of Information Retrieval Models}, author={Nandan Thakur and Nils Reimers and Andreas R{"u}ckl{e} and Abhishek Srivastava and Iryna Gurevych}, booktitle={Thirty-fifth Conference on Neural Information Processing Systems Datasets and Benchmarks Track (Round 2)}, year={2021}, url={https://openreview.net/forum?id=wCu6T5xFjeJ} }
贡献:
- 感谢@Nthakur20添加此数据集。