
AnshulGokul/editor-token-min
收藏官方服务:
资源简介:
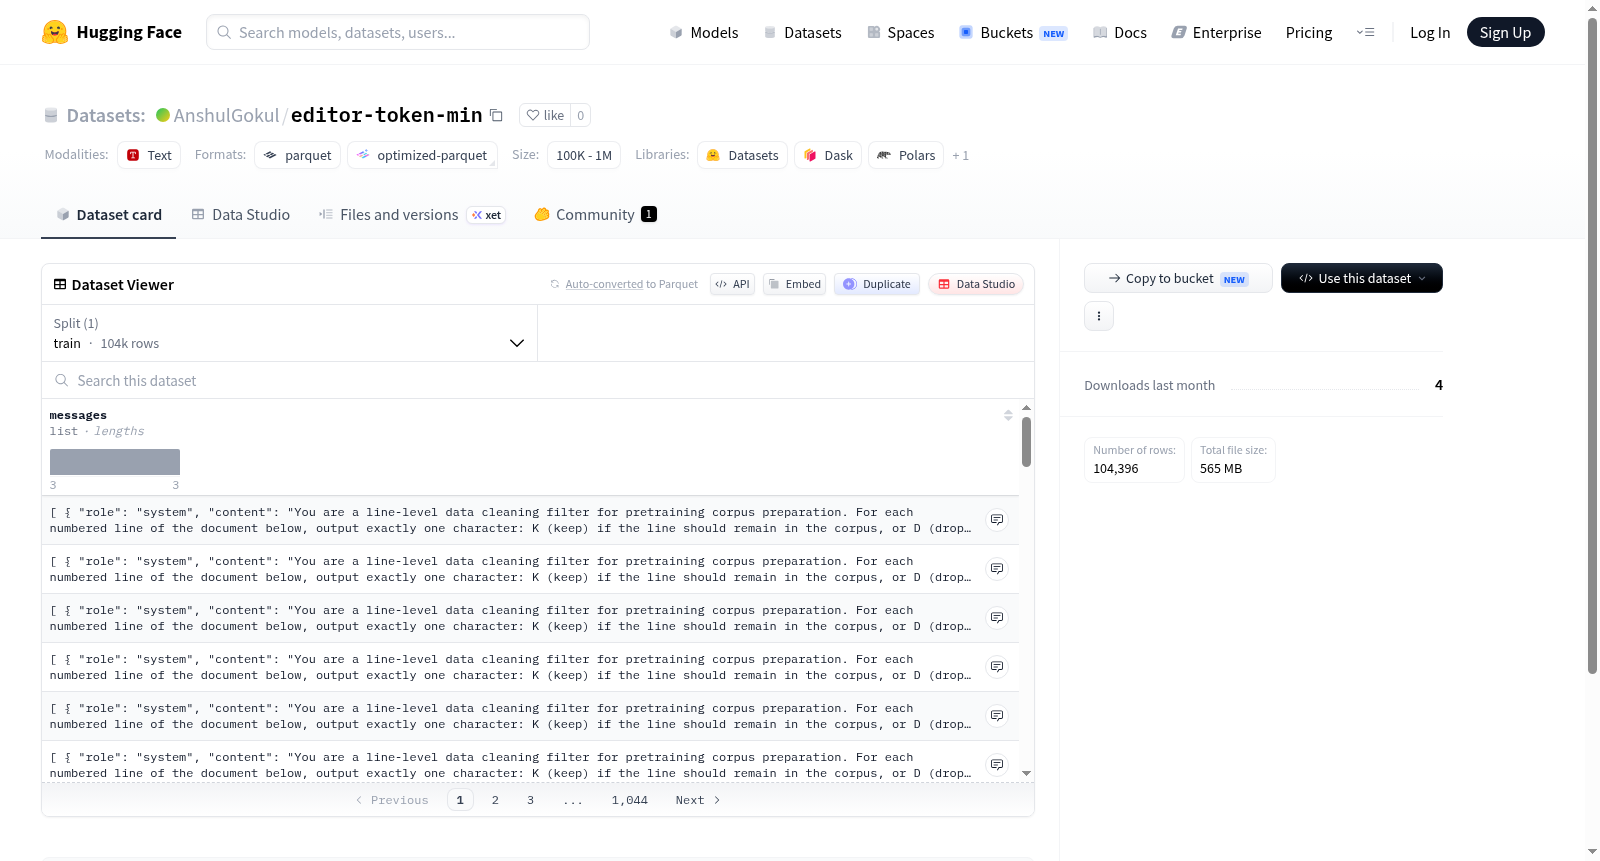
该数据集包含对话数据,每条记录是一个消息列表,每个消息包括角色(如用户或助手)和文本内容。训练集中共有约10.4万条样本。
This dataset contains conversational data, where each record is a list of messages with roles (e.g., user or assistant) and content. The training split has approximately 104,396 samples.
提供机构:
AnshulGokul搜集汇总
数据集介绍
构建方式
editor-token-min数据集通过整合多来源的对话数据构建而成,其核心结构遵循标准的messages格式,每条记录包含role和content两个字段,分别标识对话参与者的角色(如用户或助手)以及对应的文本内容。该数据集仅提供训练集,共包含104,396个样本,总大小为564,362,517字节,确保数据在规模与多样性上的平衡,适用于对话系统的训练与优化。
特点
该数据集的一大特色在于其简洁且规范的对话结构,仅以role和content字段清晰区分对话轮次,降低了数据处理的复杂性。同时,单一训练集的设计聚焦于模型微调,避免了跨数据分区的冗余。数据总量适中,既能提供充分的训练样本,又不会因过大规模而增加计算负担,适合用于中文对话模型的快速迭代与验证。
使用方法
使用时,用户可直接从HuggingFace加载editor-token-min数据集的默认配置,通过读取train分区的数据文件(如data/train-*),利用标准的数据加载器解析messages列表。每条数据作为一组对话历史,可用于监督式微调,其中role字段指导模型识别对话角色,content字段提供文本输入,进而训练模型生成符合语境的回复。
背景与挑战
背景概述
editor-token-min数据集是自然语言处理领域中用于对话系统与文本编辑任务的重要资源,由相关研究机构于近期创建。该数据集聚焦于模拟人类编辑行为对文本进行标记化修改,旨在解决模型在生成过程中缺乏精细控制的问题。其核心研究问题是如何通过编辑指令实现对话内容的精准调整,以提升交互系统的灵活性与准确性。该数据集的提出为对话生成、文本修订及指令微调等方向提供了关键支撑,推动了模型在动态交互场景下的适应性研究,对提升人工智能助手在真实应用中的编辑能力具有显著影响力。
当前挑战
该数据集面临的挑战首先在于领域问题:如何使模型理解并执行复杂的编辑操作,如删除、替换或插入特定标记,而非简单生成文本,这要求模型具备细粒度的语义理解与指令遵循能力。此外,构建过程中需应对数据标注的困难,包括确保编辑指令与文本修改之间的一致性、处理多轮对话中的编辑连贯性,以及平衡数据规模与多样性以避免模型过拟合于特定模式。同时,训练数据中标注噪声的控制和跨领域泛化能力的提升也是关键难题。
常用场景
经典使用场景
在自然语言处理与生成式人工智能的蓬勃发展中,editor-token-min数据集以其独特的消息序列结构,成为对话系统与文本生成任务中一颗璀璨的明珠。该数据集包含逾十万条训练样本,每条样本均以角色与内容二元组的形式组织,完美模拟了真实对话中的多轮交互模式。研究者常将其用于微调大规模语言模型,以提升模型在上下文连贯性、角色一致性及指令遵循能力上的表现。无论是构建智能客服、虚拟助手,还是开发故事续写与角色扮演系统,editor-token-min都能为模型提供丰富的对话范例,使其在复杂的语言环境中游刃有余。
解决学术问题
学术探索中,editor-token-min数据集直面对话式语言模型在长程依赖与多角色交互中的核心挑战。传统数据集常因结构单一而难以模拟真实对话的复杂动态,而该数据集通过精细的角色标注与序列化消息设计,为研究多轮对话中的语义连贯性、指代消解以及情感流转提供了坚实的数据基础。它解决了模型在对话中容易出现的“记忆漂移”与“角色混淆”问题,推动了上下文感知生成、对话状态追踪以及强化学习在对话策略优化中的应用。这一数据集的意义在于架起了静态文本理解与动态交互生成之间的桥梁,为构建更具人类智能的对话体提供了关键支撑。
衍生相关工作
围绕editor-token-min数据集,学术界与工业界催生了一系列开创性工作。许多研究者基于此数据集提出了创新的多轮对话微调策略,例如基于前缀调优的对话生成方法,显著提升了模型在有限样本下的泛化能力。另有团队将数据集与强化学习相结合,开发出面向对话奖励建模的经典框架,为对话策略的优化提供了可复现的基准。在安全与伦理领域,该数据集也被用来训练对话内容过滤与角色边界检测模型,成为构建负责任人工智能的重要基石。此外,基于该数据集的风格迁移研究揭示了角色身份对语言风格的深刻影响,推动了可控文本生成技术的进步。这些衍生工作如同枝蔓,不断延伸着数据集的生命力与影响力。
以上内容由遇见数据集搜集并总结生成


