british-library-book-images
收藏资源简介:
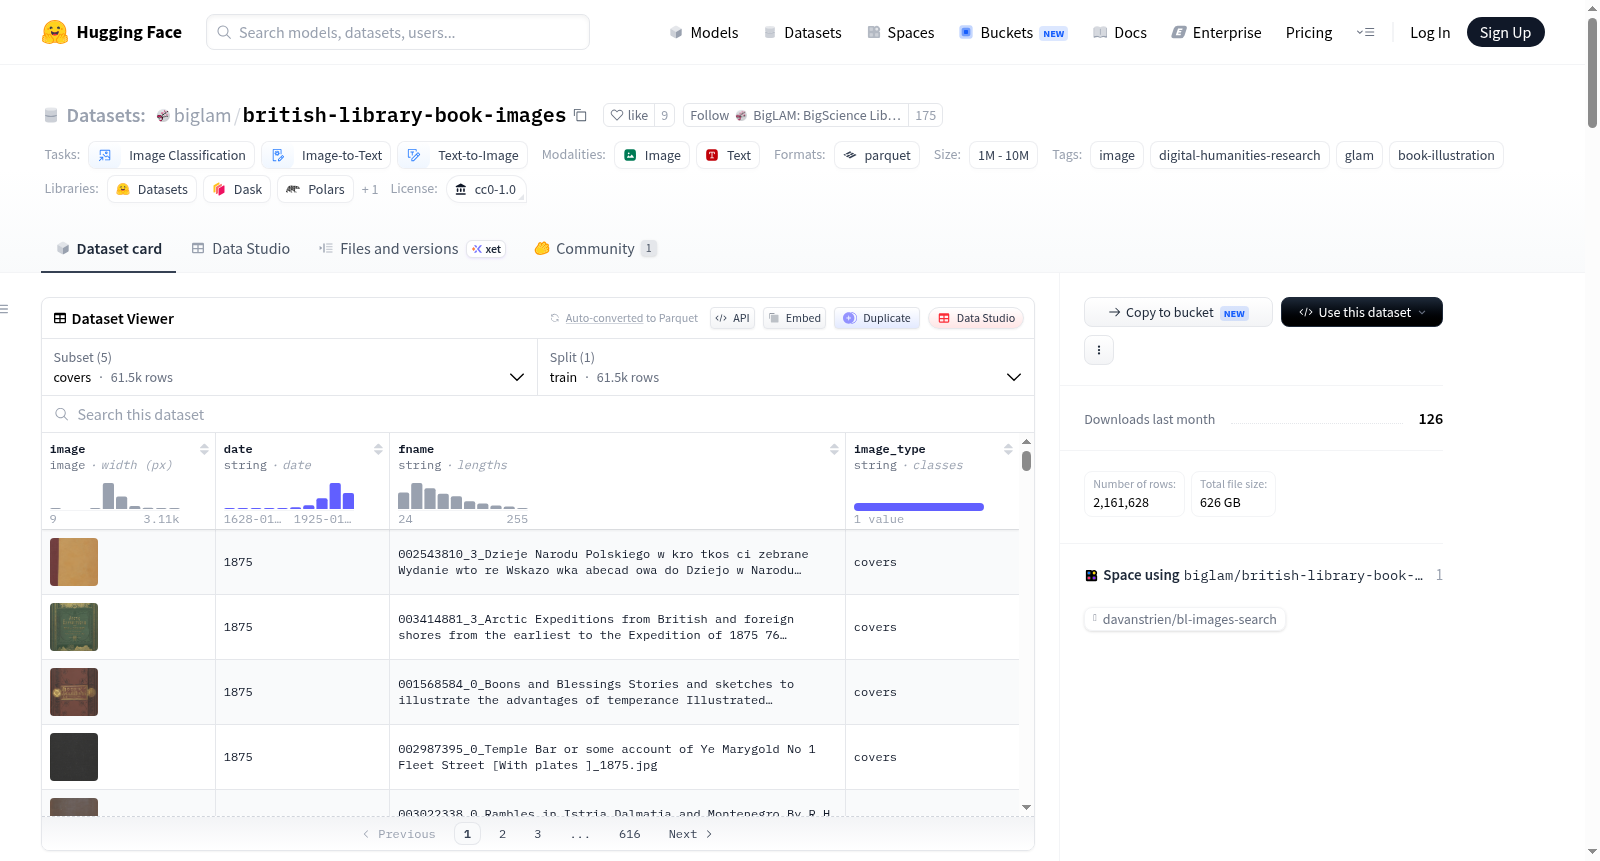
该数据集包含1,080,814张从英国图书馆与微软合作数字化的大约49,455本书籍(约65,227卷,约2500万页)中裁剪出的图像,出版年份介于约1510年至约1900年之间。这些书籍涵盖地理、哲学、历史、诗歌和文学等多个语种。图像由British Library Labs在Flickr Commons上以“来自扫描书籍的100万张图像”的形式发布。数据集分为四个配置,基于对每个裁剪区域的算法估计类型:embellishments(装饰物,416,935张)、plates(整版插画,385,231张)、medium(中型图像,217,100张)、covers(封面,61,548张)。注意这些类型标签是算法生成的,而非策展分类,尤其是medium和plates之间的边界可能模糊。每个样本包含JPEG图像、出版年份(字符串格式,部分为“Unknown”或超过1900年的错误记录)、原始文件名(包含英国图书馆系统编号,可用于关联OCR文本)以及图像类型字段。该数据集适用于图像分类、图像到文本、文本到图像等任务。此外还提供了使用SigLIP2模型预计算的嵌入配置(siglip2_embeddings),便于基于文本的检索。数据集采用CC0-1.0许可,但建议在引用时注明来源。
This dataset contains 1,080,814 images cropped from approximately 49,455 books (about 65,227 volumes, roughly 25 million pages) digitized through a collaboration between the British Library and Microsoft, with publication dates ranging from around 1510 to 1900. The books cover multiple languages including geography, philosophy, history, poetry, and literature. The images were released by British Library Labs on Flickr Commons as 1 Million Images from Scanned Books. The dataset is divided into four configurations based on algorithmically estimated types of each cropped region: embellishments (416,935 images), plates (385,231 images), medium (217,100 images), and covers (61,548 images). Note that these type labels are algorithmically generated, not curated categories, and the boundary between medium and plates may be ambiguous. Each sample includes a JPEG image, publication year (string format, some entries are Unknown or erroneous records beyond 1900), original filename (containing the British Library system number, which can be used to link to OCR text), and an image type field. The dataset is suitable for tasks such as image classification, image-to-text, and text-to-image. Additionally, a precomputed embedding configuration (siglip2_embeddings) using the SigLIP2 model is provided to facilitate text-based retrieval. The dataset is licensed under CC0-1.0, but citation of the source is recommended.
British Library Book Images 数据集详情
数据集概览
这是一个包含 1,080,814 张图像的数据集,图像来源于49,455 本数字化图书(共65,227卷,约2500万页),出版时间跨度约为 1510年至1900年。这些图书由大英图书馆与微软合作数字化,并由大英图书馆实验室(British Library Labs)在Flickr Commons上以"从扫描书籍中提取的100万图像"名义发布。图书内容涵盖地理、哲学、历史、诗歌和文学,涉及多种语言。
数据集配置
数据集分为四个主要配置,每个配置对应一种算法估计的图像类型:
| 配置名 | 图像数量 | 最早日期 |
|---|---|---|
embellishments(装饰图) |
416,935 | 1510 |
plates(整版图) |
385,231 | 1528 |
medium(中等图) |
217,100 | 1567 |
covers(封面) |
61,548 | 1510 |
此外还有一个 siglip2_embeddings 配置,包含所有图像的 SigLIP2 嵌入向量(1152维 float32,图像缩放至256x256),每个图像配置对应一个嵌入分割。
数据字段
- image:原始分辨率的JPEG图像
- date:出版年份,以字符串形式存储(非整数)。其中5,291行(0.5%)标记为"Unknown",2,151行的日期在1900年之后(最晚至1946年),属于目录错误
- fname:原始文件名。开头的数字为大英图书馆系统编号,其余部分编码了卷/页位置及书名
- image_type:四种图像类型之一,与配置冗余但便于合并
时间分布特征
- 1890年代的图像占总数的三分之一(348,302张)
- 1800年之前的所有图像仅占约1.6%
- 整个数据集主要代表维多利亚时代晚期的书籍插图
plates(整版图)在1800年前后差异显著:1690年代仅86张,而1800年代有4,682张,说明整版图是19世纪的印刷现象
图像与文本关联
fname 开头的数字是系统编号,可与 biglam/blbooks-parquet 数据集中的 record_id 关联(该数据集包含同一数字化项目的OCR文本,14,011,953页)。在20,000行样本中,96% 的系统编号可匹配到OCR记录。关联为书籍级别,而非页面级别。
许可与维护
- 许可:图像以公共领域(Public Domain Mark)发布,标记为 CC0-1.0,无已知版权限制
- 维护状态:有限维护,这是2014年静态存量的镜像,预计不会变更
- 原始存量的联系邮箱:labs@bl.uk
注意事项
- 图像类型标签是算法生成的,非策展分类,
plates和medium之间的界限模糊 - 语料库存在殖民时期出版物的过度代表,图像可能带有当时的描绘、标题和分类,未经过冒犯性内容审查
- 数据集描述了"早期2010年代大型英国机构数字化"的内容,而非印刷插图的代表性样本