
遇见数据集

palex19/trading-qa-data

收藏
Hugging Face2026-05-29 更新2026-05-31 收录
官方服务:

资源简介:

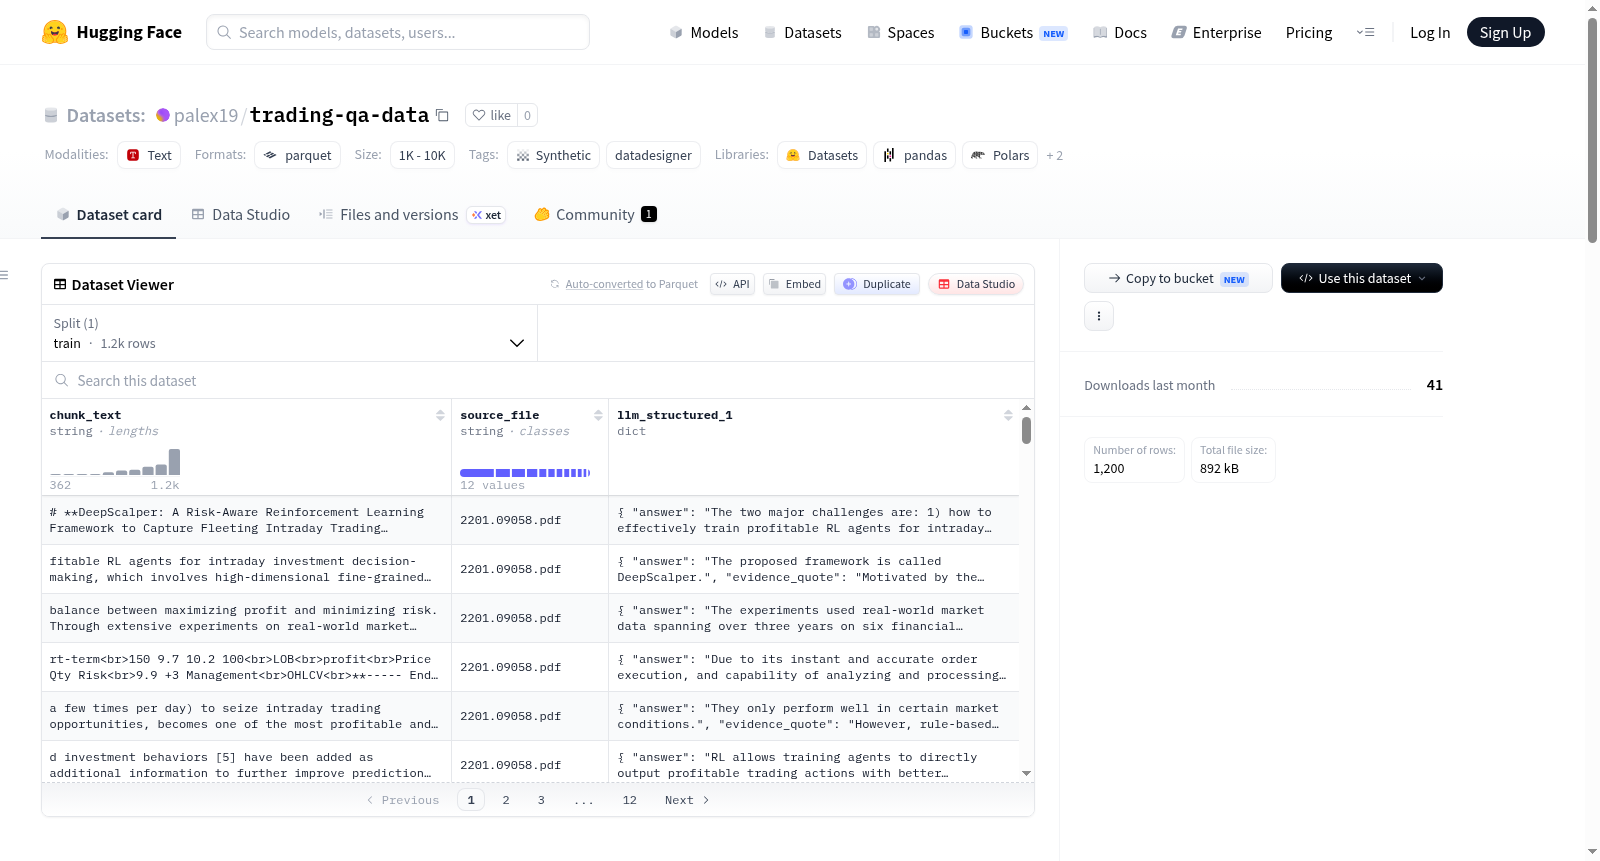
Trading papers QA - full v2 是一个使用 Unsloth Recipe Studio 生成的合成数据集,专注于交易论文的问答内容。该数据集包含 1,200 条生成记录,具有 3 列,其中一列是 llm_structured_1,类型为字典,表示由大型语言模型结构化的数据。数据集旨在提供高质量的交易相关问答数据,用于自然语言处理任务,如问答系统训练或评估。生成过程涉及 llm-structured 和 seed-dataset 配置,确保数据多样性和关系控制。

Trading papers QA - full v2 is a synthetic dataset generated using Unsloth Recipe Studio, focusing on question-answering content related to trading papers. This dataset contains 1,200 generated records with 3 columns, one of which is `llm_structured_1` — a dictionary type representing structured data produced by large language models (LLMs). The dataset aims to provide high-quality trading-related question-answering data for natural language processing (NLP) tasks such as training or evaluating question-answering systems. The generation process involves `llm-structured` and `seed-dataset` configurations to ensure data diversity and relational control.

提供机构:
palex19
搜集汇总
数据集介绍
palex19/trading-qa-data 数据集图片
构建方式
Trading-Qa-Data数据集由NVIDIA NeMo Data Designer框架基于Unsloth Recipe Studio生成,属于高质量合成数据集。该数据集以种子数据集为基底,结合统计采样器与大语言模型生成能力,通过配置三项列结构(包含一项llm-structured列与两项seed-dataset列)构建而成。构建过程严格遵循依赖感知生成策略,确保字段间逻辑关系准确,最终产出1,200条记录,并以Parquet格式存储于HuggingFace平台。
使用方法
用户可通过HuggingFace Datasets库轻松加载该数据集,使用from datasets import load_dataset指令即可获取训练集。加载后调用to_pandas()方法可转换为Pandas DataFrame,便于后续的数据清洗、特征工程或模型训练。数据集仅包含一个默认配置‘data’,无需额外参数调整,开箱即用。推荐在交易策略分析、金融知识问答等任务中作为微调语料或评估基准。
背景与挑战
背景概述
在金融交易与人工智能交叉领域,高质量问答数据集的匮乏长期制约着专业交易大语言模型的研发。trading-qa-data数据集由NVIDIA NeMo Data Designer团队于2026年创建,利用Unsloth Recipe Studio生成1200条合成记录,旨在为量化交易、技术分析及市场情绪解读等金融应用提供结构化问答训练数据。该数据集通过大语言模型和统计采样方法自动化构建,每条记录包含经精心设计的问-答对,覆盖交易策略、风险管理等核心议题,为金融NLP领域提供了人机双验证的基准资源,推动了合成数据在专业领域的实用化进程。
当前挑战
当前trading-qa-data数据集面临多重挑战。在领域问题层面,金融交易问答的复杂性与专业性对数据质量提出严苛要求,合成数据需精确还原真实市场逻辑与专业术语,避免因机械生成导致的语义偏差或常识性错误,这与通用的图像分类任务不同,后者依赖视觉模式识别而无需领域专家深度介入。在构建过程中,仅有1200条样本的规模难以覆盖动态市场中的多模态情境与边缘案例,且依赖单一合成框架可能导致风格固化,加之金融领域数据的高度时效性与隐私约束,使得数据扩展、跨市场泛化及真实性验证成为持续瓶颈。
常用场景
经典使用场景
在金融科技与自然语言处理的交叉领域中,trading-qa-data数据集以其合成的交易问答对形式,为研究者和开发者提供了一种高效的模型训练资源。该数据集包含1,200条由NVIDIA NeMo Data Designer框架生成的记录,每条记录涵盖结构化的大语言模型输出与种子数据字段。其经典使用场景聚焦于金融文本理解与生成任务的微调,例如训练模型以精准回答交易策略、市场分析或风险管理等专业问题,从而提升模型在金融垂直场景下的语义解析与推理能力。
解决学术问题
trading-qa-data数据集直面当前金融自然语言处理领域中高质量标注数据匮乏的痛点。由于真实交易问答数据涉及隐私、商业机密且标注成本高昂,该数据集的合成生成机制有效缓解了数据可用性与多样性的矛盾。它解决了学术研究中模型在金融问答任务上泛化能力不足、领域术语理解偏差等关键问题。通过提供结构化、多字段的问答对,该数据集推动了低资源场景下金融语言模型的预训练与微调研究,为探索合成数据在金融领域的可行性与可靠性奠定了重要基础。
实际应用
在实际应用层面,trading-qa-data数据集可直接服务于智能投顾系统、自动化交易助手及金融客服聊天机器人的开发。基于该数据集微调的模型,能够以自然语言形式响应投资者关于市场趋势、技术指标解析或投资组合评估的查询,显著降低人力咨询成本并提升响应效率。此外,该数据集还适用于金融机构内部的知识管理系统,通过问答交互帮助交易员快速检索特定策略文档或历史案例,从而优化决策流程与风险控制。
数据集最近研究
最新研究方向
该数据集聚焦于金融交易领域的知识问答与自然语言处理的交叉前沿,借助合成数据生成技术构建高质量领域语料库。随着大语言模型在金融场景中的深度渗透,交易策略解析、市场波动归因等复杂任务对专业化问答对的需求与日俱增。trading-qa-data通过利用NVIDIA NeMo框架的合成数据管线,自动化构建了包含1,200条结构化问答样本的基准资源,填补了金融交易领域高质量指令微调数据的空白。其采用依赖感知生成和LLM-as-a-judge质量审核机制,确保了金融领域术语准确性与逻辑一致性,为开发可解释的金融AI助手、驱动量化交易系统的自然语言接口提供了关键基础设施。这一方向与当前华尔街机构加速部署生成式AI进行风险管理和算法交易的热点高度契合,标志着数据集构建正从人工标注向智能合成、从通用领域向垂直精耕的关键转型。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

