japanese-triplet-lifestyle-romance
收藏资源简介:
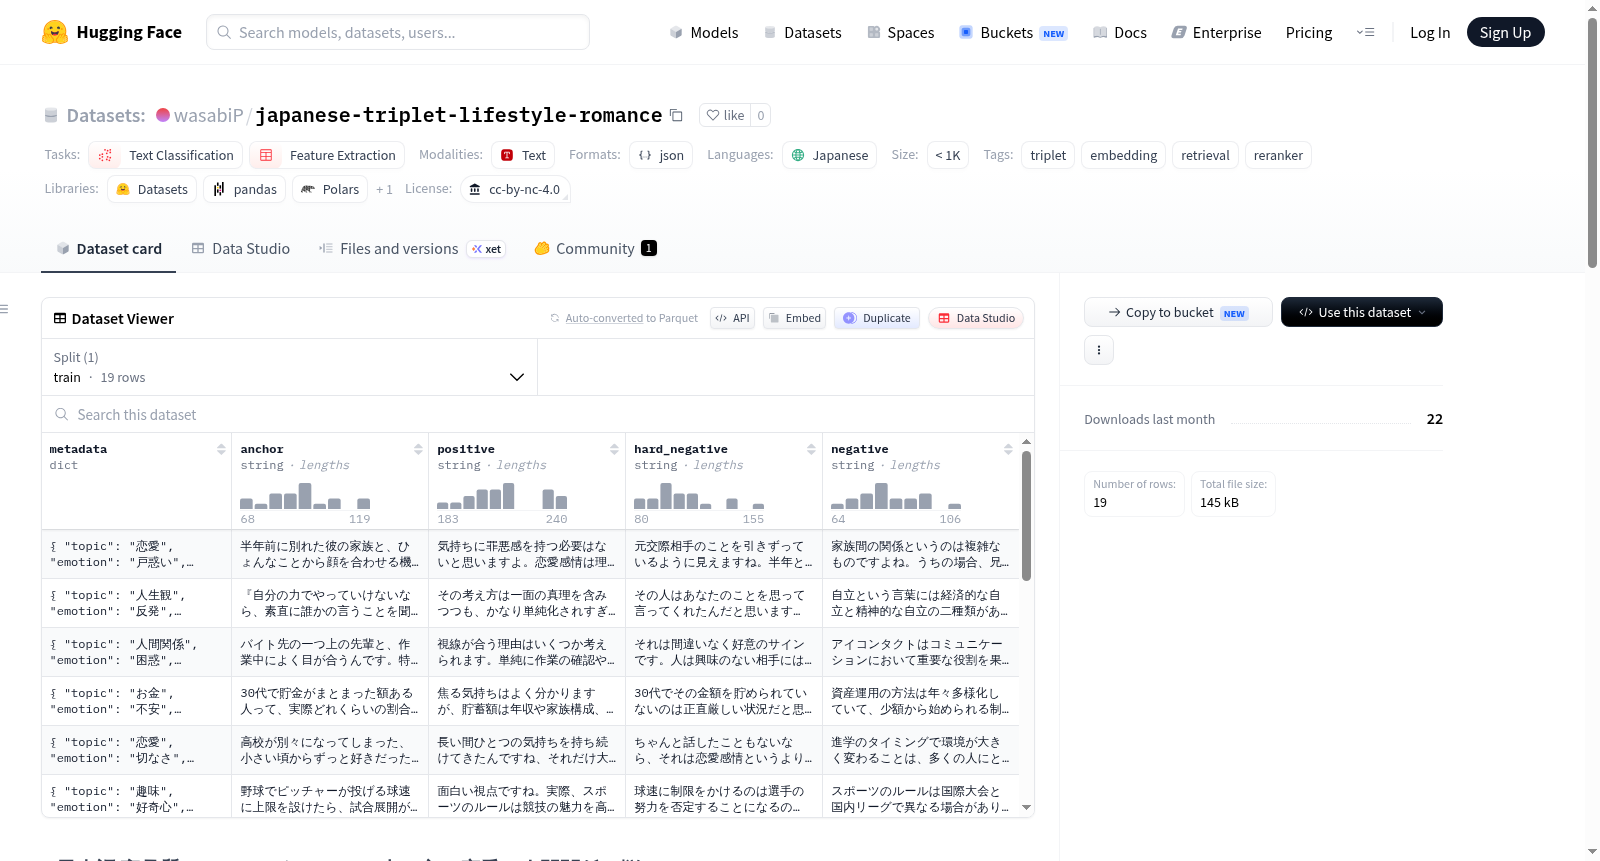
本数据集是一个专注于日语‘生活方式、恋爱、人际关系’咨询主题的高质量文本三元组数据集,旨在通过合成数据训练提升Embedding模型、信息检索和重排序系统的性能。它不是对现有问答数据的直接复制,而是以公开的日语问答数据为灵感来源,由AI从零开始全新生成的合成数据,生成过程确保与源数据在表达上的低相似性,并着重创作了高质量的‘Hard Negative’样本(即看似合理但论点存在细微偏差的错误回答)。每个数据样本包含一个自然生成的咨询文本(Anchor)、一个理想的回答(Positive)、一个高质量的‘Hard Negative’回答,以及一个主题相关但上下文完全不符的错误回答(Negative),并附带丰富的元数据(如咨询主题、主要情感、用户意图、情境摘要、回答风格、紧急度、难度等)。数据集规模小于1千个样本,采用CC-BY-NC-4.0非商业许可发布,商业使用需另行获取授权。
This is a high-quality text triplet dataset focusing on Japanese consultation topics related to 'lifestyle, romance, and interpersonal relationships'. Its core objective is to enhance the performance of embedding models, information retrieval systems, and re-ranking systems through synthetic data training. Unlike direct replication of existing question-answering datasets, this dataset is entirely newly generated synthetic data created by AI from scratch, taking publicly available Japanese question-answering data as an inspirational source. The generation process ensures low expressive similarity to the source data, and places special emphasis on creating high-quality "Hard Negative" samples—i.e., seemingly plausible yet subtly argumentatively deviant incorrect answers. Each data sample includes a naturally generated consultation text (Anchor), an ideal answer (Positive), a high-quality "Hard Negative" answer, an incorrect answer that is topic-related but completely contextually inconsistent (Negative), and is accompanied by rich metadata such as consultation theme, main emotion, user intent, scenario summary, answer style, urgency, difficulty, and more. The dataset consists of fewer than 1,000 samples, and is released under the CC-BY-NC-4.0 non-commercial license. Commercial use requires separate authorization.
数据集概述
基本属性
- 许可证: CC-BY-NC-4.0(非商业用途),商用需另行购买许可
- 任务类型: 文本分类、特征提取
- 语言: 日语
- 标签: 三元组、嵌入、检索、重排序
- 数据规模: 少于1000条
数据来源与性质
- 基于公开日语问答数据,由AI新生成的合成数据
- 完全原创文本,不包含原始数据的句子结构、语序、专有名词等元素
- 原始数据在生成完成后已全部销毁,不包含在最终数据集中
核心特点
- 高质量Hard Negative: 生成逻辑上相似但细微偏差的误导性回答(如论点偏移、情境误解、情感误判),而非简单替换单词
- 自然语言多样性: 模拟日本人自然写作习惯,避免AI模板化表达,AI检测评分达92-95分(满分100)
- 主题范围: 生活方式、恋爱、人际关系类咨询
数据生成与质量保障流程
- 从日本问答平台获取公开咨询作为灵感种子
- 将咨询主题、情感、情境和意图抽象为概念
- 利用Claude仅从抽象概念全新创作三元组,不引用原文
- 通过另一LLM进行短语重叠排除、语法错误检查、AI套话过滤和全量验证
- 人工抽样检查和提交管理
数据格式(JSON)
每条数据包含一个对象,数据结构如下:
| 字段 | 类型 | 说明 |
|---|---|---|
| metadata | 对象 | 包含topic(咨询类型)、emotion(主要情绪)、intent(期待回应方向)、situation(情境概要)、response_style(期望回应风格)、urgency(紧急度:low/medium/high)、difficulty(难度:easy/medium/hard) |
| anchor | 字符串 | 全新创作的咨询文本 |
| positive | 字符串 | 对anchor的理想回答 |
| hard_negative | 字符串 | 看似正确但存在逻辑偏差的高质量错误回答 |
| negative | 字符串 | 主题相近但上下文不匹配的错误回答 |
联系方式
- 商用许可咨询:wasabicatalog@gmail.com
- 完整版数据集即将发布