safi-kinyarwanda-conversations
收藏资源简介:
该数据集名为Safi Kinyarwanda Conversations,包含约1小时的基尼亚卢旺达语会话语音数据。数据通过远程采集自多位受访者回答调查问题的多说话人对话。经过说话人日志(使用pyannote/speaker-diarization-community-1模型)、同一说话人连续语轮合并、最大15秒片段分割、短片段过滤(<1秒移除)、转录、音频质量标注、转录过滤(非空转录)以及元数据丰富(说话人性别、年龄范围等人口统计信息)等处理步骤,最终生成说话人级别的音频片段及其对应的注释。数据集包含原始录音(original_audio/)和处理后的说话人片段(audio_clips/)两种音频级别,以及每个原始录音对应的JSON注释文件(annotations/),注释中包含段级时间戳、转录文本、音频质量标签、说话人映射和人口统计信息。此外,还提供manifest.jsonl作为记录级索引,dataset_summary.json提供聚合统计信息。该数据集适用于基尼亚卢旺达语自动语音识别、说话人感知ASR、会话语音识别、低资源语音建模、多语言语音建模、语音质量鲁棒性评估、模型性能的人口统计分析等任务。注意:说话人日志和映射(基于首次出现顺序)未经验证,可能包含错误;音频质量各异;仅提供段/句子级时间戳,无词级对齐。
The dataset is named Safi Kinyarwanda Conversations, containing approximately 1 hour of conversational speech data in Kinyarwanda. Data was collected remotely via Safis collection engine, recording multi-speaker conversations where respondents answered survey questions. Raw recordings underwent speaker diarization (using pyannote/speaker-diarization-community-1 model), merging consecutive turns from the same speaker, segmentation into chunks of up to 15 seconds, filtering out short segments (<1 second), transcription, audio quality annotation, transcription filtering (non-empty transcriptions), and metadata enrichment (speaker gender, age range, etc.), resulting in speaker-level audio clips with corresponding annotations. The dataset includes two audio levels: raw recordings (original_audio/) and processed speaker segments (audio_clips/), along with JSON annotation files (annotations/) for each raw recording, containing segment-level timestamps, transcriptions, audio quality labels, speaker mapping, and demographic information. Additionally, manifest.jsonl serves as a record-level index, and dataset_summary.json provides aggregated statistics. The dataset is suitable for tasks such as Kinyarwanda automatic speech recognition, speaker-aware ASR, conversational speech recognition, low-resource speech modeling, multilingual speech modeling, speech quality robustness evaluation, and demographic analysis of model performance. Note: Speaker diarization and mapping (based on first occurrence order) are unverified and may contain errors; audio quality varies; only segment/sentence-level timestamps are provided, without word-level alignment.
Safi Kinyarwanda Conversations 数据集详情
数据集概述
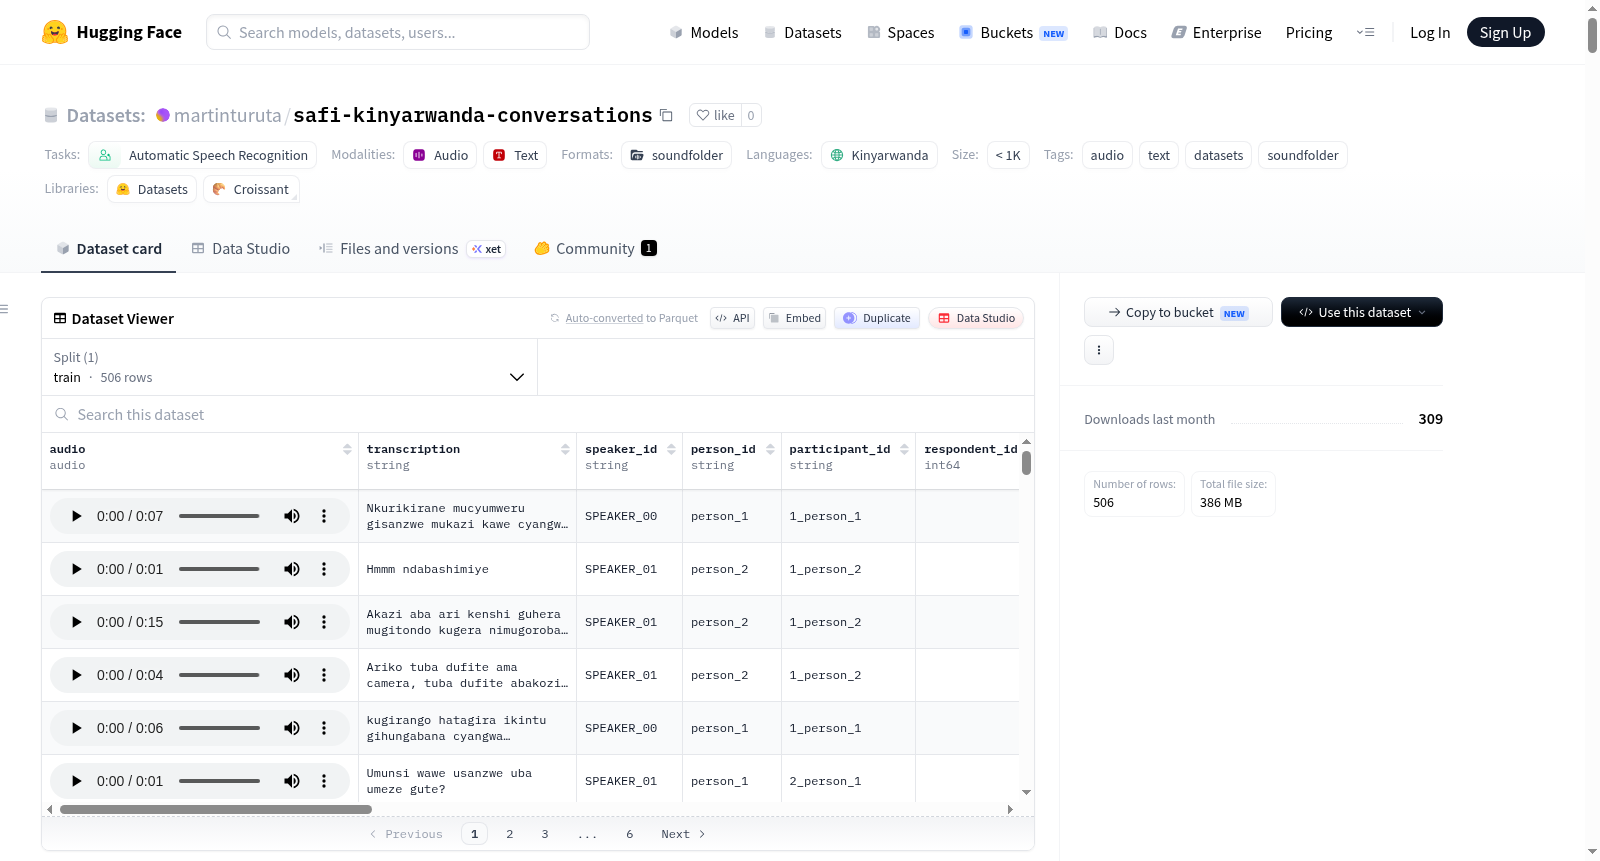
Safi Kinyarwanda Conversations 是一个基尼亚卢旺达语(Kinyarwanda)对话语音数据集,由 Safi 的采集引擎收集,包含 1小时 的对话语音。该数据集适用于自动语音识别(ASR)等任务,样本数量在 1K 到 10K 之间。
数据采集与处理流程
数据集的构建经过以下步骤:
- 音频采集 — 通过 Safi 采集引擎远程收集多说话人调查问卷应答
- 说话人日志分割 — 使用
pyannote/speaker-diarization-community-1识别说话人轮次 - 连续轮次合并 — 将同一说话人的连续轮次进行合并(间隔不超过约2秒)
- 片段生成 — 将合并后的说话人区域切分为最长不超过 15 秒的片段
- 短片段过滤 — 删除少于 1 秒的说话人区域
- 转写 — 对分割后的片段进行文本转写
- 音频质量标注 — 为每个转写片段标注音频质量
- 转写过滤 — 排除无有效转写内容的片段
- 元数据丰富 — 关联说话人的性别、年龄段等人口统计信息
- 句子级对齐标注 — 将转写与说话人及原始录音中的时间戳对应
数据集结构
sentence_aligned_dataset/ ├── original_audio/ # 原始完整多说话人录音 ├── audio_clips/ # 说话人分离后的语音片段 ├── annotations/ # 每个录音对应的JSON标注文件 ├── manifest.jsonl # 录音级索引清单 └── dataset_summary.json # 聚合统计信息
核心内容
原始音频(original_audio/)
保存了日志分割和切分之前的完整多说话人调查录音,保留了完整的对话上下文,可用于复现或评估分割流程。
分离音频片段(audio_clips/)
每个文件名包含:原始录音标识、说话人标签、起始时间戳和结束时间戳。例如 sample_0001_q5_1_SPEAKER_00_000000588_000008384.wav 表示从 sample_0001_q5_1.wav 中提取的 SPEAKER_00 在 0.588 秒至 8.384 秒之间的语音。
标注文件(annotations/)
每个原始录音对应一个 JSON 文件,包含:
- 录音元数据与来源音频信息
- 说话人映射信息(采用首次出现顺序映射,但未经过人工验证)
- 覆盖范围与时间信息(以原始录音开始为参考,单位为秒)
- 时间顺序的语音片段及句子级时间对齐
- 转写文本与音频质量标注
- 说话人人口统计信息(性别、年龄段)
- 完整说话人级转写
关键字段说明
| 字段 | 说明 |
|---|---|
segment_id |
片段唯一标识 |
speaker_id |
日志分割分配的说话人标签 |
person_id |
调查回复中的人物标识 |
participant_id |
参与者级唯一标识(结合受访者与人物ID) |
transcript.text |
片段转写文本 |
audio_quality.labels |
标准化音频质量标签 |
timing |
相对原始录音的开始/结束/持续时间 |
音频质量标注
质量标签包括:clear_audio(清晰音频)、loud_background_noise(严重背景噪声)、background_noise(背景噪声)、low_volume(音量较低)、clipping(削波)、distortion(失真)、overlapping_speech(语音重叠)、inaudible(听不清)、truncated(截断)等,可用于按录音条件过滤数据或评估模型在不同条件下的表现。
说话人标识体系
- respondent_id:标识调查回复或录音组
- person_id:标识调查回复中的某个人物
- participant_id:组合前两者形成的参与者级唯一标识(如
1_person_1)
人口统计元数据
包含规范化的性别标签(gender)、原始基尼亚卢旺达语回答(gender_raw,如 Umugabo 表示男性,Umugore 表示女性)、年龄段(age_range)及原始综合回答(raw_value)。
时间覆盖与限制说明
每个标注包含 coverage 对象,记录了首个包含片段的起始时间、最后一个片段的结束时间以及所有片段的总时长。由于短于1秒的区域和无有效转写的片段会被移除,处理后的包含时长可能短于原始录音的总时长。
预期用途
该数据集可支持以下任务:
- 基尼亚卢旺达语自动语音识别与转写
- 说话人感知的语音识别
- 对话语音识别
- 说话人日志分割研究
- 低资源语言语音建模
- 多语言语音建模
- 语音质量鲁棒性评估(含噪声条件下的模型评估)
- 语音模型性能的人口统计分析
- 对话调查数据的语音处理流水线开发
局限性
- 说话人日志分割由模型生成,可能存在说话人归属或边界错误
- 说话人标签与调查参与者之间的映射基于首次出现顺序且未经过人工验证(
verified = false) - 音频质量在不同录音和片段间存在差异,需依据质量标注进行筛选
- 仅提供片段/句子级时间戳,不支持词级对齐
- 处理后的片段不包含原始录音中所有语音内容,无有效转写的片段已被排除
其他说明
数据集仅为开发或测试样本,完整数据集或定制数据集可联系 hq@safidata.com,或访问 https://www.safidata.com/ 获取。