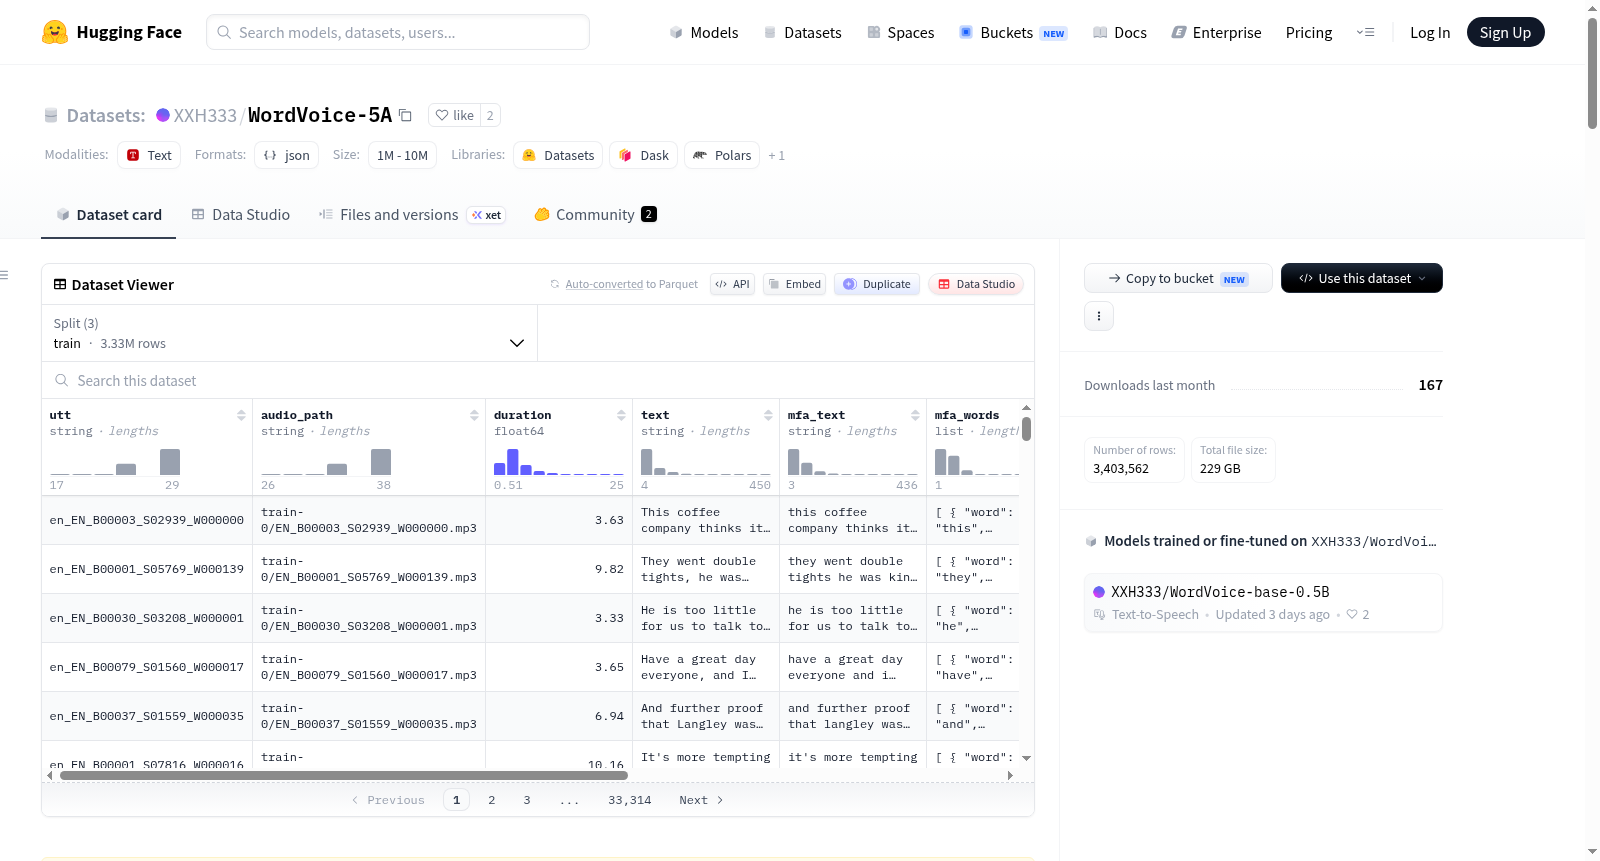
WordVoice-5A
收藏资源简介:
WordVoice-5A是一个大规模、高质量的中英双语字/词级声学属性标注数据集,专为高精度、细粒度可控语音合成(TTS)设计。该数据集旨在解决开源社区中缺乏大规模、高质量字/词级对齐与显式声学标注数据的问题。原始语音与文本数据来源于开源的LEMAS语料库,核心贡献在于对原始数据进行了深度的五维声学属性标注,而非单纯的数据清洗。数据集包含约4,684小时的高质量语音,其中中文2,546小时,英文2,138小时,共提供超过5,200万个字/词级标注。通过自动化标注Pipeline,结合语言学规则与真实声学统计分布,并采用MFA与Qwen3FA双模型交叉对齐及基于响度的边界优化策略,为每个字/词精确提取并标注了五维核心声学属性:1. 时长(Duration):字/词的实际发音时长(秒);2. 声学边界(Acoustic Boundary):表示字/词后的停顿等级,分为b0(无停顿)、b1(微停顿≤0.05秒)、b2(词边界≤0.18秒)、b3(逗号级边界≤0.40秒)、b4(句号级边界>0.40秒)五类;3. 能量(Energy):字/词级归一化有效响度,范围[0, 1];4. 音高(Pitch):字/词级核心音高均值,归一化范围[-1, 1];5. 音调(Tone):描述字内音高变化轮廓,分为flat(平)、rise(升)、rrise(快升)、fall(降)、ffall(快降)、peak(峰)、valley(谷)七类。数据以JSONL格式提供,每条记录包含音频路径、转录文本以及对应的字/词列表和上述五维属性数组。该数据集主要面向以下研究方向:训练支持显式字级声学控制的可控TTS模型;研究中英双语连续语流中的微观韵律及协同发音规律。此外,也适用于有声书与视频配音中的精准局部韵律编辑、跨语种字/词级声学特征分析以及韵律预测等任务。WordVoice-5A是WordVoice项目的核心组成部分,致力于打破基于大语言模型(LLM)的TTS系统的“黑盒”特性,推动细粒度语音生成与声学建模的研究。
WordVoice-5A is a large-scale, high-quality Chinese-English bilingual character/word-level acoustic attribute annotation dataset, specifically designed for high-precision, fine-grained controllable speech synthesis (TTS). It aims to address the lack of large-scale, high-quality character/word-level aligned and explicit acoustic annotation data in the open-source community. The original speech and text data are sourced from the open-source LEMAS corpus, with the core contribution being in-depth five-dimensional acoustic attribute annotation of the raw data, rather than mere data cleaning. The dataset contains approximately 4,684 hours of high-quality speech, including 2,546 hours of Chinese and 2,138 hours of English, providing over 52 million character/word-level annotations. Through an automated annotation pipeline combining linguistic rules and real acoustic statistical distributions, and employing MFA and Qwen3FA dual-model cross-alignment with loudness-based boundary optimization strategies, it precisely extracts and annotates five core acoustic attributes for each character/word: 1. Duration: the actual pronunciation duration (in seconds) of the character/word; 2. Acoustic Boundary: indicates the pause level after the character/word, categorized into b0 (no pause), b1 (micro-pause ≤0.05 seconds), b2 (word boundary ≤0.18 seconds), b3 (comma-level boundary ≤0.40 seconds), b4 (period-level boundary >0.40 seconds) five classes; 3. Energy: character/word-level normalized effective loudness, range [0, 1]; 4. Pitch: character/word-level core pitch mean, normalized range [-1, 1]; 5. Tone: describes the pitch change contour within the character, categorized into flat, rise, rrise (rapid rise), fall, ffall (rapid fall), peak, valley seven classes. The data is provided in JSONL format, with each record containing the audio path, transcribed text, and the corresponding character/word list along with the five-dimensional attribute array. The dataset is primarily targeted at the following research directions: training controllable TTS models that support explicit character-level acoustic control; studying micro-prosody and coarticulation patterns in continuous Chinese-English bilingual speech flow. Additionally, it is suitable for tasks such as precise local prosody editing in audiobooks and video dubbing, cross-lingual character/word-level acoustic feature analysis, and prosody prediction. WordVoice-5A is a core component of the WordVoice project, dedicated to breaking the black box nature of large language model (LLM)-based TTS systems and advancing research in fine-grained speech generation and acoustic modeling.
数据集概览
WordVoice-5A 是一个大规模中英双语字/词级声学属性标注数据集,专为高精度、细粒度可控语音合成(TTS)设计。
- 总时长:约 4,684 小时(中文 2,546 小时 / 英文 2,138 小时)
- 标注总数:超过 5,200 万字/词级标注
- 数据来源:原始语音与文本来源于开源 LEMAS 语料库
- 核心贡献:对原始数据进行深度标注,而非单纯数据清洗,通过严格的双模型交叉对齐与语言学指导自动化 Pipeline,为每个字/词提取并标注五维声学属性。
五维声学标注
每个字/词均包含以下五维核心属性:
- 时长(Duration):字/词的实际发音时长,以秒为单位的浮点数。
- 声学边界(Acoustic Boundary):字/词后的停顿等级,共 5 类:
b0:无停顿b1:≤ 0.05 秒(微停顿)b2:≤ 0.18 秒(词边界)b3:≤ 0.40 秒(逗号级边界)b4:> 0.40 秒(句号级边界)
- 能量(Energy):字/词级归一化有效响度,浮点数,范围 [0, 1]。
- 音高(Pitch):字/词级核心音高均值,浮点数,范围 [-1, 1]。
- 音调(Tone):字内音高变化轮廓,共 7 类:
flat(平)、rise(升)、rrise(急升)、fall(降)、ffall(急降)、peak(峰)、valley(谷)。
数据格式与结构
- 格式:JSONL 格式,配有对应音频文件。
- 每条记录包含:音频路径、文本、字/词级五维声学属性标注。
- 时间戳精度:采用 MFA 与 Qwen3FA 双模型交叉对齐,并结合基于响度的边界优化策略,保证高精度。
数据示例: json { "utt": "zh_WenetSpeech4TTS_0001681467", "audio_path": "test/WenetSpeech4TTS_0001681467.mp3", "duration": 1.92, "text": "真是巧啊。", "mfa_text": "真 是 巧 啊", "mfa_words": [ {"word": "真", "start": 0.69, "end": 0.84}, {"word": "是", "start": 0.84, "end": 0.95}, {"word": "巧", "start": 0.95, "end": 1.16}, {"word": "啊", "start": 1.17, "end": 1.34}], "f0": [-0.2686, -0.246, -0.3819, -0.6745], "eng": [0.5415, 0.4326, 0.3464, 0.2612], "tone": ["flat", "flat", "fall", "fall"], "bnd": ["b0", "b0", "b1", "b4"] }
关键特点
- 五维字级标注:每个字/词包含精准的时长、5级声学边界、能量、音高和7类音调标注。
- 超大规模双语语料:是目前已知规模最大、标注维度最完整的字/词级控制数据集之一。
- 语言学专家指导标注:标注标准与阈值基于真实数据分布与语言学规则设计(如协同发音感知截断、二次曲线音调拟合)。
- 高精度时间戳:双模型对齐与响度优化确保字/词级时间戳高保真。
使用场景
- 细粒度可控 LLM-TTS 模型训练
- 字/词级韵律建模
- 有声书与视频配音中的精准局部韵律编辑
- 跨语种字/词级声学特征分析
- 韵律预测
生态系统
本数据集是 WordVoice 项目的核心部分,相关资源:
- 数据处理流水线:WordVoice Data Pipeline — 用于构建本数据集的语言学指导自动化标注工具包。
- 预训练 TTS 模型:WordVoice Model — 支持显式多维字级控制的 TTS 框架官方实现。
许可协议
本数据集基于 MIT 协议 开源。