jwlang
收藏资源简介:
JWLang Corpus是一个包含来自jw.org网站的JW Broadcasting视频的音频和相应文本数据的数据集。它专为训练和微调自动语音识别(ASR)模型,特别是OpenAI Whisper而设计。数据集包含10,000个样本,格式为WAV音频和SRT文本,总大小为5GB,分为8,000个训练样本、1,000个验证样本和1,000个测试样本。
JWLang Corpus is a dataset containing audio and corresponding text data from JW Broadcasting videos sourced from the jw.org website. It is specifically designed for training and fine-tuning automatic speech recognition (ASR) models, especially OpenAI Whisper. The dataset includes a total of 10,000 samples in WAV audio and SRT text formats, with an overall size of 5GB, and is split into 8,000 training samples, 1,000 validation samples, and 1,000 test samples.
JWLang Corpus 数据集概述
数据集总结
JWLang Corpus 是一个包含音频和相应文本数据的集合,源自 JW Broadcasting 视频,可在 jw.org 网站上获取。该数据集旨在用于训练和微调自动语音识别(ASR)模型,特别是 OpenAI Whisper。数据集存储在 Hugging Face 上的 Parquet 格式中,原始音频文件为 MP3 格式,相应的文本文件。数据于 2024 年 6 月下载。
数据集配置
数据集包含以下语言配置:
- 德语(de)
- 西班牙语(es)
- 法语(fr)
- 意大利语(it)
- 荷兰语(nl)
- 葡萄牙语(pt)
- 瑞典语(sv)
数据集特征
每个语言配置包含以下特征:
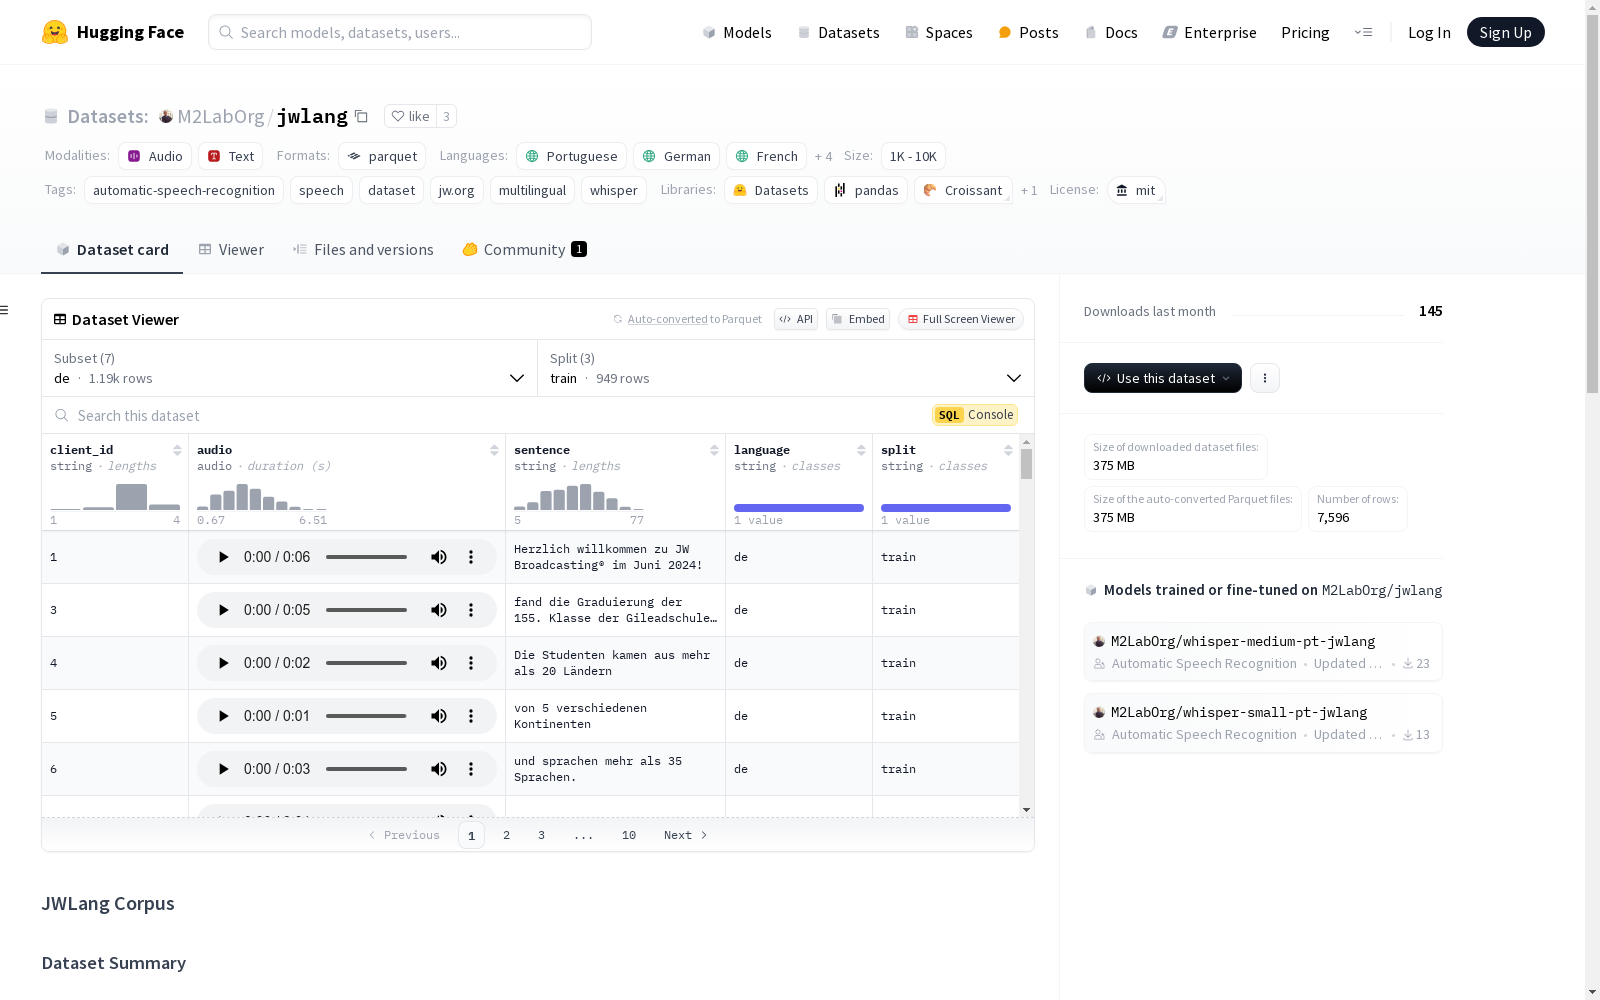
client_id: 字符串类型audio: 音频类型sentence: 字符串类型language: 字符串类型split: 字符串类型
数据集分割
每个语言配置包含以下分割:
train: 训练集test: 测试集val: 验证集
数据集大小
每个语言配置的数据集大小如下:
德语(de)
- 下载大小: 223549840 字节
- 数据集大小: 56000194.0 字节
- 训练集: 44420148.0 字节, 949 个样本
- 测试集: 5730879.0 字节, 119 个样本
- 验证集: 5849167.0 字节, 119 个样本
西班牙语(es)
- 下载大小: 53591020 字节
- 数据集大小: 53824314.0 字节
- 训练集: 43155769.0 字节, 973 个样本
- 测试集: 5317858.0 字节, 122 个样本
- 验证集: 5350687.0 字节, 122 个样本
法语(fr)
- 下载大小: 102271952 字节
- 数据集大小: 51271447.0 字节
- 训练集: 40751557.0 字节, 939 个样本
- 测试集: 5126357.0 字节, 118 个样本
- 验证集: 5393533.0 字节, 117 个样本
意大利语(it)
- 下载大小: 49525612 字节
- 数据集大小: 49636231.0 字节
- 训练集: 39862874.0 字节, 779 个样本
- 测试集: 5231142.0 字节, 98 个样本
- 验证集: 4542215.0 字节, 97 个样本
荷兰语(nl)
- 下载大小: 53882775 字节
- 数据集大小: 53975677.0 字节
- 训练集: 42915800.0 字节, 720 个样本
- 测试集: 5778737.0 字节, 91 个样本
- 验证集: 5281140.0 字节, 90 个样本
葡萄牙语(pt)
- 下载大小: 340665914 字节
- 数据集大小: 56922121.152 字节
- 训练集: 45540940.152 字节, 1004 个样本
- 测试集: 5906213.0 字节, 126 个样本
- 验证集: 5474968.0 字节, 125 个样本
瑞典语(sv)
- 下载大小: 54362862 字节
- 数据集大小: 54443241.0 字节
- 训练集: 43664659.0 字节, 710 个样本
- 测试集: 5357869.0 字节, 89 个样本
- 验证集: 5420713.0 字节, 89 个样本
数据集使用
加载和使用数据集的示例代码: python from datasets import load_dataset
dataset = load_dataset("M2LabOrg/jwlang")
示例数据
数据集中的示例文本片段: json { "audio": "path/to/audio.mp3", "text": "Example subtitle text." }
许可证
该数据集是私有的,仅供内部使用。
引用
如果使用此数据集,请引用:
@article{jwlang_corpus, title={JWLang Corpus from jw.org Videos for ASR Training}, author={Michel Mesquita}, journal={Unpublished}, year={2024}, note={Data downloaded from jw.org in June 2024 and processed by M. Mesquita} }
联系
如有任何问题或疑问,请联系 Michel Mesquita。