
遇见数据集

Maktabati/openiti-vectors

收藏
Hugging Face2026-05-30 更新2026-05-31 收录
官方服务:

资源简介:

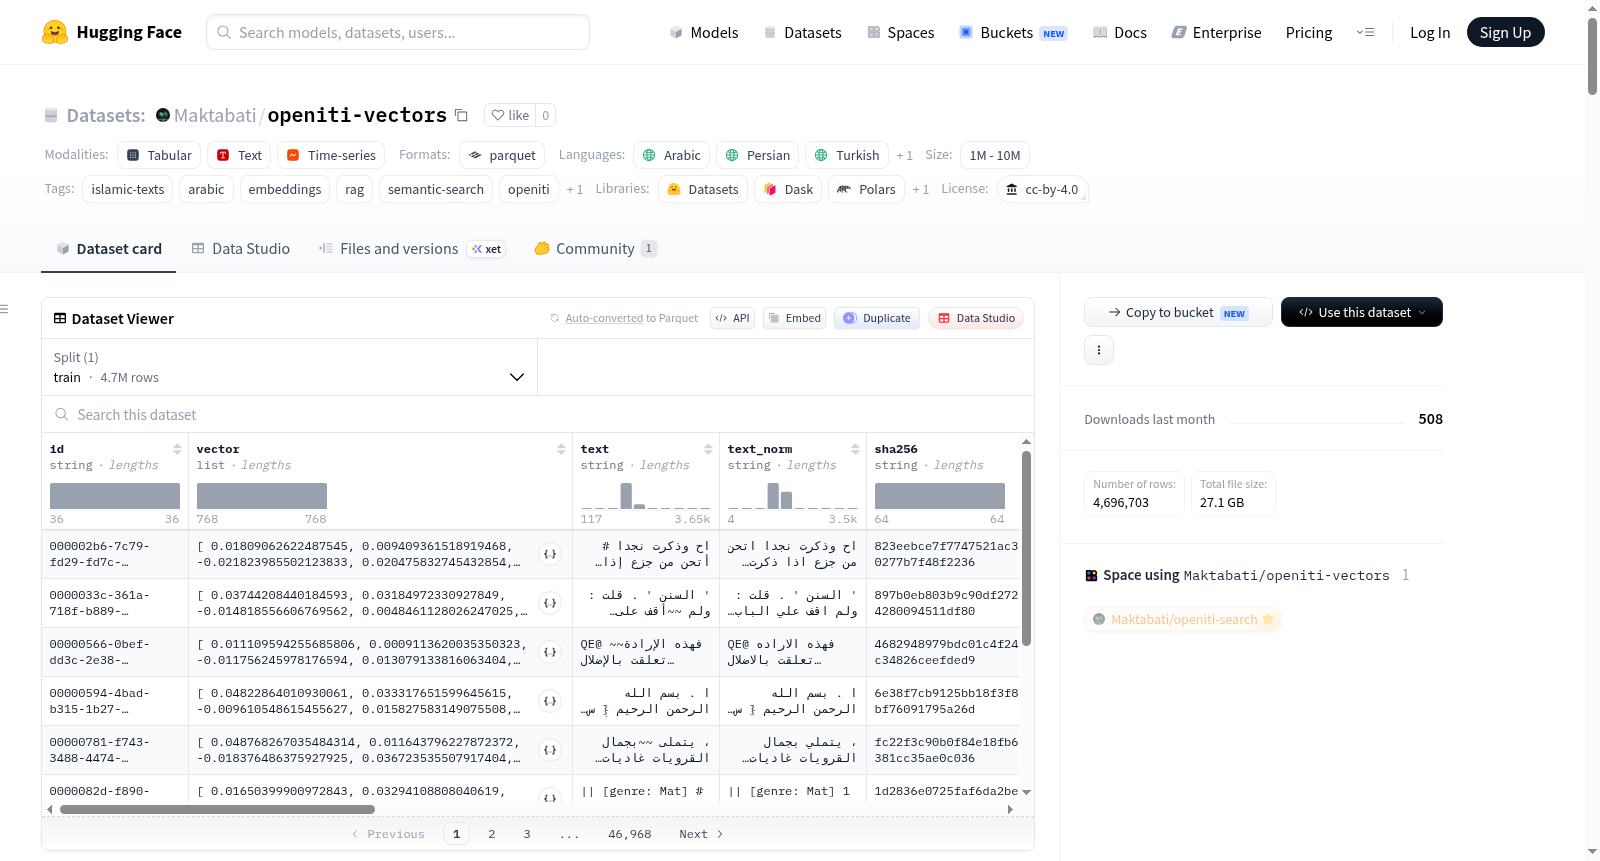
该数据集包含完全向量化的OpenITI RELEASE 2025-1-9古典伊斯兰文本集合,专为语义搜索(RAG)准备。每个条目代表OpenITI语料库中8,943部作品之一的文本块,以及其嵌入向量和完整的元数据。统计信息:4,696,703个文本块;8,943部作品(仅主要版本,来自OpenITI TSV的status=pri);约470个Parquet文件(每个约45MB,zstd压缩);时间跨度:伊斯兰历1世纪至14世纪;语言:阿拉伯语(主要)、波斯语、土耳其语、乌尔都语。

This dataset contains the fully vectorized OpenITI RELEASE 2025-1-9 collection of classical Islamic texts, specifically tailored for semantic search (RAG) applications. Each entry corresponds to a text chunk from one of the 8,943 works in the OpenITI corpus, paired with its embedding vectors and complete metadata. Key statistical metrics: 4,696,703 text chunks; 8,943 primary-version works (filtered by the status=pri tag from the OpenITI TSV dataset); approximately 470 Parquet files, each ~45 MB in size and compressed with zstd; Time span: 1st century AH to 14th century AH; Languages: primarily Arabic, alongside Persian, Turkish, and Urdu.
提供机构:
Maktabati
搜集汇总
数据集介绍
Maktabati/openiti-vectors 数据集图片
构建方式
该数据集基于OpenITI RELEASE 2025-1-9版本的经典伊斯兰文本语料库构建而成。原始语料涵盖超过一万四千部作品,为避免重复内容干扰语义检索的准确性,仅选取其中状态标记为“pri”(即初版)的版本,并在多版并存时以字符长度最长者为准,从而筛选出8,943部独有著作。随后,利用`intfloat/multilingual-e5-base`嵌入模型以512个token为分块单位、50个token为重叠窗口,将文本切分为超过469万个语义片段,并生成768维的余弦距离向量。全部计算过程均在一台配备AMD Ryzen 9 5900X处理器与Radeon RX 6900 XT显卡的消费级个人计算机上完成,未依赖任何云端服务,确保了流程的完全可复现性。
使用方法
研究者可借助Qdrant向量数据库高效使用该数据集。首先通过Python的PyArrow库读取Parquet格式的分片文件,并利用Qdrant客户端在本地或远程服务器上创建指定向量维度与距离度量的集合,将每个数据点的向量与载荷(即元数据字段)批量导入。启用HNSW索引后,即可执行高效的近似最近邻搜索。在检索时,需使用`query: `前缀封装用户查询文本,并通过同一`multilingual-e5-base`模型生成查询向量,随后调用Qdrant的搜索接口,根据余弦相似度返回最相关的文本块。用户亦可依据作者、书名等字段构建过滤条件,实现更具针对性的语义搜索,为经典伊斯兰文本的分析与知识发现开辟了便捷的数字化通道。
背景与挑战
背景概述
OpenITI Vector Database(maktabati.ai)于2026年由maktabati.ai项目团队创建,旨在为古典伊斯兰文本提供大规模语义检索能力。该数据集基于OpenITI RELEASE 2025-1-9语料库,涵盖从伊历1世纪至14世纪的8,943部经典著作,语言以阿拉伯语为主,兼涉波斯语、土耳其语和乌尔都语。通过将4,696,703个文本片段嵌入768维向量空间,研究团队系统性地解决了古典阿拉伯语文献数字化检索中长久存在的语义鸿沟问题,为伊斯兰研究、历史文献学及数字人文学科提供了关键基础设施,其影响力体现在推动了低资源语言与古文书的向量化检索范式。
当前挑战
该数据集面对的核心领域挑战是古典伊斯兰文本的异构性与语义复杂性:文本年代跨度大、语言变体繁多(如阿拉伯语无元音书写、波斯语与奥斯曼土耳其语的混合),传统关键词搜索难以捕捉跨语言、跨版本的概念关联。在构建过程中,团队需处理OpenITI原始语料中超过14,000个文件的多版本冗余问题,通过筛选主版本(status=pri)并保留最长字符版本,将作品数精简至8,943部以避免检索重复。此外,在消费级硬件(AMD Ryzen 9 5900X、Radeon RX 6900 XT)上完成全部嵌入与索引,需优化生成式AI模型(multilingual-e5-base)的显存占用与分块策略,同时保证4.7百万条向量在无云服务环境下的可复现性,最终以Parquet格式高效存储并兼容Qdrant向量数据库的快速导入。
常用场景
经典使用场景
OpenITI Vectors数据集的核心应用场景在于语义检索与检索增强生成(RAG)系统的构建。它将跨越十四个世纪的八干余部伊斯兰古典文本切分为约四百七十万个语义单元,并利用多语言嵌入模型进行向量化表征。研究者借助这一资源,能够在庞大的古典阿拉伯语、波斯语、土耳其语和乌尔都语文献中实现基于语义而非关键词的精准查询。例如,学者可以输入特定教义或历史事件的相关描述,系统便能从伊本·凯西尔或塔巴里等经典著作中召回最为匹配的段落,极大提升了伊斯兰学术研究的检索效率与深度。
解决学术问题
该数据集有效应对了古典伊斯兰文献研究中长期存在的两大难题:多版本冗余与语义鸿沟。通过对OpenITI语料库中超过一万四千份文件进行筛选,仅保留唯一且内容最详尽的初版,避免了检索结果中的内容重复问题。同时,采用先进的嵌入技术将文本转化为稠密向量,使得研究者能够跨越词汇层面的差异,直接根据语义相似度进行文献挖掘。这为伊斯兰思想史、教义学、历史编纂学等领域的大规模文本分析提供了前所未有的工具,使得跨著作、跨时代的主题追踪与概念比较变得可行且高效。
实际应用
在实际应用中,该数据集已作为maktabati.ai搜索引擎的核心后端,支撑着一个面向公众的古典伊斯兰文本语义检索界面。用户无需任何技术配置,即可通过浏览器对海量文献进行关键词搜索。对于开发者而言,该数据集支持导入Qdrant等向量数据库,并可集成至定制化的RAG管道中,用于构建智能问答系统、学术辅助工具或数字人文研究平台。此外,其多语言特性使得跨语言文献的联合检索成为可能,服务于全球范围内伊斯兰研究学者、宗教学者和翻译工作者。
数据集最近研究
最新研究方向
在当前大语言模型与检索增强生成(RAG)技术蓬勃发展的背景下,openiti-vectors数据集为古典伊斯兰文本的语义搜索与知识发现开辟了崭新路径。该数据集将OpenITI语料库中跨越千年的八干余部经典著作,切割为四百七十万文本片段并嵌入768维向量,使研究者能够利用自然语言精准检索《塔巴里历史》等传世文献中的孤立典故或教法判例。其全部工作均在消费级硬件上用开源工具复现,呼应了低门槛、去中心化的学术基础设施理念,不仅推动了伊斯兰数字人文学科从字符匹配向语义理解的范式跃迁,更在全球多元文明对话中为阿拉伯—伊斯兰知识遗产的智能化活化提供了可复用的关键数字资产。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

