TTS-AGI/LAION-DISCO-12M
收藏资源简介:
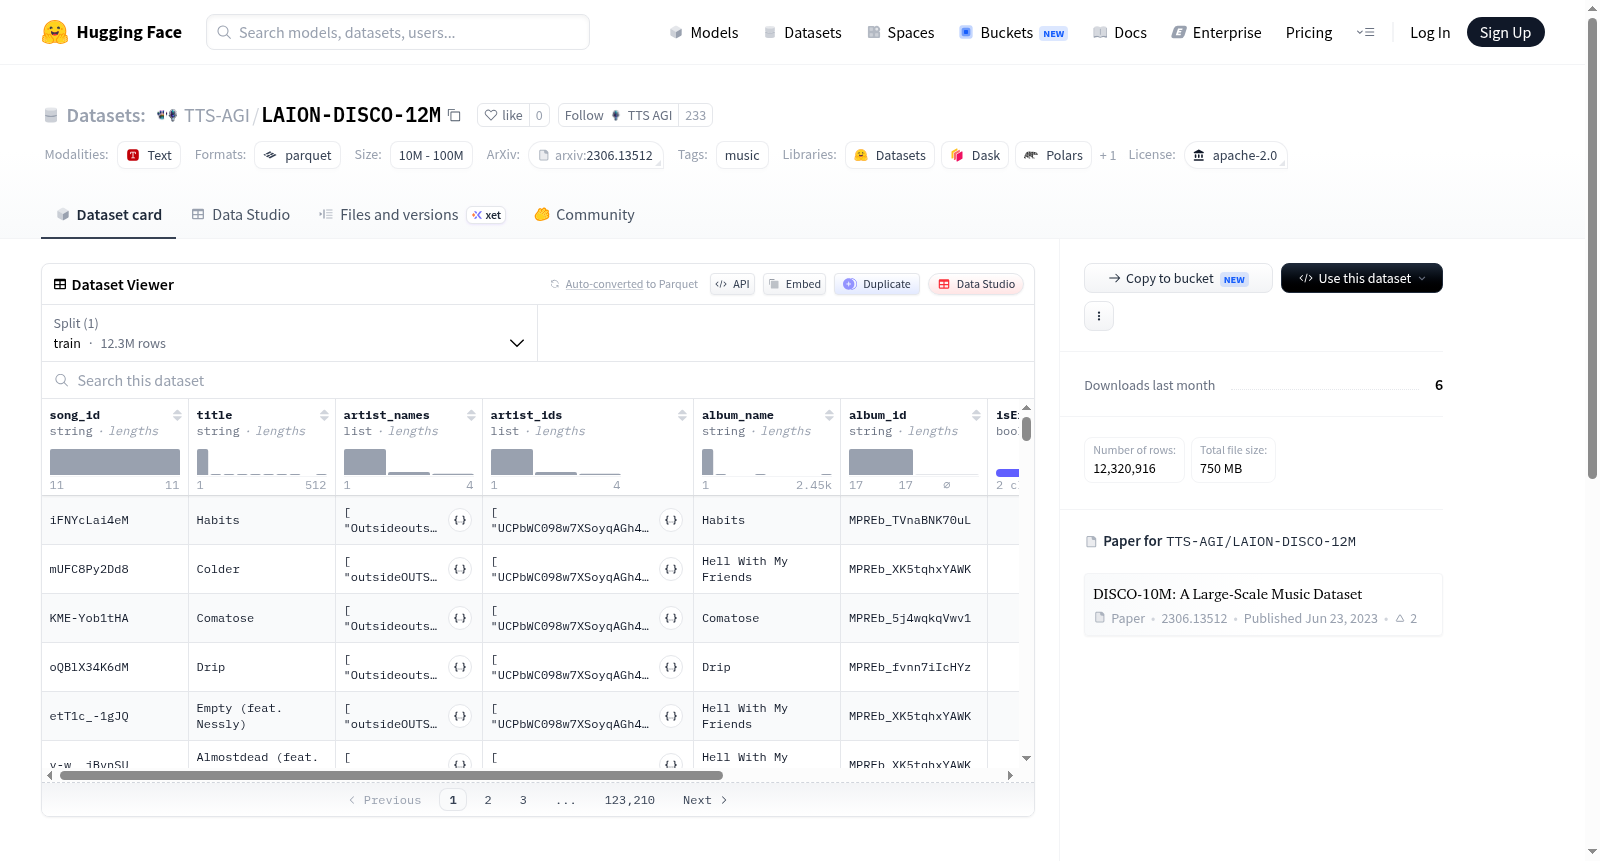
LAION-DISCO-12M数据集包含1200万条指向YouTube音乐的链接,灵感来源于DISCO-10M的方法论。该数据集包含歌曲元数据(如歌曲ID、标题、艺术家名称、艺术家ID、专辑名称、专辑ID、是否包含明确内容、观看次数、时长)和YouTube URL,指向公共网络上的原始歌曲。它不包含任何原始音频样本,因此是一个索引数据集。从初始的艺术家种子列表开始,通过递归探索“粉丝可能也喜欢”部分,可以发现新艺术家。我们尽可能长时间地探索相关艺术家图谱,以找到新艺术家。对于给定艺术家,可以提取其元数据,如名称和订阅者数量,以及所有歌曲和音乐视频列表。重要的是,每首歌曲或音乐视频都与一个YouTube URL(从其ID获得)相关联。收集的元数据字段包括:song_id、title、artist_names、artist_ids、album_name、album_id、isExplicit、views、duration。DISCO-10M的作者使用了18位艺术家的种子列表,以代表多种流派。但我们发现这对于探索YouTube音乐的艺术家图谱不够充分。从这个种子列表开始,我们仅发现了90,007位艺术家和5,399,389首歌曲。因此,我们通过考虑出现在YouTube音乐国家热门歌曲排行榜和流派播放列表中的艺术家,编制了一个更大的种子列表。这产生了45,218位艺术家的初始列表。从这个种子列表开始的艺术家图谱探索,最终得到了250,516位艺术家和12,648,485首歌曲。这项工作受到DISCO-10M的启发,如果您使用此数据集,请考虑引用他们。
The LAION-DISCO-12M dataset contains 12 million links to YouTube Music, inspired by the methodology of DISCO-10M. This dataset includes song metadata (such as song ID, title, artist name, artist ID, album name, album ID, explicit content indicator, view count, duration) and YouTube URLs pointing to the original songs on the public web. It does not contain any raw audio samples, thus functioning as an indexing dataset. Starting from an initial list of artist seeds, new artists can be discovered by recursively exploring the "Fans also like" section. We explore the associated artist graph for as long as possible to identify new artists. For a given artist, their metadata such as name and subscriber count can be extracted, alongside a full list of their songs and music videos. Importantly, each song or music video is associated with a YouTube URL derived from its unique ID. The collected metadata fields include: song_id, title, artist_names, artist_ids, album_name, album_id, isExplicit, views, duration. The authors of DISCO-10M utilized a seed list of 18 artists to represent a diverse range of music genres. However, we found this list insufficient for exploring the artist graph of YouTube Music. Starting from this seed list, we only discovered 90,007 artists and 5,399,389 songs. Therefore, we compiled a larger seed list by incorporating artists featured on YouTube Music's national top song charts and genre playlists. This resulted in an initial list of 45,218 artists. Artist graph exploration initiated from this expanded seed list ultimately yielded 250,516 artists and 12,648,485 songs. This work was inspired by DISCO-10M; if you use this dataset, please consider citing their work.