
遇见数据集

Data-Gouv-FR/corpus-de-documents-numerises-des-archives-nationales

收藏
Hugging Face2026-05-29 更新2026-05-31 收录
官方服务:

资源简介:

该数据集名为法国国家档案馆数字化文档语料库,收录了法国国家档案馆在线门户上可访问的数字化档案文档。这些文档包括文本、照片、地图、图纸和版画等多种类型,可通过机构的虚拟阅览室进行查阅和下载。数据集包含以下字段:数字化档案标题、在线门户URL(可能为多值,用|分隔)、数字化来源介质(原始文档-彩色或缩微胶片-黑白或灰度)、图像数量(近似值,基于数字化清点表或文件命名)、档案引用(档案编号、编号根或编号组)、档案状态(公共、私有或混合;公共档案可自由复制和重用,私有档案可能需要授权)、文档类型索引(多值,用|分隔)、主题索引(多值,用|分隔)、地理索引、时期索引(世纪和特定事件;多值,用|分隔)、相关人员索引(个人或家庭;多值,用|分隔)、XML格式档案目录下载链接以及备注(包含图像文件的命名根)。数据集每年更新两次,以添加新的在线可访问数字化档案语料库。初始版本于2025年10月14日发布,包含507条记录。

The dataset Corpus de documents numérisés des Archives nationales lists digitized archival documents accessible on the French National Archives online portal. These documents include texts, photographs, maps, drawings, prints, etc., and can be consulted and downloaded via the institutions virtual reading room. The dataset consists of the following fields: title of the digitized corpus, URL to the inventory and images on the portal (sometimes multi-valued, separated by |), original medium of digitization (original document - color - or microform - black and white or grayscale), approximate number of images (based on digitization inventory tables or file naming), archival references (call numbers, root numbers, or groups of call numbers), archival status (public, private, or mixed; public archives are freely reproducible and reusable, while private archives may require authorization), document type index (multi-valued, separated by |), thematic index (multi-valued, separated by |), geographical index, chronological period index (century and specific events; multi-valued, separated by |), person index (individual or family; multi-valued, separated by |), download link for the archival inventory in XML format, and observations (including naming roots for image files). Updates are made twice a year to add new digitized archival corpora available online. The first version was published on October 14, 2025, with 507 entries.
提供机构:
Data-Gouv-FR
搜集汇总
数据集介绍
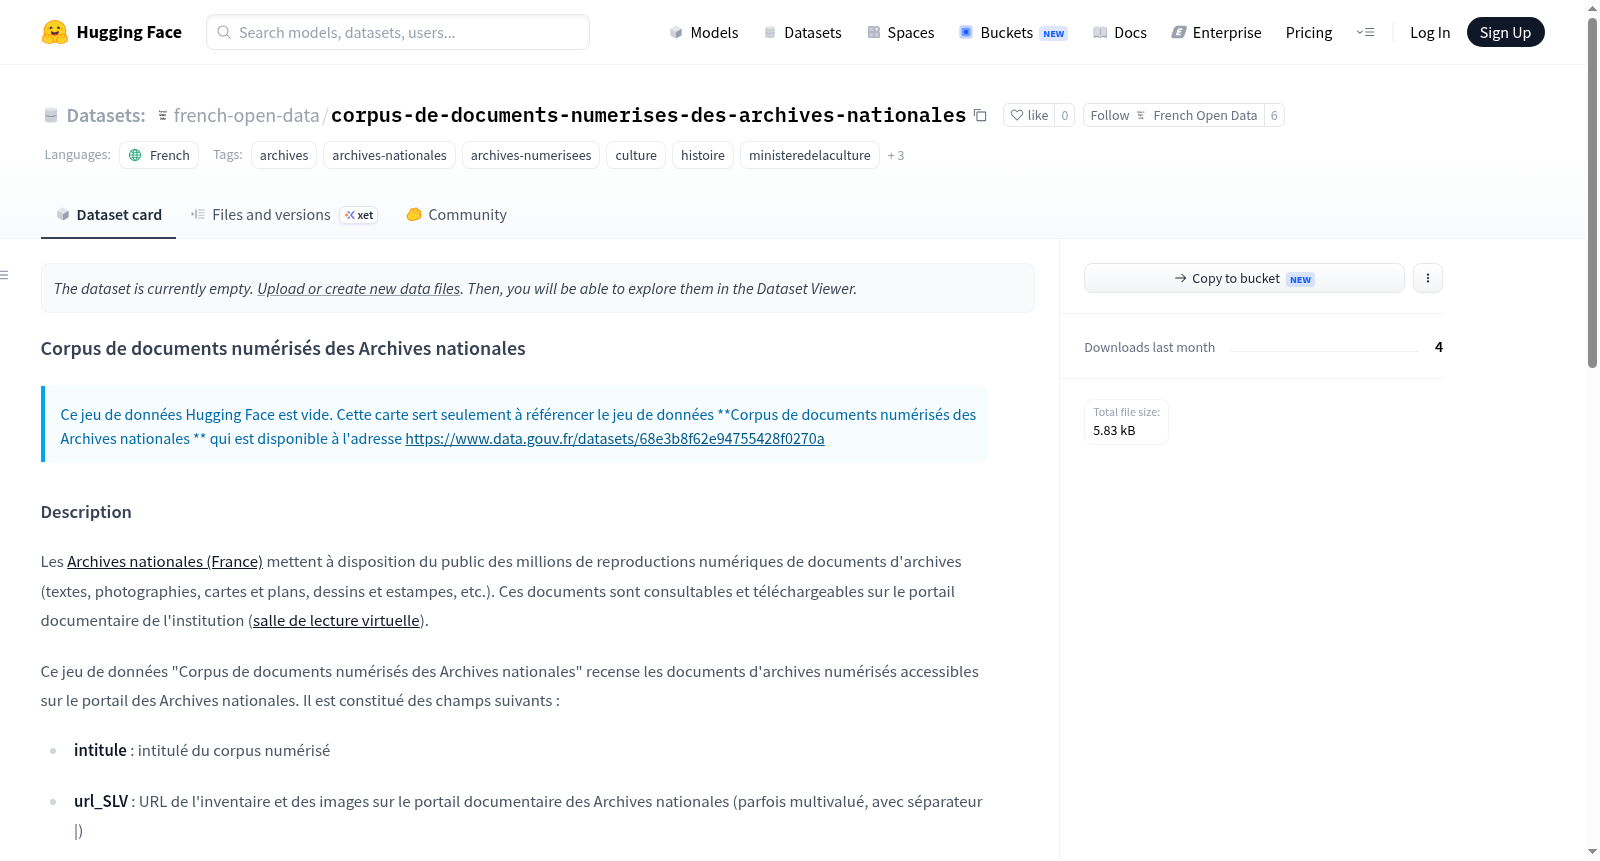
Data-Gouv-FR/corpus-de-documents-numerises-des-archives-nationales 数据集图片
构建方式
该数据集由法国国家档案馆构建,旨在系统化梳理其数字化档案资源。数据集整合了档案馆门户网站上的数字化文档元数据,涵盖了文本、照片、地图、图纸及版画等多种类型。每条记录包含16个字段,如数字化语料库标题、虚拟阅览室链接、原始载体类型、图像数量、档案编号、档案状态、文档类型、主题、地理索引、时间跨度、相关人物、XML库存文件下载链接及附注说明。数据来源于官方门户的实时整合,并计划每年进行两次更新,以纳入新增的数字化语料库。
使用方法
用户可通过数据集的数字化语料库标题或主题索引快速定位感兴趣的档案集合,再通过虚拟阅览室链接直接访问高清数字扫描件。对于需要批量处理的研究者,可利用XML库存文件链接下载结构化元数据,结合档案编号与图像数量字段进行统计分析。文档类型与时间跨度字段则有助于筛选特定形态或历史阶段的资料。需注意,私人档案可能需单独申请复制授权,公共档案则遵循开放许可协议2.0,允许自由使用与再发布。
背景与挑战
背景概述
该数据集创建于2025年10月14日,由法国国家档案馆(Archives nationales)发布,旨在汇集其数字化档案资源的元数据。核心研究问题在于如何系统性地整合与揭示数百万份涵盖文本、照片、地图、图纸等多样类型的数字化档案,以促进历史学、文化遗产保护及数字人文领域的研究。数据集收录了507条初始条目,通过结构化字段(如标题、原始载体、文档类型、主题、地理与时间索引等)提供了档案的标准化描述,为学者与公众提供了便捷的检索与利用入口。作为法国文化遗产数字化进程的重要成果,该数据集对提升档案可访问性、推动开放科学实践具有深远影响,为跨学科研究奠定了数据基础。
当前挑战
该数据集面临的领域问题核心在于如何克服档案资源异构性带来的元数据标准化挑战。不同载体(如原始彩色文档与缩微胶片)的数字化质量、多语言索引的兼容性、以及私有档案的版权限制,均增加了数据整合的复杂性。构建过程中,主要挑战包括:1)从海量混合来源中提取统一元数据,需处理多值字段(如URL、文档类型)的分隔与关联;2)确保坐标与时间索引的准确性,尤其对跨越多个世纪的档案进行精确归类;3)版权与再利用权限的明确标注(公共/私有/混合档案)需逐项审核;4)文件名命名规则的提取与XML清单的定期更新机制,以维持数据的时效性与完整性。
常用场景
经典使用场景
该数据集收录了法国国家档案馆数字化馆藏的元数据索引,涵盖文本、照片、地图、平面图、绘画与版画等多类型档案。其经典使用场景聚焦于文化遗产数字化研究领域,研究者可通过结构化字段(如档案编号、文献类型、主题、地理索引、时期及人物索引)精准检索并获取原始数字影像。该数据集为历史学、档案学与数字人文学者提供了系统化的入口,支持对法国近代以来公共与私人档案的大规模量化分析与跨文本比较研究。
解决学术问题
该数据集有效解决了传统档案研究中文献分散、元数据不统一的核心困境。通过提供标准化的数字档案清单(含503条初始记录),学术机构得以开展档案数字化进程评估、馆藏结构演变追踪以及文献类型分布的计量分析。其开放许可特性消除了版权壁垒,推动了跨机构、跨国界的协作式历史考察,尤其填补了关于法兰西第三共和国以来行政档案、私人手稿与图像资料系统性研究的学术空白。
实际应用
在实际应用层面,该数据集可作为数字人文平台的后端基础设施,支持开发智能检索工具与可视化知识图谱。文化机构、博物馆与教育部门可基于档案索引构建专题展览或在线教学资源,例如通过‘人物’字段关联家族档案,复原历史社交网络。此外,定期更新机制(每年两次)使政府统计部门与遗产管理机构能够动态监测馆藏数字化进展,优化文化遗产保护与公众开放服务策略。
数据集最近研究
最新研究方向
该数据集聚焦于法国国家档案馆数字化馆藏的元数据聚合与结构化描述,为文化遗产数字化保护与开放获取提供了标准化的资源索引。当前前沿研究方向包括:基于大规模数字化档案的多模态信息抽取与知识图谱构建,以揭示历史文档中的人物、地点与事件关联;结合自然语言处理技术对法语手写文本进行自动转录与语义标注,推动历史文献的智能检索与深度利用;以及利用该数据集训练AI代理(agent)实现档案自动分类与上下文感知推荐,助力数字人文领域的量化分析与跨库数据融合。随着2025年10月首版507条记录的发布,该数据集将成为研究法国历史脉络、公共档案开放政策及数字文化遗产可持续管理的关键基准,其半年度更新机制更确保了研究语料的时效性与扩展性。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

