ASR_TEDx_Tunisie
收藏资源简介:
TEDxTN是一个用于代码切换的突尼斯阿拉伯语-英语的三向语音翻译语料库。该数据集包含突尼斯阿拉伯方言的音频片段及其转录文本,适用于自动语音识别和翻译任务。数据集特征包括16kHz的WAV音频片段、对应的转录文本、原始YouTube视频URL以及片段的时间戳信息。数据集由Fethi Bougares等人整理,采用CC BY-NC-ND 4.0许可协议,包含训练集、验证集和测试集。
TEDxTN is a three-way speech translation corpus focused on code-switching between Tunisian Arabic and English. This dataset comprises audio clips of Tunisian Arabic dialect and their corresponding transcriptions, tailored for automatic speech recognition and machine translation tasks. The dataset features 16kHz WAV audio clips, their aligned transcriptions, original YouTube video URLs, and timestamp information for each clip. It was curated by Fethi Bougares et al., released under the CC BY-NC-ND 4.0 license, and includes training, validation, and test splits.
数据集概述
基本信息
- 数据集名称:TEDxTN
- 维护者:Fethi Bougares
- 许可协议:CC BY-NC-ND 4.0
- 主要任务类别:自动语音识别(Automatic-Speech-Recognition)
- 语言:突尼斯阿拉伯语(Tunisian Arabic)
- 标签:Tunisian, dialect, Arabic, ASR, Speech, Translation
- 数据规模:1M < n < 10M
数据集结构
配置与文件
- 默认配置名称:default
- 数据文件划分:
- 训练集:
data/train-* - 验证集:
data/validation-* - 测试集:
data/test-*
- 训练集:
特征字段
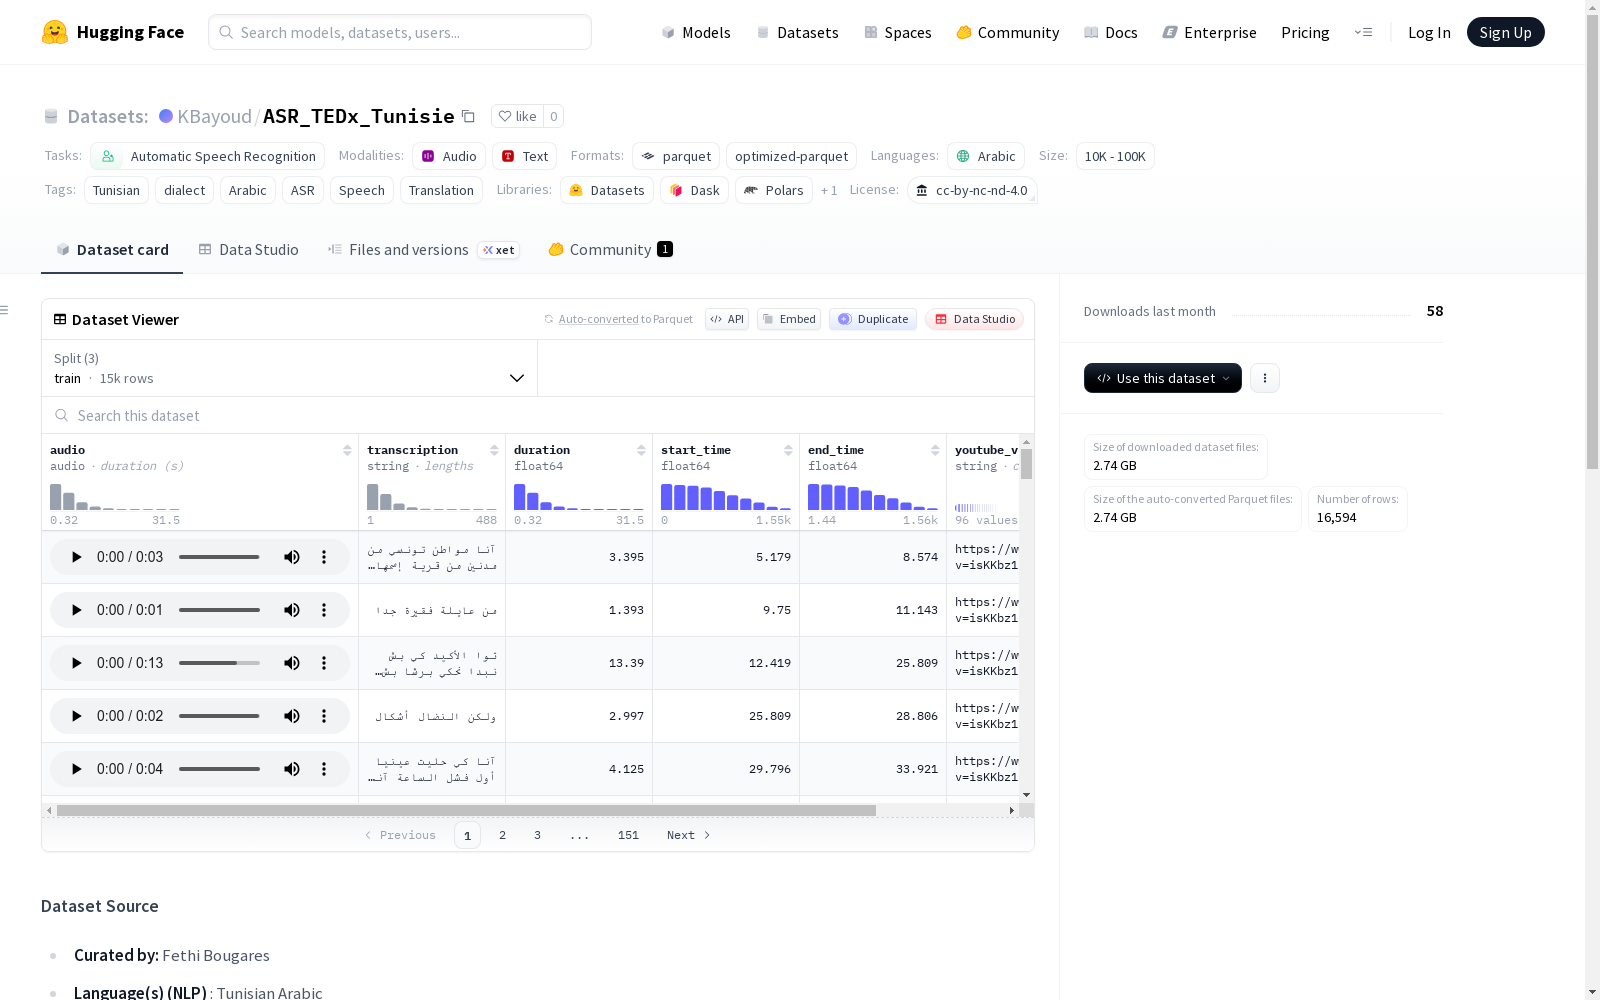
audio:音频片段,采样率为16000 Hztranscription:对应的转录文本duration:片段时长(浮点数)start_time:片段起始时间(浮点数)end_time:片段结束时间(浮点数)youtube_video:原始YouTube视频URL
数据划分统计
- 训练集:
- 样本数量:15023
- 字节大小:2425153587
- 验证集:
- 样本数量:731
- 字节大小:130598416
- 测试集:
- 样本数量:840
- 字节大小:143494811
- 总下载大小:2739037656
- 总数据集大小:2699246814
数据来源与处理
来源
- 相关论文:"TEDxTN: A Three-way Speech Translation Corpus for Code-Switched Tunisian Arabic - English"
- 作者:Fethi Bougares, Salima Mdhaffar, Haroun Elleuch, Yannick Estève
- 出版信息:Proceedings of The Third Arabic Natural Language Processing Conference, 2025年11月
- 论文链接:https://aclanthology.org/2025.arabicnlp-main.22/
- DOI:10.18653/v1/2025.arabicnlp-main.22
处理与调整
- 仅提取转录片段,跳过了
.en翻译文件。 - 为每个片段添加了YouTube视频URL。
- 标准化了音频片段文件名,以匹配YouTube视频ID和起止时间。
- 已验证音频片段可通过HuggingFace
datasets库加载。 - 保存为适用于机器学习流程的HuggingFace数据集格式。