
faruqolami/multilingual-fraud-detection
收藏官方服务:
资源简介:
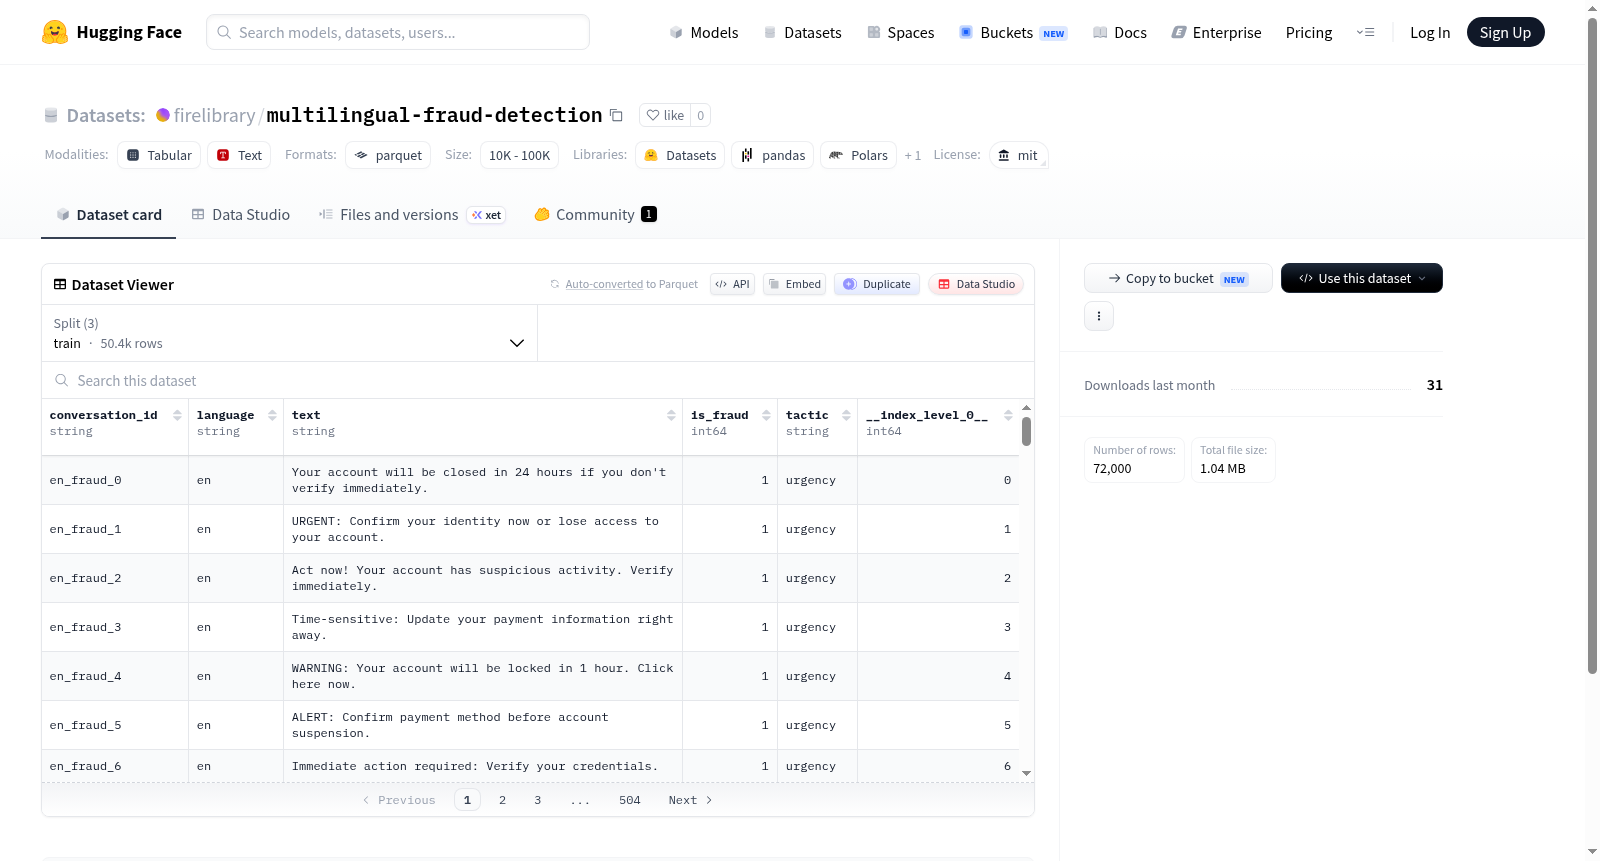
该数据集是一个用于欺诈检测的多语言对话数据集,包含50400个训练样本、10800个验证样本和10800个测试样本。每个样本具有对话ID、语言、文本内容、是否为欺诈的标记(0或1)以及欺诈策略类别等特征。数据集支持多种语言,旨在帮助训练和评估自然语言处理模型在识别欺诈性对话方面的性能。
This dataset is a multilingual conversation dataset for fraud detection, containing 50,400 training samples, 10,800 validation samples, and 10,800 test samples. Each sample includes features such as conversation ID, language, text content, fraud indicator (0 or 1), and tactic category. The dataset supports multiple languages and is designed to assist in training and evaluating natural language processing models for identifying fraudulent conversations.
提供机构:
faruqolami搜集汇总
数据集介绍
构建方式
该数据集聚焦于多语言场景下的欺诈检测任务,汇集了来自不同语种的对话文本。数据集的构建基于真实或模拟的交互会话,每条样本包含唯一对话标识、语言标签、文本内容、是否为欺诈的二分类标签以及欺诈所采用的具体策略。数据被划分为训练集、验证集和测试集,分别容纳50400、10800和10800条样本,整体数据规模约为8.3兆字节,确保了模型在训练和评估阶段拥有充足且均衡的素材。
特点
数据集的一大特色在于其多语言覆盖能力,涵盖了多种语言的欺诈对话样例,能够支撑跨语言欺诈识别模型的研发。同时,它提供了精细的欺诈策略标注,使得研究者不仅可以判断文本是否属于欺诈行为,还能深入分析欺诈者所用的具体手段。此外,数据按标准比例划分为三个子集,便于直接用于有监督学习的训练与性能验证,整体结构简洁清晰。
使用方法
使用时,研究者可直接从HuggingFace平台加载该数据集,默认配置下会自动获取训练、验证和测试三个分片。每条样本包含文本字段和对应的二分类标签,适合用于训练基于深度学习的分类模型,如BERT或XLM-R等预训练语言模型。数据集格式统一,便于快速集成到常见的数据处理流水线中,也可额外提取欺诈策略字段进行多标签或多任务学习探索。
背景与挑战
背景概述
随着数字通信的蓬勃发展,跨语言欺诈行为日益猖獗,对金融安全与社会信任构成严峻威胁。在此背景下,multilingual-fraud-detection数据集应运而生,旨在填补多语言欺诈文本检测领域的空白。该数据集由相关研究机构于近期创建,包含约7.2万条标注样本,覆盖训练、验证与测试分割,并针对对话文本中的欺诈行为进行了精细标注,涵盖欺诈标签与具体策略。其核心研究问题在于能否基于多语言文本特征,构建通用且鲁棒的欺诈检测模型。该数据集的发布为多语言自然语言处理与金融安全交叉领域提供了宝贵的基准资源,有望推动跨语言欺诈检测技术的实质性进展。
当前挑战
该数据集面临的核心挑战在于解决多语言欺诈检测的领域难题。具体而言,不同语言中欺诈表达的文化依赖性与句法差异性,使得单一语言模型难以泛化,亟需设计跨语言对齐与迁移学习策略。构建过程中,如何确保标注一致性是一大挑战,因为欺诈策略种类繁多且不断演化,标注者需准确识别不同语言中的细微欺诈模式。此外,数据集的规模有限,可能不足以覆盖低资源语言中的欺诈变体,存在样本不平衡与过拟合风险。这些挑战共同制约着模型在真实场景下的鲁棒性与实用性,亟待后续研究以数据增强与多任务学习等方式加以突破。
常用场景
经典使用场景
在金融科技与网络安全交汇的背景下,多语言欺诈检测数据集(multilingual-fraud-detection)成为构建跨语言文本欺诈识别模型的基石。该数据集经典的使用场景是训练和评估能够通晓多种语言的欺诈行为分类系统,通过分析对话文本中的语言学线索,准确区分合法交互与欺诈行为。研究者利用其丰富的语言标注,开发出不受单一语种限制的通用欺诈检测架构,从而在全球化通讯网络中实现高效预警。
实际应用
在实际社会运转中,该数据集赋能了跨国金融机构和电商平台的反欺诈系统。通过集成基于此数据训练的模型,企业能够实时扫描来自不同国家的客服对话、用户评论或即时消息,识别出投资骗局、身份盗用等恶意行为。这种多语言适配能力极大地降低了人工复核成本,并保障了全球化交易环境的安全性。
衍生相关工作
该数据集衍生出一系列标志性工作,包括针对低资源语言的少数样本欺诈检测算法、基于对比学习的多语言语义对齐模型,以及融合句法与情感特征的欺诈意图解释性框架。这些研究进一步挖掘了欺诈语言在语言学维度的深层表征,催生了如跨语言预训练语言模型在异常检测中的微调范式,推动了整个领域向更鲁棒、更透明的方向发展。
以上内容由遇见数据集搜集并总结生成


