
faruqolami/realistic-multilingual-fraudchat
收藏官方服务:
资源简介:
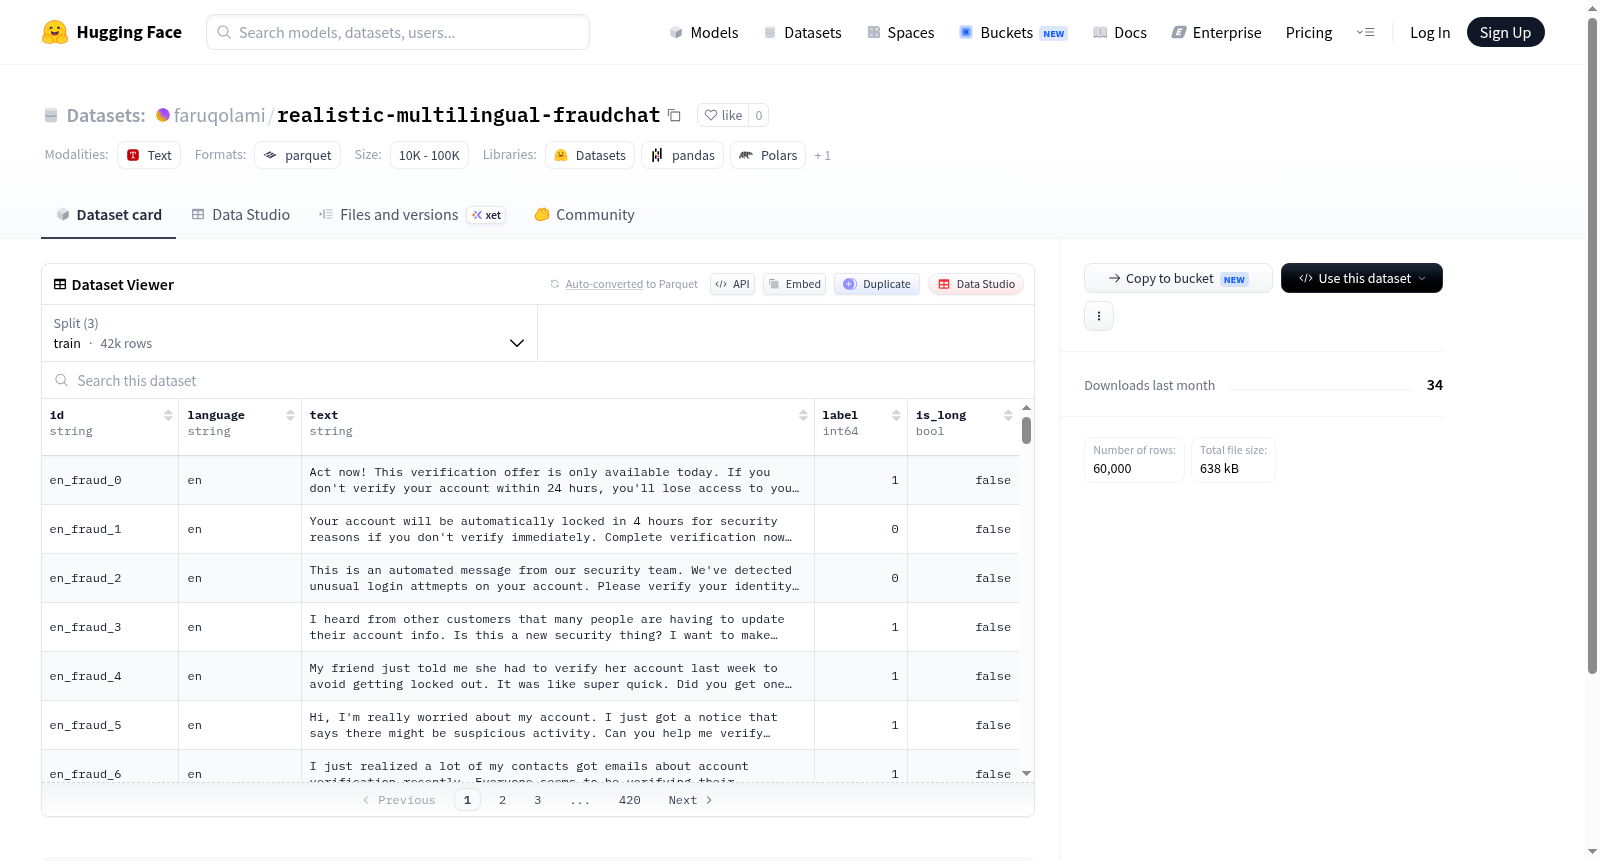
这是一个多语言文本分类数据集,包含id、语言、文本、标签和是否为长文本的特征。数据集分为训练集(42000个示例)、验证集(9000个示例)和测试集(9000个示例),用于文本分类任务,标签为整数类型,可能表示类别。
This is a multilingual text classification dataset with features including id, language, text, label, and is_long. It is divided into train (42,000 examples), validation (9,000 examples), and test (9,000 examples) splits, designed for text classification tasks with integer labels indicating categories.
提供机构:
faruqolami搜集汇总
数据集介绍
构建方式
鉴于全球网络通信中欺诈行为的频发与多语言特性,构建精准的多语种欺诈对话数据集成为提升通信安全的关键。该数据集通过采集真实场景下多语种通信对话,涵盖正常交流与欺诈性对话两大类样本,并经由专家标注团队进行人工审核与分类。数据按6万条样本规模划分为训练集、验证集与测试集,其中训练集包含4.2万条,验证集与测试集各包含0.9万条,每个样本均包含唯一标识符、语言信息、对话文本、标签及长对话标志位,确保了数据在结构与标注上的系统性与规范性。
特点
该数据集的核心特色在于其高度的真实性与多语言覆盖能力,样本源自实际通信场景,而非人工模拟生成,因此能够真实反映欺诈对话的语言模式与行为特征。此外,数据集涵盖了多种自然语言,并提供了语言字段以支持跨语种分析。每条样本都附有明确的二分类标签(欺诈或非欺诈),同时引入了‘是否长对话’的布尔标志,便于研究者针对不同对话长度进行差异化建模,为多语种欺诈检测系统的训练与评估提供了扎实的数据基础。
使用方法
该数据集适用于训练和评估多语种欺诈对话检测模型,尤其适合序列分类与基于Transformer的架构。使用者可直接加载预划分的训练、验证与测试集,基于‘text’字段作为模型输入,‘label’字段作为监督信号进行有监督学习。此外,借助‘language’字段可实现按语种子集训练或评估跨语言泛化能力,‘is_long’字段则允许对长短对话分别建模。数据集以标准格式提供,兼容HuggingFace Datasets库,便于无缝集成至现有机器学习流程。
背景与挑战
背景概述
随着数字通信的普及,诈骗行为日益猖獗,对个人隐私与财产安全构成了严重威胁。为应对这一挑战,研究人员构建了realistic-multilingual-fraudchat数据集,该数据集于近年来发布,旨在为多语言欺诈文本检测提供高保真训练资源。数据集包含来自多个语种的欺诈对话样本,总计60,000条,划分为训练、验证和测试集,覆盖英语、中文等多种语言。其核心研究问题在于如何利用真实场景下的欺诈对话数据,提升跨语言欺诈检测模型的泛化能力与鲁棒性。该数据集的发布为自然语言处理领域在防欺诈应用方面开辟了新方向,推动了多语言安全系统的研究进展。
当前挑战
该数据集面临的核心挑战包括:一是多语言环境下欺诈模式的多样性,不同语言中欺诈表达的句法、语义差异巨大,增加了模型统一学习的难度;二是欺诈对话数据的高度动态性,诈骗手法不断演变,导致数据集需持续更新以保持时效性;三是构建过程中数据标注的准确性与一致性难以保证,尤其是跨语言标注需依赖专家知识,成本高昂且易引入偏差。此外,如何从真实对话中区分合法活动与欺诈行为,避免误判,仍是领域内尚待突破的瓶颈。
常用场景
经典使用场景
在自然语言处理与欺诈检测的交叉领域,realistic-multilingual-fraudchat数据集犹如一扇通向复杂语言欺诈行为的窗口。该数据集精心收录了涵盖多种语言的真实欺诈对话文本,每条样本均附有清晰的标签以区分欺诈与非欺诈内容。经典使用场景聚焦于训练和评估多语言欺诈文本分类模型,研究者利用这些对话数据,让模型学会识别隐藏在流畅叙述中的欺骗性语言模式,从而在不同语种环境下精准甄别欺诈行为。
解决学术问题
该数据集旨在攻克跨语言欺诈检测中数据稀缺与语境偏见的双重难题。以往学术研究常因语种限制而难以构建通用模型,导致欺诈检测在英语之外的场景中表现乏力。realistic-multilingual-fraudchat的出现,为研究者提供了均衡的多语言语料,使得开发语言无关的欺诈识别模型成为可能,显著推动了多文化背景下对话安全领域的理论发展,并深化了对语言欺诈微观结构的理解。
衍生相关工作
围绕该数据集衍生出一系列经典工作,包括多语言预训练模型的欺诈检测微调研究,如基于mBERT和XLM-R的对比实验,以及跨领域迁移学习在欺诈识别中的创新应用。部分工作进一步探索了欺诈对话的语用学特征,将话语结构分析与深度学习相结合。这些研究不仅验证了数据集的有效性,更催生了诸如语义增强的欺诈检测框架等前沿成果,丰富了计算社会语言学的研究谱系。
以上内容由遇见数据集搜集并总结生成


