
cjiao/goldengoose-gumbel_combined_indoc_tau1.00-25grp
收藏官方服务:
资源简介:
--- dataset_info: features: - name: question dtype: string - name: options list: string - name: answer dtype: string splits: - name: train num_bytes: 12078940 num_examples: 3200 download_size: 9402909 dataset_size: 12078940 configs: - config_name: default data_files: - split: train path: data/train-* ---
提供机构:
cjiao搜集汇总
数据集介绍
构建方式
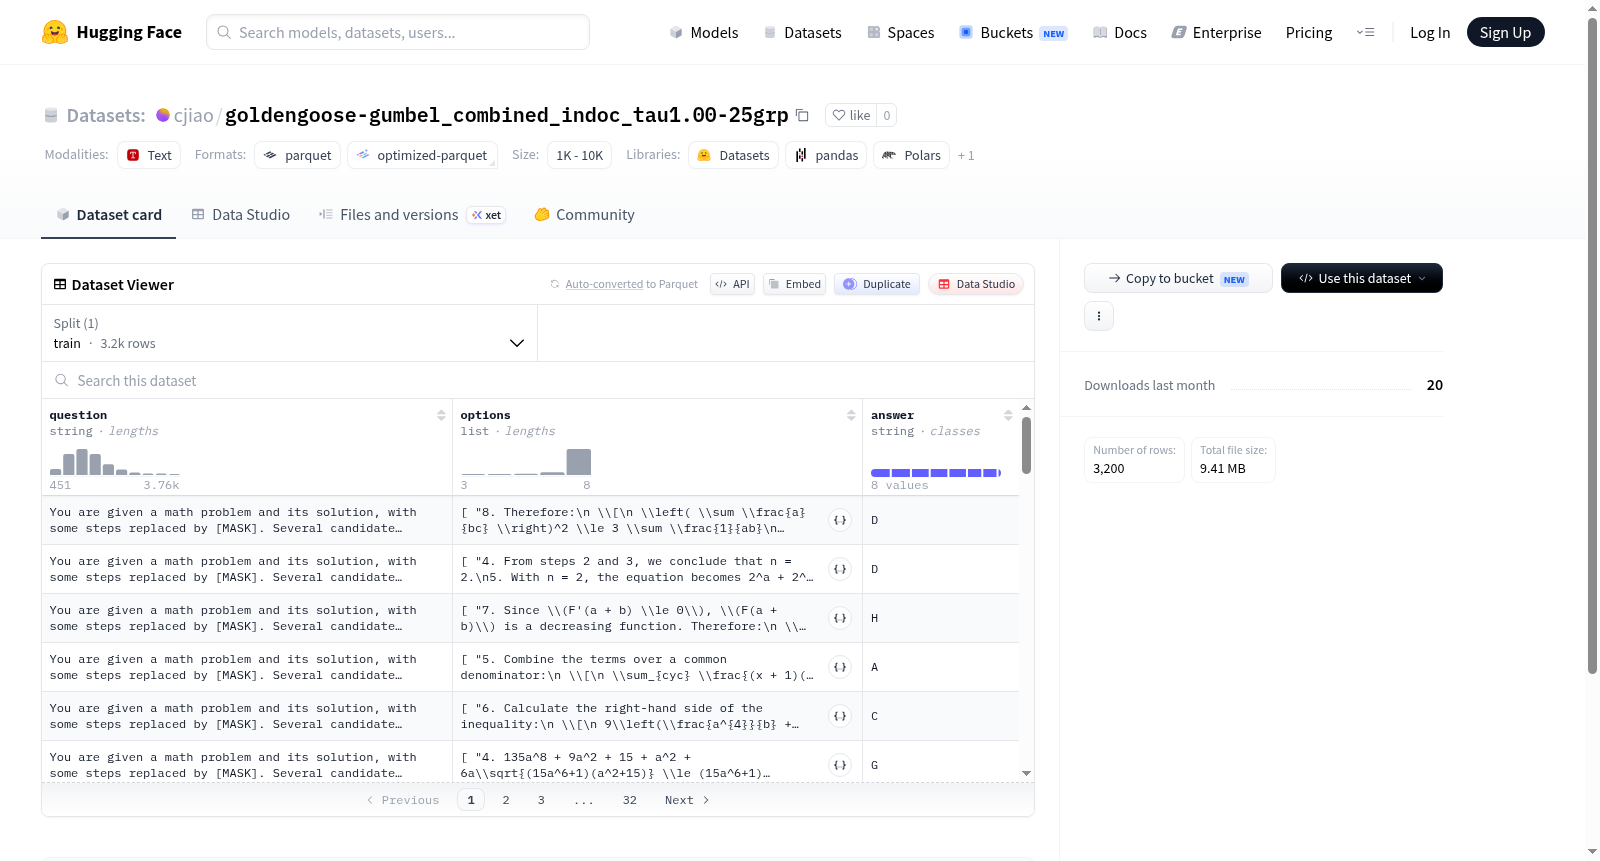
该数据集基于黄金鹅(goldengoose)框架,通过Gumbel采样策略并结合指示(In-doc)上下文信息构建而成,其中温度参数τ设为1.00,并经过25个分组的聚合处理。数据集包含3200个训练样本,每个样本由一个问题(question)、四个选项(options)和一条正确答案(answer)组成,旨在为多选问答任务提供结构化训练数据。其构建过程强调利用概率松弛技术生成多样化的候选答案,确保样本在语义覆盖上的广泛性与挑战性。
特点
数据集以紧凑的JSON格式存储,所有文本字段采用字符串类型,便于直接加载与处理。训练集规模适中(约12MB),适合中小规模模型微调与快速原型验证。通过Gumbel采样与分组控制,数据在保持内在一致性(如引用同一文档)的同时引入了随机扰动,模拟了真实场景中答案多样性的分布,有助于提升模型对噪声和歧义项的鲁棒性。
使用方法
用户可通过HuggingFace Datasets库一键加载该配置为default的数据集,自动读取data/目录下以train-*命名的所有文件。在训练过程中,建议将question字段作为输入,options列表作为候选集合,answer字段作为监督标签,适用于分类或排序型问答模型的微调。由于数据集仅有训练拆分,可直接用于有监督学习或作为验证集划分的素材,亦支持与同类多选数据集联合使用以增强泛化能力。
背景与挑战
背景概述
该数据集名为goldengoose-gumbel_combined_indoc_tau1.00-25grp,由未知研究团队在近期构建,旨在探索多选项问答任务中的决策机制。其核心研究问题聚焦于如何通过结构化选项组合提升模型的推理能力,尤其在涉及内部文档(indoc)关联的场景中。数据集包含3200个训练样本,每个样本由问题、选项列表和正确答案组成,为评估语言模型在有限选项下的选择精度提供了标准化测试床。尽管缺乏具体机构信息,其设计沿用Goldengoose系列对Gumbel采样的隐喻,暗示对概率性决策过程的模拟,对自然语言处理中的推理效率研究具有一定启发性。
当前挑战
数据集面临的首要挑战是领域问题的复杂性:多选项问答任务要求模型不仅理解问题语义,还需在逻辑冲突或信息缺失时做出合理抉择,这对当前基于统计分布的模型构成显著瓶颈。构建过程中,选项的生成需兼顾多样性与内部一致性,而tau参数(温度系数)的设定直接影响采样分布的陡峭程度,过小会导致选项判别失衡,过大则使模型陷入模糊度困境。此外,仅包含3200样本的小规模训练集限制了模型泛化能力,需解决少样本条件下偏差放大与过拟合的风险,这对数据高效训练策略提出额外要求。
常用场景
经典使用场景
该数据集专为多选项推理任务设计,其中每个样本包含一个自然语言问题、一组候选选项以及对应的标准答案。其经典使用场景聚焦于训练和评估语言模型在复杂语境下的选择能力,例如在机器阅读理解、常识推理或知识问答中,模型需从给定的若干选项中精准挑选出唯一正确的答案。这类任务要求模型不仅理解问题语义,还需在多个相似干扰项中进行细粒度区分,从而检验其语言理解与逻辑判断的深度融合。
解决学术问题
该数据集的核心贡献在于为学术研究中的“多选项推理”难题提供了标准化基准。它帮助研究者深入探讨模型在有限候选空间内的决策机制,尤其是在选项间存在细微语义差异或常识干扰时,如何避免模型依赖表层统计模式。通过该数据集,学术界能够系统评估模型在低资源、高区分度场景下的泛化能力,推动了对比学习、抗干扰训练等方法的创新,并揭示了传统预训练模型在复杂选择任务中的潜在缺陷,进而促进更鲁棒的推理框架的设计。
衍生相关工作
基于该数据集,研究者衍生出多项经典工作,包括探索提示工程对选项排序的敏感性、设计基于对比损失的多选项微调策略,以及开发用于评估模型置信度的不确定性量化框架。部分工作进一步将其与知识图谱结合,利用结构化信息增强推理过程;还有工作引入元学习机制,使得模型能够在极少样本下快速适应新的选项空间。这些衍生研究不仅深化了对多选项任务本质的理解,也为后续构建更通用、更高效的问答系统奠定了方法论基础。
以上内容由遇见数据集搜集并总结生成


