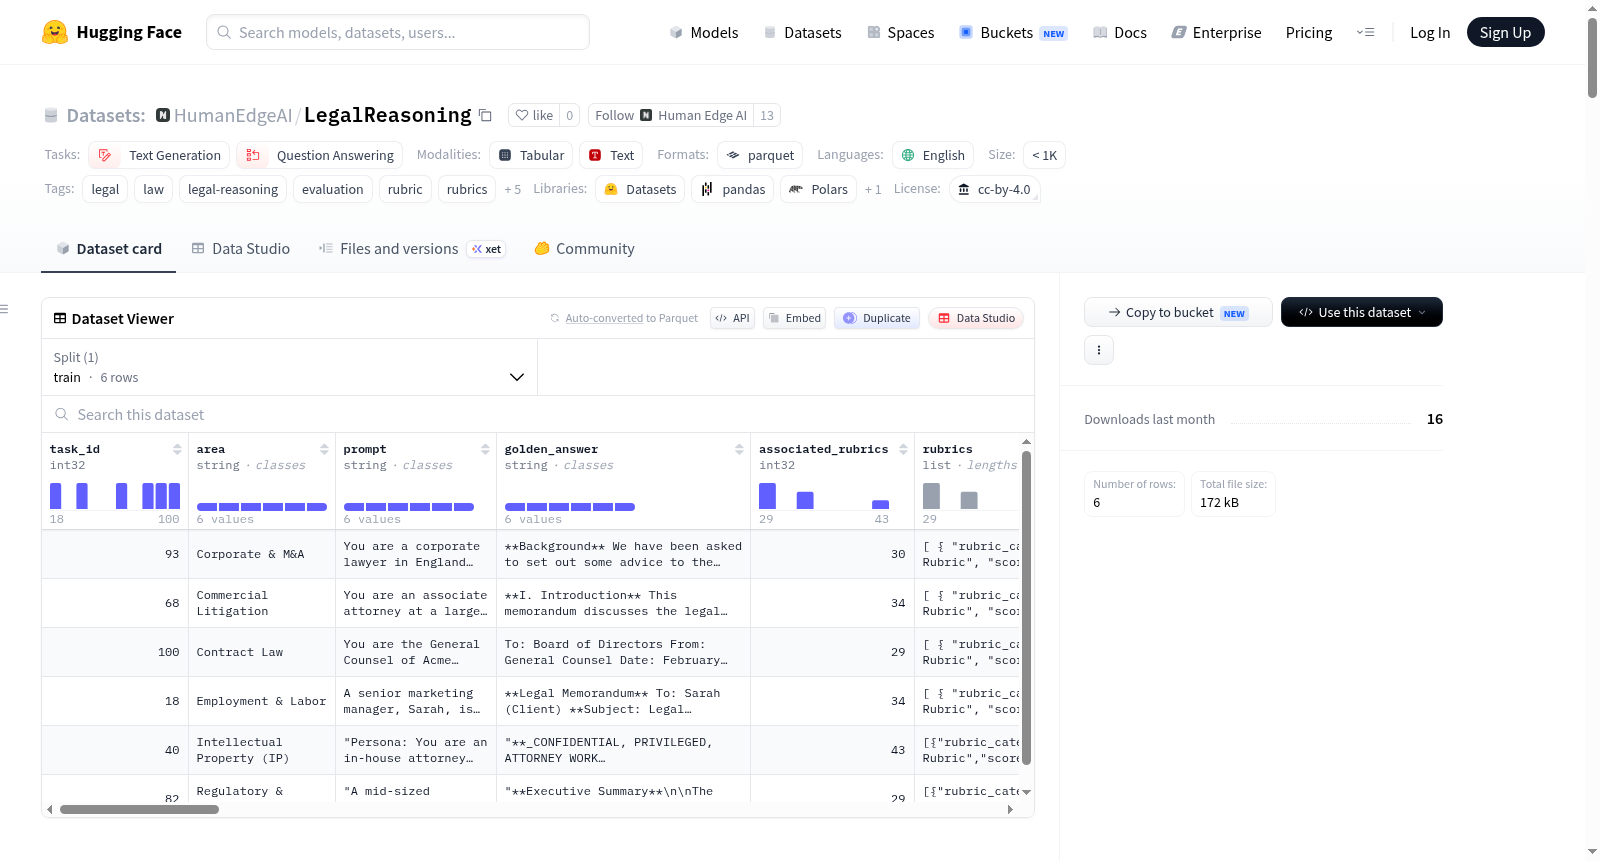
LegalReasoning
收藏资源简介:
该数据集是 Human Edge 构建的基于评分标准的法律推理评估数据集的一个展示样本,包含 6 个任务,每个任务对应一个法律子领域(如雇佣与劳动法、知识产权、商业诉讼、监管与合规、公司与并购、合同法),涵盖美国法和英国法(英格兰和威尔士)。每个任务由资深执业律师(平均约18.5年从业经验,来自AmLaw 100/Magic Circle律所、高级法院、政府或大型企业法务部)编写,并经过强制培训、自动化检查、双盲同行评审和难度验证。任务结构包含三个核心组件:法律推理提示(prompt)、专家撰写的参考答案(golden_answer)和细粒度评分标准(rubrics)。评分标准由29-43个加权二值标准组成,总权重为100分,分配在三个正向类别(实质内容65分、来源与参考文献20分、结构与风格15分)以及一个负向惩罚类别(扣分项)。每个标准都附有作者的合理性说明。每个任务还包含作者对任务真实性和难度的解释,以及两位独立评审员的质量、代表性、难度和任务规范质量评分。数据集旨在用于评估大语言模型在开放、高复杂性法律推理任务上的表现,支持基于评分标准的奖励模型训练、RLVR研究、LLM作为评判者的校准以及法律领域错误模式分析。该数据集不包含个人信息,以CC BY 4.0许可证发布。
This dataset is a sample of a rubric-based legal reasoning evaluation dataset built by Human Edge, containing 6 tasks, each corresponding to a legal subdomain (e.g., Employment & Labor Law, Intellectual Property, Commercial Litigation, Regulatory & Compliance, Corporate & M&A, Contract Law), covering US law and UK law (England and Wales). Each task is written by senior practicing lawyers (average ~18.5 years of experience, from AmLaw 100/Magic Circle firms, senior courts, government, or large corporate legal departments) and undergoes mandatory training, automated checks, double-blind peer review, and difficulty validation. The task structure includes three core components: a legal reasoning prompt, an expert-written golden answer, and fine-grained rubrics. The rubrics consist of 29-43 weighted binary criteria with a total weight of 100 points, distributed across three positive categories (Substance 65 points, Sources & References 20 points, Structure & Style 15 points) and one negative penalty category (deductions). Each criterion is accompanied by an authors rationale. Each task also includes the authors explanation of task authenticity and difficulty, as well as quality, representativeness, difficulty, and task specification quality scores from two independent reviewers. The dataset is intended to evaluate large language models on open, high-complexity legal reasoning tasks, supporting rubric-based reward model training, RLVR research, LLM-as-judge calibration, and error pattern analysis in the legal domain. The dataset does not contain personal information and is released under the CC BY 4.0 license.
数据集概述:Human Edge 法律推理评估(展示样本)
基本信息
- 数据集名称:Human Edge — Legal Reasoning Evaluation (Showcase Sample)
- 发布机构:Human Edge(humanedgetech.ai)
- 语言:英语
- 许可证:CC BY 4.0
- 规模:6 条样本(n<1K),仅含 train 分割,文件格式为 parquet
- 任务类型:文本生成、问答
- 标签:法律、法律推理、评估、评分标准、奖励模型、RLHF、专家标注、基准测试
数据集简介
该数据集是 Human Edge 构建的基于评分标准(rubric)的法律推理评估数据集的公开样本,包含 6 个任务,每个任务均由执业资深律师撰写和评审,旨在为前沿语言模型在高复杂度法律工作中的后训练和评估提供可验证的、按标准细分的奖励信号。样本涵盖 6 个法律子领域,选自更大的 50 个专家撰写任务内部语料库,管辖区为美国和英国(英格兰和威尔士)。
任务构成
每条数据包含三个核心组件:
| 组件 | 字段 | 说明 |
|---|---|---|
| 1. 法律推理提示 | prompt |
现实场景,需多步推理和专业判断,明确角色、管辖权和交付格式 |
| 2. 标准答案 | golden_answer |
专家撰写的参考分析(本样本中约 17k–38k 字符) |
| 3. 评分标准 | rubrics |
每个任务 29–43 个分类、加权、二元标准,正权重总计 100 分,附作者论证 |
评分标准设计
- 标准为二元且加权:正权重奖励必要内容,负权重惩罚特定失败模式(如幻觉权威、过度自信建议、缺失警示)。
- 每个任务的正标准总分均为 100 分,按固定比例分配:
- 实质内容(Substance):65 分,含显性要求、隐性要求、法律正确性、推理质量
- 来源与参考(Sources & References):20 分,检验引用的权威是否真实、相关且表述准确
- 结构与风格(Structure & Style):15 分,检验是否呈现专业工作成果
- 负向标准(Negative Criteria):单独扣分,不计入 100 分,可致负分
- 本样本共 199 条标准,权重分布:
+5(71)、+3(71)、+1(32)、-1(2)、-3(7)、-5(16)。 rubric_category字段存储 7 个固定类别字符串,可按类别精确筛选。
任务内容概览
| task_id | 法律子领域 | 评分标准数 | 同行评审整体质量(R1 / R2) |
|---|---|---|---|
| 18 | 雇佣与劳动 | 34 | 3 / 4 |
| 40 | 知识产权 | 43 | 4 / 4 |
| 68 | 商业诉讼 | 34 | 4 / 5 |
| 82 | 监管与合规 | 29 | 4 / 5 |
| 93 | 公司法与并购 | 30 | 4 / 4 |
| 100 | 合同法 | 29 | 4 / 5 |
质量保证
每个任务经过三重质量保障流程:
- 自动化检查:提示词和评分标准通过程序化验证,并由模型评分确认标准与标准答案一致。
- 双盲专家同行评审:两位独立资深从业者打分(整体质量、难度、代表性、任务规格质量)并提供书面论证,作者据评审意见修订。
- 难度验证:任务须经前沿模型测试,模型在相当比例标准上失败才被接纳。
数据字段
- 任务内容:
task_id、area、prompt、golden_answer、associated_rubrics、rubrics(嵌套结构)、task_details、reference_materials - 作者评论:
realistic_explanation、difficulty_explanation(不含作者自评分) - 同行评审:每位评审含
overall_quality_label、overall_quality_description、representativeness_label、difficulty_label、difficulty_description、task_specification_quality_label(评分采用 1–5 级标签,任务规格质量为分类变量)
隐私与敏感信息
数据集不含个人数据,场景基于虚构当事人和假设事实,仅引用公开判例法中的诉讼当事人姓名,作者与评审身份未公开。
预期用途
- 评估 LLM 在开放式、高复杂度法律推理上的表现
- 评分标准用于奖励机制研究:RLVR、奖励模型训练、过程监督
- LLM 作为裁判的校准研究
- 研究法律领域失败模式,尤其是来源与引用可靠性
- 为其他专业领域构建专家评分标准评估提供参考模板
不适用场景:不提供任何法律建议。 局限性:仅 6 个任务(非完整基准);评分需人工或模型评判;仅覆盖美国和英国普通法;存在数据污染风险;评审身份保密;199 条标准中有 5 条缺少论证(任务 40 中 4 条,任务 100 中 1 条)。
引用方式
数据集采用 CC BY 4.0 许可证,引用格式(BibTeX 和 APA)请参见数据集主页。许可覆盖 Human Edge 的贡献(提示词、标准答案、评分标准、评审评分),不涵盖所引用的第三方法规、条例和法院意见。
关于 Human Edge
Human Edge 专注于为 AI 开发构建专家人类数据,提供基于领域专家的评估、基准测试和专家反馈强化学习服务,覆盖金融、法律、医疗和税务等领域。此数据集为更大规模项目的试点阶段样本。