
openfoodfacts/nutriscore-object-detection
收藏官方服务:
资源简介:
该数据集用于训练Open Food Facts的Nutri-score对象检测模型,该模型已在生产环境中运行。数据集中的图像来自Open Food Facts数据库,并经过手动标注。图像数据包括图像ID、图像数据、图像的宽度和高度、元数据(如产品条形码、Open Food Facts图像编号和图像URL)以及对象检测注释(如边界框、类别ID和类别名称)。数据集的版本历史包括原始版本和改进版本,改进版本对边界框进行了更紧密的裁剪,修正了一些标注错误,并添加了模型之前失败的图像以提高未来模型版本的效果。
该数据集用于训练Open Food Facts的Nutri-score对象检测模型,该模型已在生产环境中运行。数据集中的图像来自Open Food Facts数据库,并经过手动标注。图像数据包括图像ID、图像数据、图像的宽度和高度、元数据(如产品条形码、Open Food Facts图像编号和图像URL)以及对象检测注释(如边界框、类别ID和类别名称)。数据集的版本历史包括原始版本和改进版本,改进版本对边界框进行了更紧密的裁剪,修正了一些标注错误,并添加了模型之前失败的图像以提高未来模型版本的效果。
提供机构:
openfoodfacts原始信息汇总
Open Food Facts Nutriscore detection dataset
数据集概述
- 数据集名称: Open Food Facts Nutriscore detection dataset
- 数据集用途: 用于训练Nutri-score对象检测模型,该模型在Open Food Facts的生产环境中运行。
- 数据来源: 从Open Food Facts数据库中收集并手动标注的图像。
- 许可证: Creative Commons Attribution Share Alike license (CC-BY-SA 3.0)
数据集结构
- 特征:
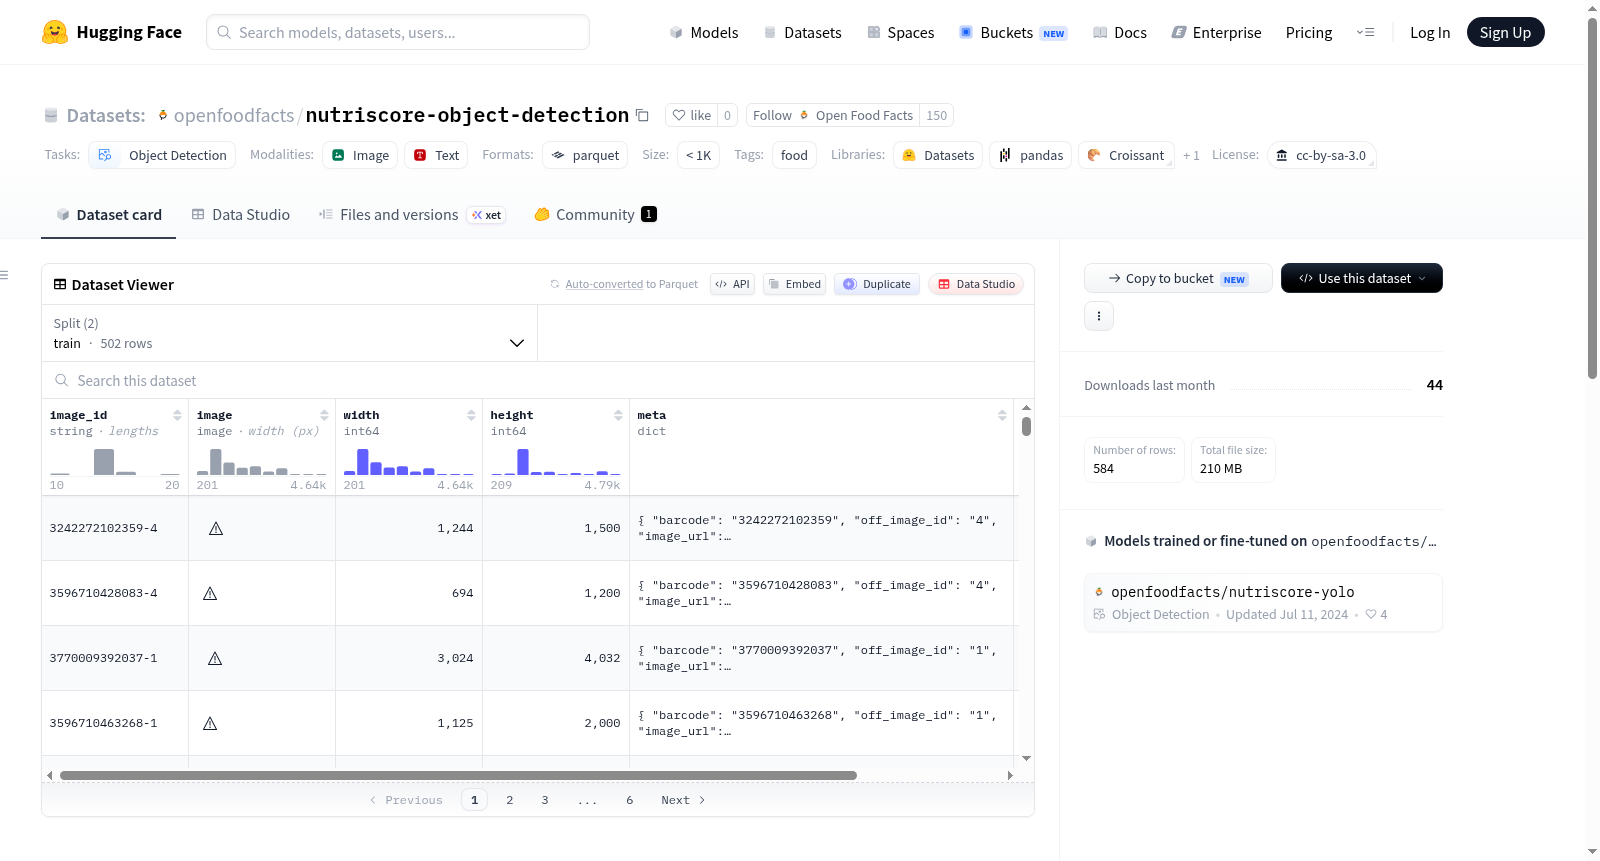
image_id: 图像的唯一标识符,由条形码和图像编号生成。image: 图像数据。width: 图像的原始宽度(像素)。height: 图像的原始高度(像素)。meta: 附加元数据。barcode: 产品条形码。off_image_id: Open Food Facts图像编号。image_url: 图像在Open Food Facts网站上的URL。
objects: 对象检测标注。bbox: 边界框列表,格式为(y_min, x_min, y_max, x_max)。坐标在0到1之间归一化,使用左上角作为原点。category_id: 类别ID列表。category_name: 类别名称列表。
数据集版本
- 1.0: 用于训练tf-nutriscore-1.0模型的原始数据。
- 2.0: 新版本的数据集,改进了原始版本:边界框更紧密地围绕Nutri-score裁剪,修正了一些标注错误,并添加了模型失败的图像以改进未来版本的模型。
数据集分割
- val:
- 样本数: 82
- 字节数: 32285921
- train:
- 样本数: 502
- 字节数: 178448483
数据集大小
- 下载大小: 352038777字节
- 数据集大小: 210734404字节
任务类别
- object-detection: 对象检测
标签
- food: 食品
数据集规模
- n<1K: 样本数小于1000
搜集汇总
数据集介绍
构建方式
在食品营养标签识别领域,精确的目标检测数据集是推动模型性能提升的关键。Open Food Facts Nutriscore Object Detection数据集源自Open Food Facts数据库中的真实产品图像,经由人工精细标注而成。图像采集自全球开源食品数据库,标注过程聚焦于Nutri-Score营养评分标签的边界框定位。数据集历经两个版本的迭代优化:v1.0版本作为初始标注数据,用于训练生产环境中的Nutri-Score检测模型;v2.0版本则对边界框进行了更紧密的裁剪,修正了部分标注错误,并补充了模型此前识别失败的困难样本,显著提升了数据质量与模型鲁棒性。
使用方法
该数据集以Hugging Face Datasets库的标准格式发布,用户可通过`load_dataset`函数直接加载使用。数据分为训练集和验证集,文件路径统一为`data/train-*`和`data/val-*`。使用时需注意边界框坐标已归一化至[0,1]区间,原点位于图像左上角。推荐配合PyTorch或TensorFlow的目标检测框架(如Detectron2、MMDetection)进行模型训练。对于需要图像预处理的场景,可结合`image_id`与`image_url`字段从Open Food Facts网站获取原始图像。数据集版本标识明确,用户可根据研究需求选择v1.0或v2.0版本进行实验。
背景与挑战
背景概述
在食品科学与公共健康领域,营养标签的自动识别成为推动消费者知情选择的关键技术。Open Food Facts Nutriscore对象检测数据集由Open Food Facts社区于2022年左右创建,旨在训练能够自动检测食品包装上Nutri-Score标签的深度学习模型。该数据集的核心研究问题聚焦于从真实世界食品图像中精准定位并识别Nutri-Score标识,以支持大规模食品营养信息的自动化提取。作为开放食品数据生态的重要组成部分,该数据集直接支撑了Open Food Facts生产环境中运行的Nutri-Score检测模型,对推动食品透明度与营养健康领域的计算机视觉应用具有显著影响力。数据集采用CC-BY-SA 3.0许可,图像源自Open Food Facts数据库并经人工标注,版本迭代至2.0后进一步提升了标注质量与模型鲁棒性。
当前挑战
该数据集所解决的领域问题在于食品图像中营养标签的精准对象检测,其核心挑战包括:Nutri-Score标签在真实包装图像中呈现多样化的尺寸、角度与光照条件,且常被文字或图形元素部分遮挡,导致模型泛化困难。在构建过程中,挑战尤为突出:原始图像需从海量众包数据中筛选,人工标注需确保边界框紧密贴合Nutri-Score区域,而不同版本间的标注一致性需通过反复校正来维持。此外,模型在特定失败案例上的表现暴露了数据分布的偏差,促使2.0版本主动补充困难样本并修正标注错误,以应对长尾分布与边缘场景的识别难题,最终实现生产环境下的可靠部署。
常用场景
经典使用场景
在食品科学与计算机视觉交叉领域,NutriScore目标检测数据集被广泛应用于训练食品包装上营养评分标签的自动识别模型。该数据集包含来自Open Food Facts数据库的584张标注图像,涵盖502张训练样本与82张验证样本,每张图像均标注了NutriScore标志的边界框坐标及其类别信息。研究者通常利用此数据集构建基于卷积神经网络的目标检测器,以精准定位并识别不同等级的营养评分标识,为食品营养信息的自动化提取提供标准化基准。
解决学术问题
该数据集有效解决了食品图像中营养标签自动检测这一学术难题,此前缺乏公开且标注规范的专用数据集限制了计算机视觉技术在食品安全与公共健康领域的深入应用。通过提供高质量边界框标注与多类别标签,它使研究者能够系统性地评估不同目标检测架构在复杂食品包装场景下的性能表现。这一资源推动了食品信息数字化研究的发展,为构建大规模食品营养数据库提供了关键技术支撑,显著提升了食品标签分析研究的可复现性与可比性。
实际应用
在实际应用中,该数据集训练的模型已部署于Open Food Facts生产环境,用于自动识别和验证消费者上传的食品图像中的NutriScore标志。这一技术可集成至移动端食品健康分析应用,帮助用户快速获取产品营养评级信息。食品监管机构也可利用此类模型自动化审查市场流通产品的标签合规性,降低人工检查成本。此外,电商平台可借此实现食品营养信息的标准化展示,提升消费者决策的透明度与便捷性。
数据集最近研究
最新研究方向
在食品科学与计算机视觉交叉领域,NutriScore目标检测数据集正推动着营养标签自动化识别的技术前沿。该数据集源自Open Food Facts全球食品数据库,专注于检测包装上的NutriScore营养标识,其2.0版本通过更紧凑的边界框标注、错误修正及困难样本补充,显著提升了模型在真实零售场景中的鲁棒性。当前研究热点集中于利用该数据集训练轻量级生产模型(如tf-nutriscore-1.0),以实现对海量食品图像的实时营养标签解析,进而支撑消费者健康决策与食品供应链的透明化监管。这一方向与欧盟食品标签法规的数字化趋势紧密呼应,为大规模营养数据采集与公共健康监测提供了可落地的技术路径。
以上内容由遇见数据集搜集并总结生成


