chess-fraud
收藏资源简介:
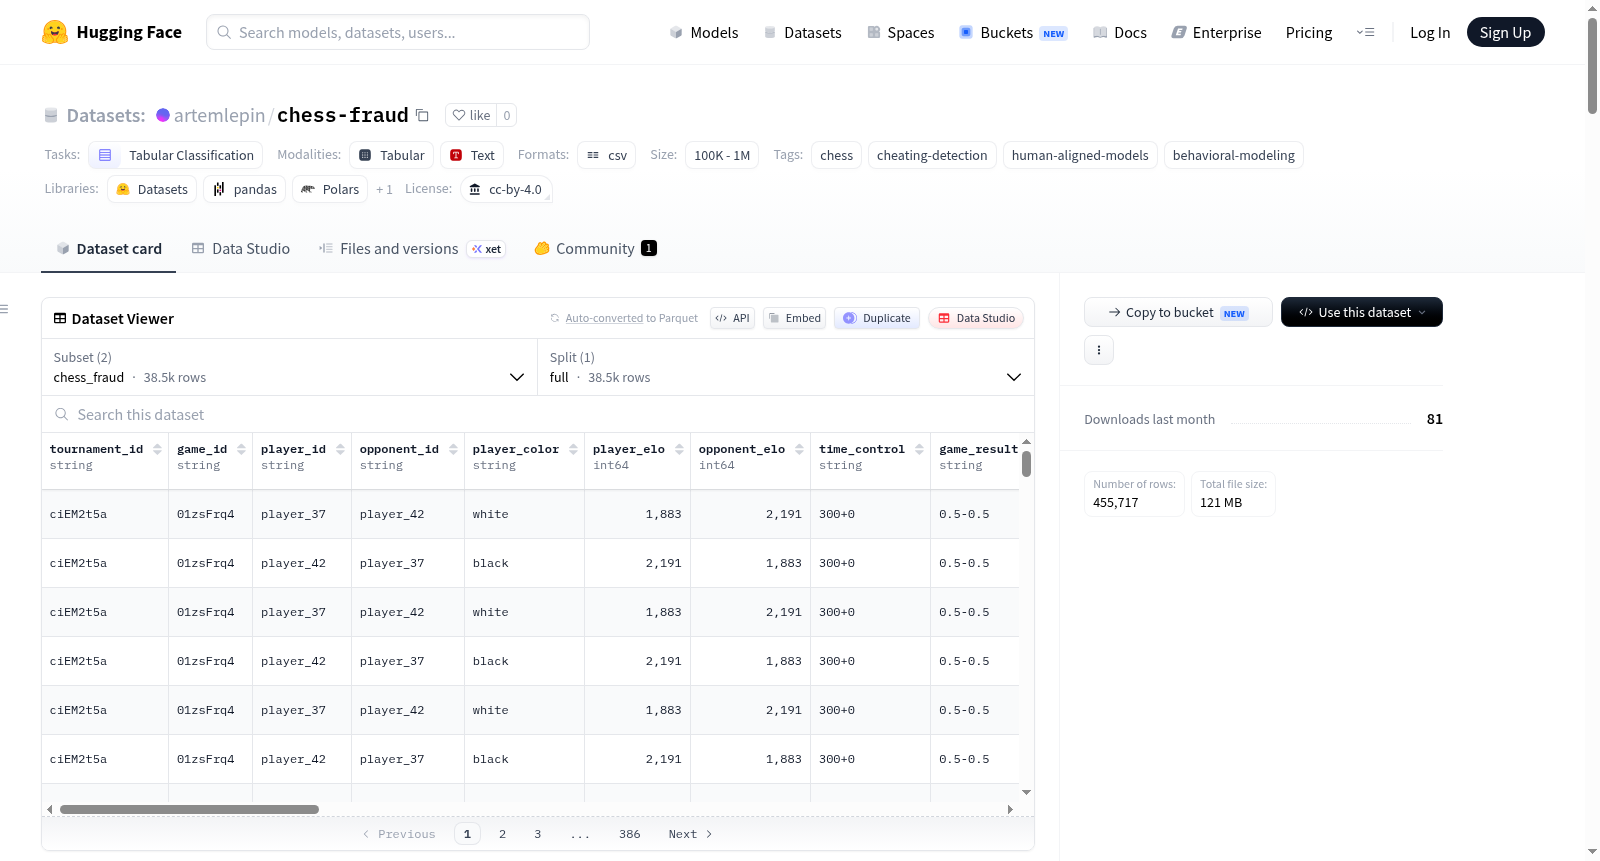
ChessFraud 是一个用于在线国际象棋作弊检测的表格基准数据集,伴随 KDD 2026 数据集与基准轨道论文《ChessFraud:探索人机对齐模型在在线国际象棋作弊检测中的能力》发布。该数据集包含两个配置: - **ChessFraud**:包含 505 场受控锦标赛对局,记录了 Stockfish 引擎请求日志以及每步棋和每玩家-对局的标签,共 38,510 行(半步棋级别),对应 1,010 个玩家-对局。 - **ChessFraud-Synth**:基于 12,000 场公开 Lichess 快棋对局生成,将人类走法与来自经典引擎和人机对齐模型的辅助走法配对,共 417,207 行(每行一对人类和辅助走法),分为训练集(334,140 行)和测试集(83,067 行),玩家和游戏在划分中不重叠。 数据字段包括:对局标识、玩家信息、Elo 等级分、时间控制、对局结果、棋盘位置(FEN 编码)、走法(UCI 编码)、思考时间、剩余时钟时间、作弊标记(走法级和玩家-对局级)、辅助来源等。ChessFraud 还包含玩家是否在赛后指控对手作弊的字段。 该数据集适用于表格分类任务,特别是基于行为建模的在线国际象棋作弊检测,以及人机对齐模型的研究。任何使用应引用论文,并注意数据集在玩家多样性、时间控制、作弊场景等方面的局限性,以及仅用于研究目的,不得用于对个体玩家进行制裁。 许可证:Creative Commons Attribution 4.0 International (CC-BY-4.0)。
ChessFraud is a tabular benchmark dataset for online chess cheating detection, released with the KDD 2026 Dataset and Benchmark Track paper ChessFraud: Exploring Human-AI Alignment Models for Online Chess Cheating Detection. It contains two configurations: ChessFraud (505 controlled tournament games, 38,510 half-move level rows, corresponding to 1,010 player-games) and ChessFraud-Synth (generated from 12,000 public Lichess blitz games, 417,207 rows, split into training and test sets). Data fields include game ID, player information, Elo rating, time control, game result, board position (FEN), move (UCI), think time, remaining clock time, cheating labels (move-level and player-game level), assistance source, etc. ChessFraud also includes a field indicating whether the player accused the opponent of cheating after the game. The dataset is suitable for tabular classification tasks, especially online chess cheating detection based on behavioral modeling, and research on human-AI alignment models.
ChessFraud 数据集详情
ChessFraud 是一个用于在线国际象棋作弊检测的表格型基准数据集,伴随 KDD 2026 数据集与基准测试赛道论文发布,论文题为 ChessFraud: Exploring the Capabilities of Human-Aligned Models for Cheating Detection in Online Chess。
数据集配置
数据集包含两个配置:
| 配置名称 | 观测单位 | 数据划分 | 行数 |
|---|---|---|---|
chess_fraud |
单个物理半步行棋(以行棋方为视角) | full |
38,510 |
chess_fraud_synth |
同一局面下的一对人类行棋与辅助行棋配对 | train, test |
417,207 |
chess_fraud包含 505 局受控锦标赛对局,共有 1,010 个玩家-对局(即每局物理对局中每个玩家的半边)。该配置为默认配置。chess_fraud_synth包含 334,140 条训练行与 83,067 条测试行,来源于 12,000 局公开的 Lichess 快棋玩家对局。训练与测试划分采用玩家不重叠的 80/20 划分:训练集含 960 名玩家和 9,600 局,测试集含 240 名玩家和 2,400 局。- 局面使用 FEN(福斯思-爱德华兹记谱法)编码,行棋使用 UCI(通用国际象棋接口)记谱法。
half_move为从 1 开始的半回合索引。
数据字段说明
ChessFraud(受控锦标赛)
核心字段包括:tournament_id、game_id、player_id、opponent_id、player_color、player_elo、opponent_elo、time_control(固定为 300+0)、game_result、half_move、move_player、position_before、position_after、move_thinking_time、clock_remaining_time、player_hint_shown、assistance_model(固定为 stockfish)、assistance_line_rank、is_cheating_move、is_cheating_player_game、player_accused_opponent、opponent_accused_player。
ChessFraud-Synth(合成辅助数据)
核心字段包括:game_id、player_id、opponent_id、player_color、player_elo、opponent_elo、rating_bin、time_control、game_result、half_move、position_before、move_player、position_after_player、move_thinking_time、clock_remaining_time、is_used(此精简版本恒为 true)、move_assistance、position_after_assistance、assistance_model。
assistance_model 的取值及其生成协议包括:
| 取值 | 生成协议 |
|---|---|
stockfish_15 |
Stockfish 在搜索深度 15 下的排名第一行棋 |
lc0_100 |
Leela Chess Zero 在 100 节点搜索预算下的排名第一行棋 |
maia1_1900 |
Maia-1 模型(针对 1900 Elo 训练)的排名第一策略行棋 |
maia2_2050 |
Maia-2 模型在将当前玩家 Elo 固定为 2050、对手 Elo 取行内 opponent_elo 时的排名第一策略行棋 |
allie_2500 |
Allie 模型基于前一步行棋与思考时间历史、当前玩家 Elo 固定为 2500、对手 Elo 取行内 opponent_elo 及行内时间控制下的排名第一策略行棋 |
数据收集与构建
- ChessFraud 数据在两次 120 分钟的竞技场锦标赛中采集,采用固定 5+0 时间控制,共 49 名独特玩家参与。引擎辅助仅通过专用的插件提供。每局中 Stockfish 搜索深度从 12、14、16、18 中均匀采样并固定。最终包含 411 个作弊玩家-对局(占 1,010 个中的 40.7%)和 9,405 个作弊半回合(占全部半回合的 24.4%)。
- ChessFraud-Synth 来源于 2025 年 3 月的公开对局,通过 Lichess 开放数据库分发。从六个 Elo 分层中各采样 200 名玩家,每人 10 局。构建流程将原始人类决策与 Stockfish、Leela Chess Zero、Maia-1、Maia-2、Allie 的候选行棋配对,并为每个符合条件的决策保留一个确定性替代。
已知局限
- ChessFraud 仅包含 49 名玩家,主要为俄罗斯本地学生,其行为分布不能代表全球在线国际象棋人群。
- ChessFraud 使用单一固定时间控制及受控的、自选的 Stockfish 辅助协议,不覆盖真实世界中跨引擎、跨界面的隐蔽作弊行为。
- ChessFraud-Synth 包含的是构造的反事实替代,而非观察到的真实作弊行为,其平衡配对设计不用于估计真实作弊率。
隐私与使用许可
- 受控锦标赛参与者均签署知情同意,数据使用假名标识,不含直接可识别的个人信息。
- ChessFraud-Synth 保留公开的 Lichess 用户名和对局标识以便溯源,因此并非匿名。合成辅助替代不表示对应玩家曾请求或使用辅助,不得用于推断个人不当行为。
- 两个数据集均以 CC-BY-4.0 许可发布;源对局由 Lichess 开放数据库以 CC0 另行分发;公开代码仓库采用 GPL-3.0。
引用信息
如使用本数据集,请引用以下论文:
bibtex @inproceedings{linich2026chess_fraud, title = {ChessFraud: Exploring the Capabilities of Human-Aligned Models for Cheating Detection in Online Chess}, author = {Linich, Anastasiia and Lepin, Artem and Sakhovskiy, Andrey and Toleutaeva, Anita and Lepa, Georgii and Neznamov, Andrei and Budennyy, Semen}, booktitle = {Proceedings of the 32nd ACM SIGKDD Conference on Knowledge Discovery and Data Mining}, year = {2026}, doi = {10.1145/3770855.3817587} }
论文链接:https://doi.org/10.1145/3770855.3817587