terminal_bench_2_a3_rl_laion_nemotron_gym_knowledge_web_search_mcqa_25_8B_20260828_183224
收藏资源简介:
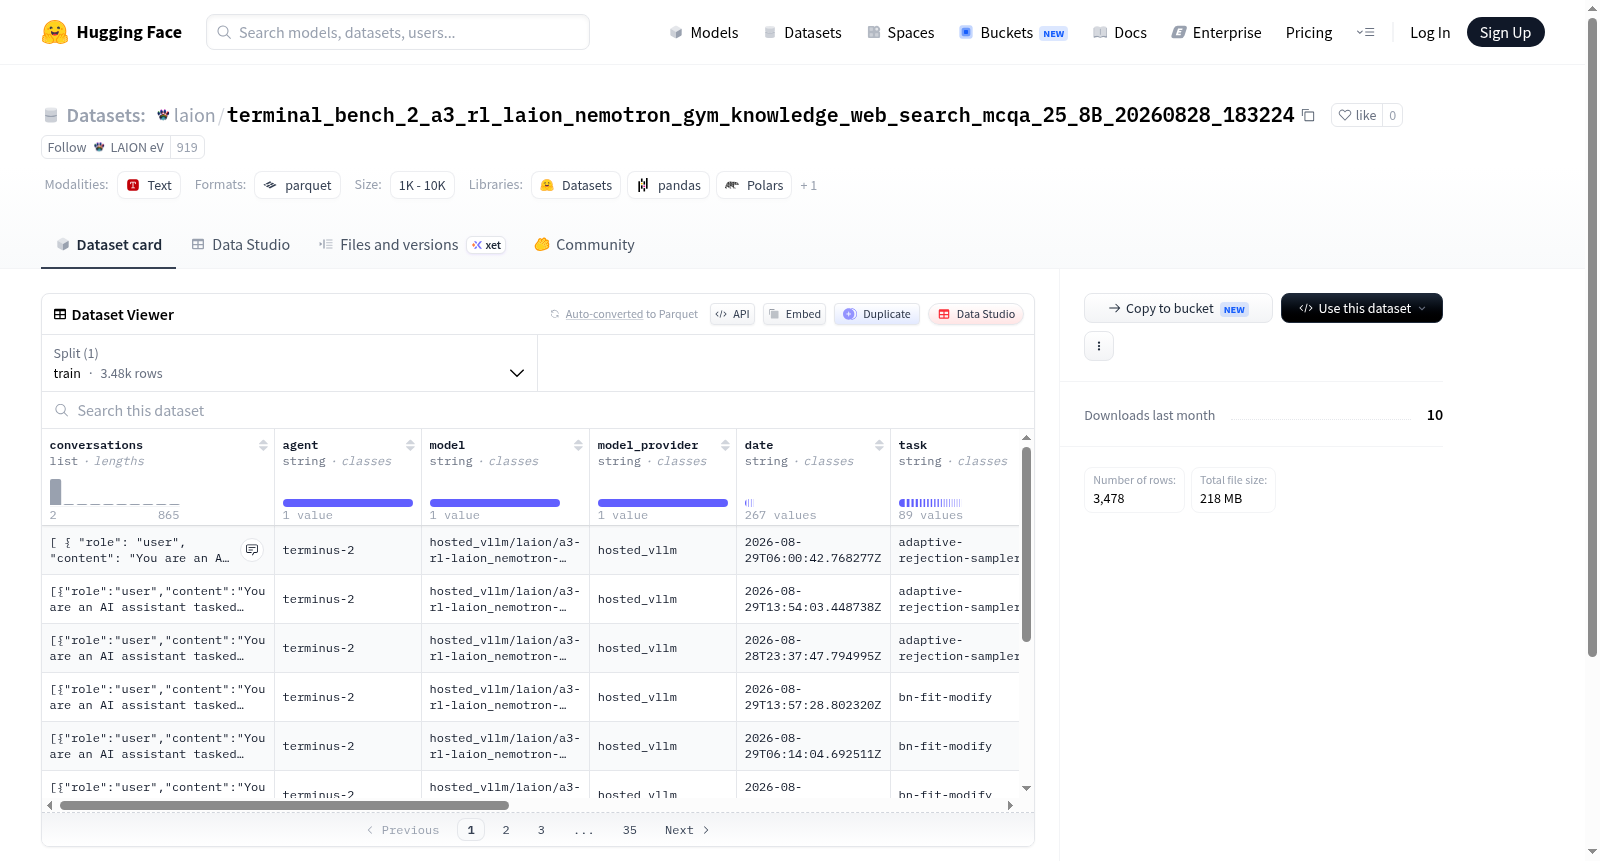
该数据集记录了AI agent与用户的多轮对话交互,包含3478个训练样本,总大小约299MB。每个样本包含完整的对话历史(conversations),其中每条消息标注了角色(role)和内容(content)。此外,每个样本还提供了agent标识、使用的模型名称(model)、模型提供商(model_provider)、对话日期(date)、任务描述(task)、episode编号、运行ID(run_id)、试验名称(trial_name)、结果(result)、验证器输出(verifier_output)以及追踪来源(trace_source)等元数据。该数据集适用于训练或评估多轮对话agent、分析模型行为、追踪agent决策过程以及验证对话系统输出质量等场景。
This dataset records multi-turn dialogue interactions between AI agents and users, containing 3,478 training samples with a total size of approximately 299 MB. Each sample includes complete conversation history (conversations), where each message is annotated with role and content. Additionally, each sample provides metadata such as agent identifier, model name used (model), model provider (model_provider), conversation date (date), task description (task), episode number, run ID (run_id), trial name (trial_name), result (result), verifier output (verifier_output), and trace source (trace_source). This dataset is suitable for training or evaluating multi-turn dialogue agents, analyzing model behavior, tracking agent decision-making processes, and verifying the output quality of dialogue systems.
数据集概述
- 数据集名称:
laion/terminal_bench_2_a3_rl_laion_nemotron_gym_knowledge_web_search_mcqa_25_8B_20260828_183224 - 数据集地址:https://huggingface.co/datasets/laion/terminal_bench_2_a3_rl_laion_nemotron_gym_knowledge_web_search_mcqa_25_8B_20260828_183224
- 数据集用途:该数据集包含终端环境下的强化学习交互数据,可能用于训练和评估具备工具使用、知识检索、网络搜索及多选问答能力的AI智能体模型。
数据特征
数据集包含以下字段:
| 字段名 | 类型 | 说明 |
|---|---|---|
conversations |
列表 | 对话记录,每个元素包含 role(角色,字符串)和 content(内容,字符串) |
agent |
字符串 | 智能体标识 |
model |
字符串 | 使用的模型名称 |
model_provider |
字符串 | 模型提供方 |
date |
字符串 | 日期信息 |
task |
字符串 | 任务类型 |
episode |
字符串 | 回合编号 |
run_id |
字符串 | 运行标识 |
trial_name |
字符串 | 试验名称 |
result |
字符串 | 结果信息 |
verifier_output |
字符串 | 验证器输出 |
trace_source |
字符串 | 轨迹来源 |
数据划分与规模
- 数据划分:仅包含
train分割 - 训练集样本数:3,478 条
- 数据集总大小:299,274,911 字节(约 299 MB)
- 下载大小:217,538,963 字节(约 217 MB)
配置文件
- 配置名称:
default - 数据文件路径:
data/train-*(对应train分割)
适用场景
该数据集适用于强化学习、智能体训练、终端交互任务、工具调用、知识问答、网络搜索及多选推理等场景的研究与模型微调。