
遇见数据集

laion/delphi-1e23-25b-stageE-rl-eval-artifacts

收藏
Hugging Face2026-07-21 更新2026-07-22 收录
官方服务:

资源简介:

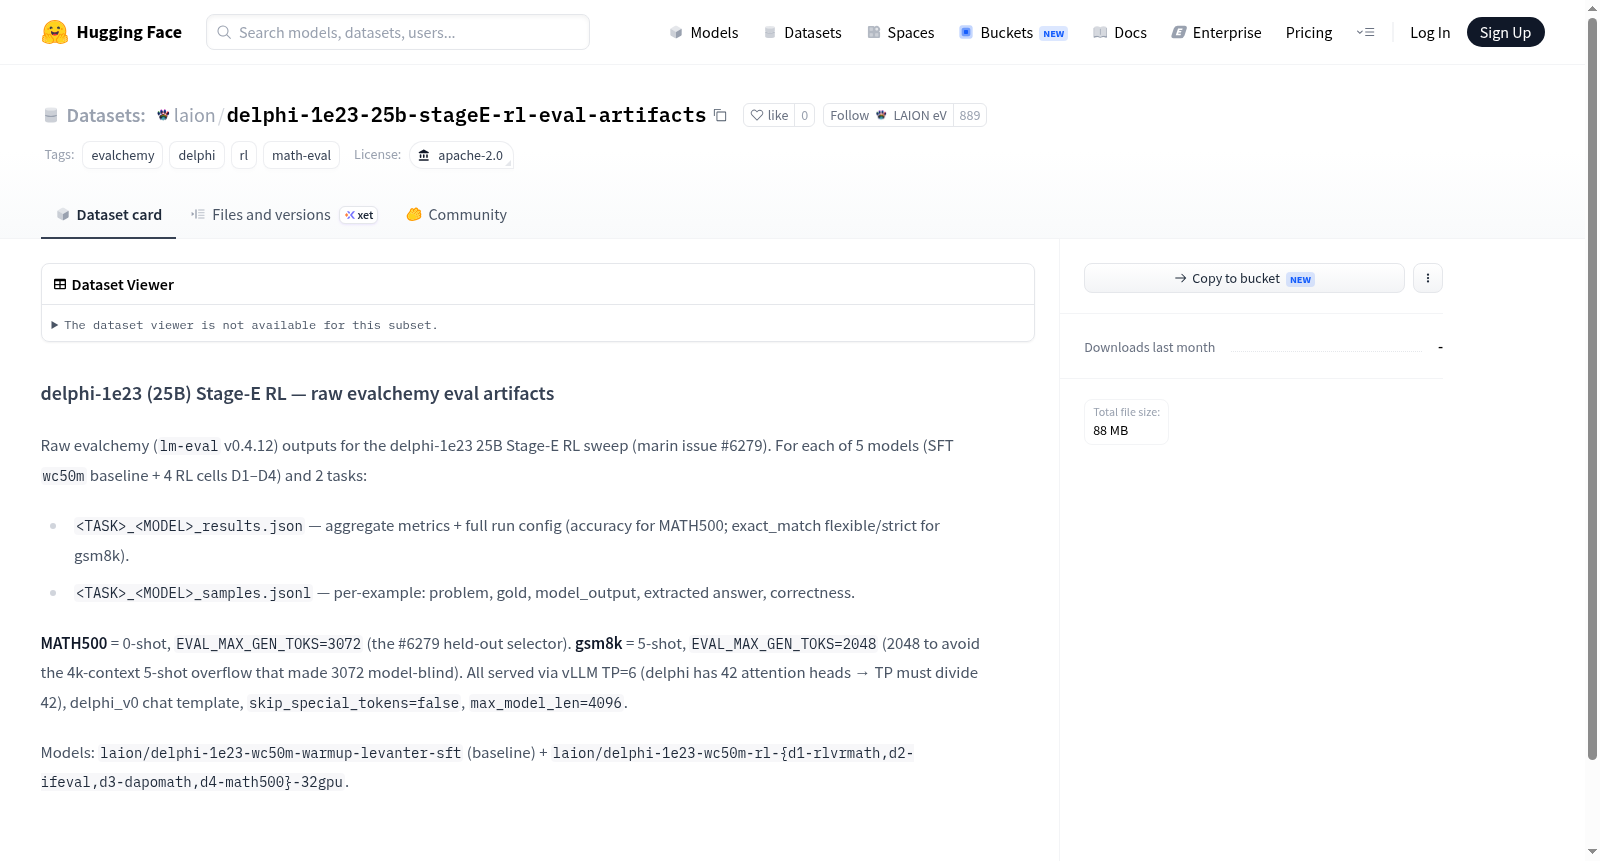
该数据集包含delphi-1e23 25B Stage-E RL扫描的原始evalchemy评估输出,用于模型性能评估。具体包括5个模型(一个SFT基线模型wc50m和四个RL单元D1-D4)在两个任务(MATH500和gsm8k)上的评估结果。文件分为结果JSON和样本JSONL:结果文件记录聚合指标和完整运行配置(如MATH500的准确率和gsm8k的灵活/严格精确匹配),样本文件提供每个示例的详细信息,如问题、标准答案、模型输出、提取答案和正确性。任务设置中,MATH500采用0-shot,最大生成标记3072;gsm8k采用5-shot,最大生成标记2048。评估通过vLLM TP=6进行,使用delphi_v0聊天模板,并指定了相关参数。模型来源于laion组织。

This dataset contains raw evalchemy evaluation outputs for the delphi-1e23 25B Stage-E RL sweep, used for model performance assessment. It includes evaluation results for 5 models (an SFT baseline wc50m and four RL cells D1–D4) on two tasks (MATH500 and gsm8k). Files consist of result JSON and sample JSONL: result files record aggregate metrics and full run configurations (e.g., accuracy for MATH500 and exact_match flexible/strict for gsm8k), while sample files provide per-example details such as problem, gold answer, model output, extracted answer, and correctness. Task settings involve MATH500 with 0-shot and a maximum generation token limit of 3072, and gsm8k with 5-shot and a limit of 2048 tokens. Evaluation is conducted via vLLM TP=6 using the delphi_v0 chat template with specified parameters. Models are sourced from the laion organization.
提供机构:
laion
搜集汇总
数据集介绍
laion/delphi-1e23-25b-stageE-rl-eval-artifacts 数据集图片
构建方式
该数据集名为delphi-1e23-25b-stageE-rl-eval-artifacts,隶属于Delphi系列大规模语言模型研发项目,聚焦于强化学习微调阶段的模型评估。其构建基于Evalchemy框架(兼容lm-eval v0.4.12),针对25B参数规模的Delphi模型在Stage-E阶段进行的强化学习扫描实验(对应marin issue #6279)。具体而言,数据集涵盖了5个模型变体:1个SFT基线(wc50m-warmup)和4个RL细胞(D1至D4,分别采用rlvrmath、ifeval、dapomath、math500策略),在MATH500与GSM8K两个数学推理任务上的原始评估产物。每个模型-任务组合产生两类文件:聚合指标与完整配置记录的JSON结果文件,以及包含每条样本问题、标准答案、模型输出、提取答案与正确性标记的JSONL样本文件。
特点
该数据集的核心特点在于其原始性与完整性,直接保留了Evalchemy评估管道的原始输出,未经过滤或二次加工,为深入分析模型行为提供了无偏数据基础。MATH500评估采用0-shot设置,最大生成长度设置为3072 token,作为该问题中保留的评估子集;而GSM8K则采用5-shot设置,最大生成长度设为2048 token,以避免因5-shot上下文过长导致4K上下文窗口溢出。所有评估均通过vLLM框架部署,采用张量并行度为6的推理配置(因Delphi模型拥有42个注意力头,TP需整除42),并统一使用delphi_v0聊天模板,设置skip_special_tokens为false,最大模型长度为4096 token。这种精细化的评估参数配置,使得数据集能够反映特定训练阶段模型在数学推理任务上的真实表现。
使用方法
使用该数据集时,研究者可直接解析各模型-任务组合下的JSON结果文件,获取MATH500的准确率与GSM8K的灵活/严格精确匹配指标,以量化评估不同强化学习策略的效果。对于需要微观分析的场景,可读取JSONL样本文件,逐条考察模型输出与标准答案的差异,深入挖掘模型在特定数学问题上的推理模式与错误类型。此外,由于数据集包含了完整的评估配置信息,使用者可再现或扩展原始评估流程,例如调整生成参数、更换评估模板或增加新的模型变体。建议结合Delphi模型的训练日志与强化学习扫描的实验记录,将评估结果与训练过程中的奖励曲线、策略更新等环节进行关联分析,从而系统理解强化学习微调对模型数学推理能力的影响机制。
背景与挑战
背景概述
delphi-1e23-25B-stageE-rl-eval-artifacts数据集是由LAION等机构的研究人员于近期创建的,专注于评估大型语言模型在数学推理任务上的强化学习(RL)微调效果。该数据集围绕delphi-1e23 25B参数模型在Stage-E RL实验中的表现,核心研究问题在于比较SFT基线模型与四种不同RL策略(D1-D4)在MATH500和GSM8K两类数学推理任务上的性能差异。作为评估工具,该数据集通过详细的零样本和少样本设置,为理解RL对数学推理能力的提升提供了标准化评估框架,对推动语言模型在数学领域的应用具有重要参考价值。
当前挑战
该数据集主要面临两方面的挑战。首先,在领域问题上,数学推理任务要求模型具备精确的数值计算与逻辑演绎能力,而现有语言模型常因生成步骤中产生微小错误导致最终答案不准确,如何通过RL训练提升模型的推理稳定性与准确性是核心难题。其次,在构建过程中,数据集需要处理不同RL策略(如d1-rlvrmath和d4-math500)的评估一致性,以及因模型架构限制(如42个注意力头需TP=6)引起的配置复杂性,同时还要确保长序列生成(如MATH500的最大生成令牌数3072)不超出上下文窗口,并避免因令牌数设置不当导致模型失效,这些均对评估流程的鲁棒性提出了挑战。
常用场景
经典使用场景
在强化学习与数学推理的交叉领域,该数据集主要用于评估大规模语言模型经过不同RL策略微调后的数学推理能力。具体而言,它覆盖了MATH500和GSM8K两项经典任务,前者为0-shot设定下的复杂数学问题求解,后者为5-shot引导下的数学应用题推理。研究者可通过该数据集系统比对基础SFT模型与多种RL变体(如RLVRMath、IFEVAL、DAPOMath、MATH500)在准确率、精确匹配等指标上的差异,从而深入分析不同RL算法对模型数学逻辑生成能力的提升效果。
衍生相关工作
基于该数据集的研究范式,已衍生出一系列关注RL策略比较与数学推理增强的经典工作。例如,后续研究利用其提供的样本级输出进行错误模式分析,归纳出RL训练对模型‘过度自信’或‘计算失误’现象的缓解规律。另有工作借鉴其多维度评估框架,将RL微调与知识蒸馏、课程学习等技术结合,探索更高效的数学推理能力训练路径。此外,该数据集的发布还推动了对大模型在数学领域‘涌现能力’的实证研究,为理论分析提供了宝贵的实验证据。
数据集最近研究
最新研究方向
该数据集聚焦于大规模语言模型在数学推理领域的强化学习(RL)训练评估,特别是对delphi-1e23模型在Stage-E阶段(RL微调)的性能进行系统性评测。前沿研究方向集中在:利用MATH500(零样本)和GSM8K(五样本)等标准化数学任务,对比监督微调(SFT)基线模型与多种RL策略(如基于奖励模型的RLVRMath、指令跟随增强IFEval、自我博弈式DPOMath及直接优化Math500)的推理能力差异。这一评估框架与当前大模型数学推理能力提升的热点事件紧密相连——如GPT-4等模型在数学竞赛中的突破表现,以及OpenAI的“过程奖励模型”(PRM)等研究方向。该数据集通过高生成长度(3072 tokens)严格区分模型盲区,并采用vLLM推理优化及42头注意力机制的特殊TP分配策略,为探索RL如何增强数学泛化与精确匹配提供了可复现的基准,对推动教育领域智能辅导、科学计算等场景的模型鲁棒性研究具有重要参考价值。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

