
遇见数据集

ardauzunoglu/smollm2_v17grpo_c4_lowq_200m2b_subsample20m_grpo_prompt

收藏
Hugging Face2026-05-26 更新2026-05-31 收录
官方服务:

资源简介:

--- dataset_info: features: - name: row_idx dtype: int64 - name: sample_idx dtype: int64 - name: text dtype: string - name: finish_reason dtype: string - name: stop_reason dtype: string - name: document dtype: string - name: prompt_token_count dtype: int64 splits: - name: train num_bytes: 352901282 num_examples: 100018 download_size: 213567221 dataset_size: 352901282 configs: - config_name: default data_files: - split: train path: data/train-* ---

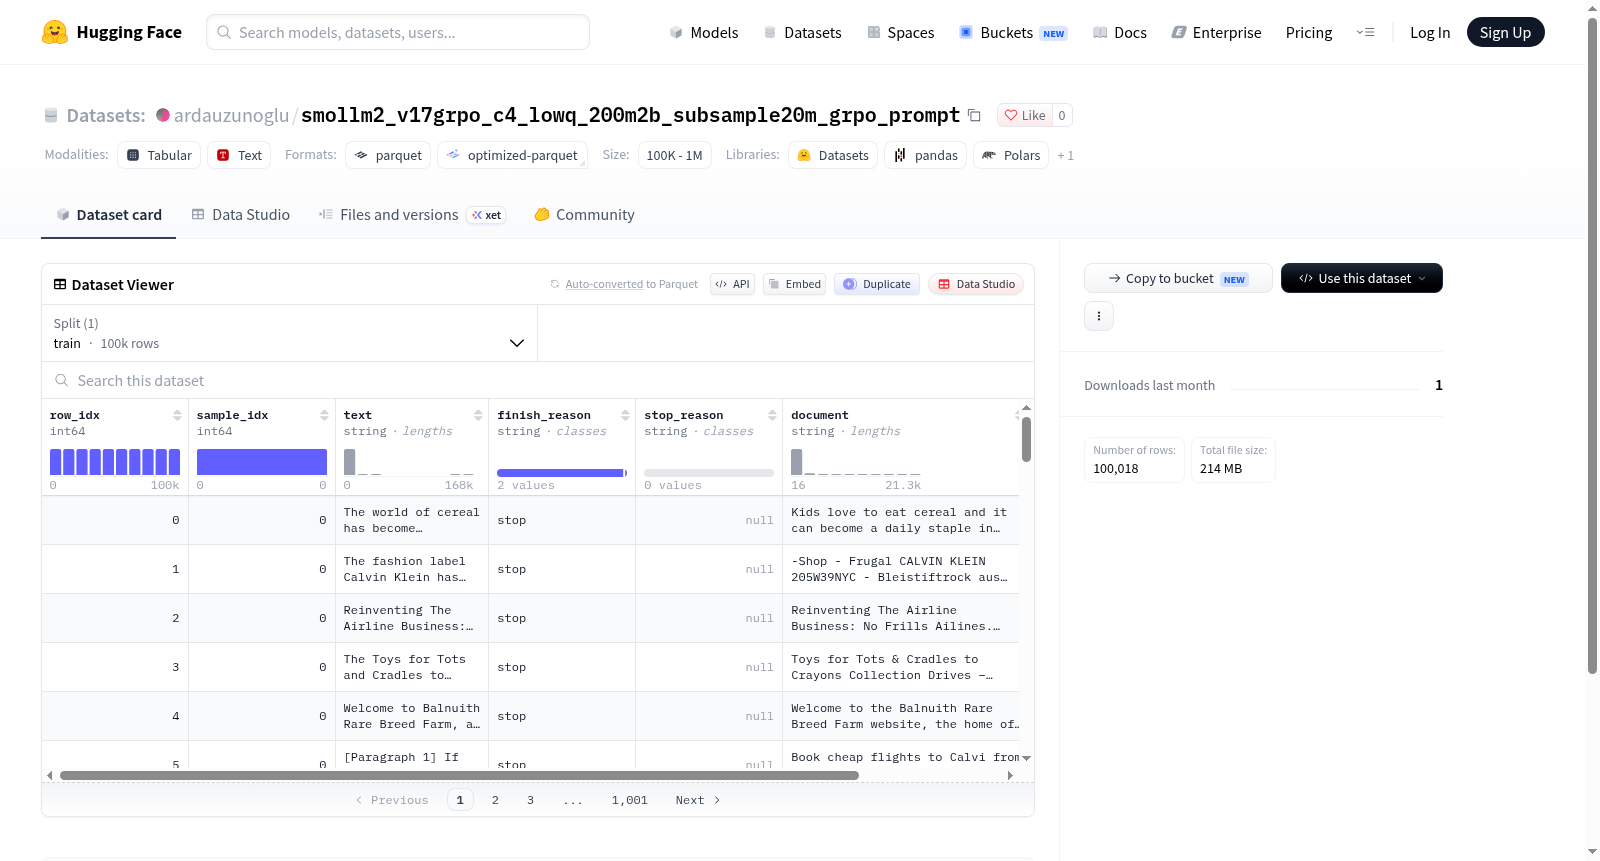
This dataset is a text processing dataset containing 100,018 training samples with a total size of approximately 352.9 MB. It features row index (row_idx), sample index (sample_idx), text content (text), finish reason (finish_reason), stop reason (stop_reason), document identifier (document), and prompt token count (prompt_token_count), suitable for text generation, analysis, or language model-related tasks.
提供机构:
ardauzunoglu
搜集汇总
数据集介绍
ardauzunoglu/smollm2_v17grpo_c4_lowq_200m2b_subsample20m_grpo_prompt 数据集图片
构建方式
该数据集的构建依托于强化学习与语言模型微调的交叉领域,采用分组相对策略优化(GRPO)对SmolLM2系列模型进行迭代训练,并以C4语料库为底层文本来源。构建过程中,首先对原始C4数据进行低质量过滤与下采样,将规模压缩至200万至20亿词元区间内的子样本,继而在GRPO提示框架下生成模型响应,最终保留约10万条训练样本,形成结构化的指令微调与偏好优化混合数据。每条样本均标注行索引、样本索引、生成文本、结束原因及提示词元计数,为后续训练与评估提供可追溯的元信息。
特点
该数据集在规模与结构上呈现出鲜明的平衡性,训练集包含100,018条样本,总字节数约352.9MB,下载体积约213.6MB,兼顾了存储效率与信息密度。数据字段涵盖文本内容、生成终止原因、提示词元计数等多维度信息,便于分析模型行为与推理成本。其核心特征在于将GRPO优化轨迹与C4低质量子样本相结合,既保留了真实语料的多样性,又通过强化学习信号注入了策略偏好,适用于研究模型在受限数据条件下的对齐与泛化能力。
使用方法
使用者可通过HuggingFace数据集接口直接加载默认配置下的训练划分,利用row_idx与sample_idx字段进行样本筛选与去重,借助text字段开展语言建模或指令微调任务。finish_reason与stop_reason字段可用于分析生成终止模式,prompt_token_count则为计算训练成本与序列长度分布提供依据。document字段保留原始文档信息,支持按文档粒度重组数据。该数据集适用于GRPO训练、奖励建模、生成质量评估及低资源场景下的模型行为分析,建议在使用前根据具体任务对文本长度与终止原因进行过滤。
背景与挑战
背景概述
在大语言模型对齐与推理能力优化的前沿探索中,强化学习与偏好优化技术已成为提升模型遵循指令与生成质量的关键路径。smollm2_v17grpo_c4_lowq_200m2b_subsample20m_grpo_prompt数据集于2024年前后由HuggingFace社区研究人员构建,依托SmolLM2系列小规模模型与GRPO(Group Relative Policy Optimization)算法,针对C4语料进行低量化采样,旨在探究小模型在有限计算资源下通过群体相对策略优化实现高效文本生成的可行性。其核心研究问题聚焦于小规模模型在强化学习微调中的样本效率与生成多样性,为轻量级模型对齐研究提供了可复用的实验基准。
当前挑战
该数据集所应对的领域问题在于小参数量语言模型在强化学习对齐过程中普遍面临的奖励稀疏与策略退化困境,即如何在仅有2亿至20亿参数规模的约束下,借助GRPO实现稳定且多样的文本生成。构建过程中的挑战尤为突出:从C4大规模语料中进行低量化子采样需在保留语言分布多样性的同时控制计算开销,采样策略直接影响后续策略优化的收敛性;生成文本的终止原因与停止原因等元信息标注需精确对齐模型解码行为,以确保强化学习信号的可追溯性;此外,10万条样本的规模虽经压缩,仍需在训练稳定性与过拟合风险之间取得平衡,这对小模型强化学习微调的数据构建范式提出了新的方法论要求。
常用场景
经典使用场景
在大规模语言模型的对齐与优化研究中,该数据集通常被用于强化学习人类反馈(RLHF)或直接偏好优化(DPO)等策略训练流程中的提示词采样与策略评估环节。其字段结构包含了原始文本、文档内容以及模型生成结束原因等元信息,支持研究者构建基于GRPO(Group Relative Policy Optimization)算法的低量化训练实验。数据集中约十万条训练样本,每条样本均带有提示词token计数,便于在有限计算资源下进行批次采样与策略梯度更新,是研究小规模模型在受限提示分布下行为演化的典型素材。
衍生相关工作
围绕该数据集,后续研究可能衍生出针对GRPO算法超参数敏感性分析的对比实验,以及基于子采样策略的数据效率研究。部分工作可能将其作为基线提示集,用于比较不同优化器在低精度训练下的收敛差异。此外,该数据集的结构设计也启发了对提示词结束原因进行分类建模的尝试,进而推动了对生成控制与策略稳定性之间关联的进一步探索。
数据集最近研究
最新研究方向
在当前大语言模型对齐与推理能力提升的研究浪潮中,该数据集聚焦于基于分组相对策略优化(GRPO)的轻量化模型微调范式,通过融合C4语料子采样与低量化训练策略,探索在有限算力条件下高效激发小规模模型推理潜能的前沿路径。其核心贡献在于将GRPO与提示词工程相结合,利用约两百万量级的子采样样本构建训练信号,推动了以SmolLM2为代表的紧凑模型在复杂推理任务中的表现边界。该方向与近期社区对低成本、高可复现对齐方法的关注高度契合,为资源受限场景下的模型优化提供了实证基础,亦对理解策略优化与数据筛选间的协同机制具有参考意义。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

